KI verstehen
Von KI- und LLM-Grundlagen bis zur aktuellen Forschung.
Kategorien: 3 · Beiträge: 30 · Begriffe: 35
Suche in „KI verstehen“. Wörter mit Leerzeichen trennen, um Beiträge zu finden, die alle Wörter enthalten.
Von dem, was Sie lesen möchten
Alle Lernthemen
Beiträge: 30 · Begriffe: 35
Grundlagen von KI und LLMs14
Verstehe Forschung, Training und Bereitstellung auch ohne KI-Vorkenntnisse. Grundlagen realer KI anhand vertrauter Beispiele.
In dieser Kategorie handelt es sich um Grundkenntnisse der realen KI. Leistung, Kosten und Anzahl der Spieltage sind Ausdrücke für das Spielmanagement. Verwandte Vorgänge finden Sie unter „Auch lesen“ für jeden Artikel.
Lesen Sie aus Abbildungen
KI, maschinelles Lernen und generative KI: was ist der Unterschied?
KI ist ein Sammelbegriff für computergestützte Erkennung, Vorhersage und Entscheidungen. Maschinelles Lernen lernt Muster aus Daten; generative KI erzeugt etwa Texte oder Bilder.
KI, maschinelles Lernen und generative KI: was ist der Unterschied?
KI ist ein Sammelbegriff für computergestützte Erkennung, Vorhersage und Entscheidungen. Maschinelles Lernen lernt Muster aus Daten; generative KI erzeugt etwa Texte oder Bilder.
KI ist ein Sammelbegriff für computergestützte Erkennung, Vorhersage und Entscheidungen. Maschinelles Lernen lernt Muster aus Daten; generative KI erzeugt etwa Texte oder Bilder.
KI, maschinelles Lernen und generative KI
Selbst für dieselbe E-Mail sind die Rollen der Kategorisierung und der Erstellung einer Antwort unterschiedlich.
Links: Sortieren nach Regeln
Sortieren Sie E-Mails nach vorgegebenen Bedingungen. KI verfügt neben dem Lernen aus Daten über weitere Mechanismen.
Mitte: Klassifikation anhand von Beispielen lernen
Nutzen Sie klassifizierte E-Mails und mehr, um Regelmäßigkeiten kennenzulernen und neue E-Mails zu klassifizieren. Dies ist ein Beispiel für maschinelles Lernen.
Rechts: Erstellen Sie eine neue Antwort
Nutzen Sie die erlernten Regelmäßigkeiten, um Sätze zu generieren, die den Anweisungen entsprechen. Dies ist ein Beispiel für generative KI.
Sowohl maschinelles Lernen als auch generative KI gehören zur KI. Maschinelles Lernen ist eine Lernmethode und generative KI ist die Bezeichnung für KI, die Inhalte erstellt. Generative KI wie LLM wird durch maschinelles Lernen erstellt.
Dies ist eine erklärende Abbildung, die durch einen Schreibtisch und Materialien ersetzt wurde.
Deep Learning ist eine Art maschinelles Lernen
Deep Learning kombiniert viele Schichten eines neuronalen Netzes und bildet etwa die Grundlage von LLMs. Nicht jede KI verwendet Deep Learning.
Sie können die Tabelle lesen, indem Sie sie nach links und rechts verschieben.
| Worte | Bedeutung | Beispiel |
|---|---|---|
| AI | Die gesamte Kunst der geistigen Arbeit. Dazu gehören auch Mechanismen, die nach festgelegten Regeln funktionieren. | Spielgegner, Bilderkennung |
| Maschinelles Lernen (ML) | Lernen Sie die Gesetzmäßigkeiten der Vorhersage und Klassifizierung anhand von Beispieldaten kennen. | Spam-E-Mail-Klassifizierung, Umsatzprognose |
| Generation KI | Generieren Sie neue Inhalte mithilfe erlernter Gesetzmäßigkeiten. | Text entwerfen, Bilder und Audio generieren |
Zum Beispiel:Gleiche E-Mail, aber unterschiedliche Rollen
„Feststellen, ob es sich um Spam handelt“ ist die Klassifizierung, und „Antworttext erstellen“ ist die Generierung. KI-Unternehmen wählen ihre Technologie basierend auf den Aufgaben aus, die ihre Kunden benötigen.
Übertragen auf AI Inc.
Denken Sie bei der Wahl eines Studienfachs nicht nur an den Namen der Technologie, sondern auch daran, welche Art von Arbeit Ihr nächstes Modell leisten soll.
Was ist ein LLM und wie erzeugt es Text?
LLM steht für großes Sprachmodell. Es lernt Sprachmuster aus umfangreichen Texten und dient etwa der Textgenerierung, Zusammenfassung und Übersetzung.
Was ist ein LLM und wie erzeugt es Text?
LLM steht für großes Sprachmodell. Es lernt Sprachmuster aus umfangreichen Texten und dient etwa der Textgenerierung, Zusammenfassung und Übersetzung.
LLM steht für großes Sprachmodell. Es lernt Sprachmuster aus umfangreichen Texten und dient etwa der Textgenerierung, Zusammenfassung und Übersetzung.
LLM: Fortsetzungen berechnen, Texte erzeugen
Berechnet den nächsten Kandidaten aus dem Kontext und fährt fort.
Kontext erhalten
Verwenden Sie Anweisungen, Fragen und zuvor generierte Inhalte.
Berechnen Sie den nächsten Vorschlag
Berechnen Sie den Kandidaten und die Wahrscheinlichkeit des nächsten Tokens.
Schreiben Sie eine Fortsetzung des Satzes
Wiederholen Sie den Vorgang der Berechnung des nächsten Tokens anhand des neu generierten Inhalts.
Ein Stück Papier ist eine Metapher für eine Wertmarke. Token sind kleine Texteinheiten, die nicht unbedingt mit Wörtern übereinstimmen. Es gibt einen Unterschied zwischen der Natürlichkeit des Textes und der Richtigkeit der Fakten.
Dies ist eine erklärende Abbildung, die durch einen Schreibtisch und Materialien ersetzt wurde.
Weiterführungsvorschläge berechnen
Es unterteilt den Text in kleine Token-Einheiten und berechnet den nächsten Token-Kandidaten und die Wahrscheinlichkeit basierend auf der Eingabe und dem bisher generierten Inhalt. Wiederholen Sie diesen Vorgang, um eine Antwort zu erstellen.
Modelle und Chat-Apps sind unterschiedlich
Das Modell ist der Teil, der die Ausgabe aus der Eingabe berechnet. Chat-Apps verwenden Modelle, die Gesprächsverlauf, Suche, Dateien, Tools und mehr kombinieren. Welche Funktionen verfügbar sind, hängt auch von der App ab.
Zum Beispiel:Denken Sie an die Fortsetzung von „Weil es regnet.“
Mögliche Fortsetzungen sind etwa „einen Regenschirm mitnehmen“ oder „den Ausflug verschieben“. LLMs berechnen kontextabhängige Fortsetzungen auch für längere Texte. Die Verarbeitung erfolgt dabei nicht unbedingt Wort für Wort.
Seien Sie vorsichtig
Auch wenn Sie natürliche Sätze schreiben können, heißt das nicht unbedingt, dass der Inhalt korrekt ist. Sie müssen das erlernte Wissen, die ausgehändigten Materialien und den Umfang der gesuchten Informationen überprüfen.
Übertragen auf AI Inc.
Das fertige Modell und das API-Produkt, das wir unseren Kunden bereitstellen, sind separate Phasen. Nach der Erstellung eines Modells ergeben sich Gründe für die Anpassung von Nutzung, Preis und Angebot.
Was sind Token und Kontextfenster?
Ein Token ist eine kleine Einheit, beispielsweise ein Satz, die das Modell verarbeitet. Das Kontextfenster stellt die Obergrenze für die Länge der Informationen dar, die in einem Prozess angezeigt werden können.
Was sind Token und Kontextfenster?
Ein Token ist eine kleine Einheit, beispielsweise ein Satz, die das Modell verarbeitet. Das Kontextfenster stellt die Obergrenze für die Länge der Informationen dar, die in einem Prozess angezeigt werden können.
Ein Token ist eine kleine Einheit, beispielsweise ein Satz, die das Modell verarbeitet. Das Kontextfenster stellt die Obergrenze für die Länge der Informationen dar, die in einem Prozess angezeigt werden können.
Kontext: Diesmal verwendete Informationen
Trennen Sie die Materialien auf Ihrem Schreibtisch von denen im Regal.
Auf dem Schreibtisch: Diesmal gegebene Informationen
Die Anweisungen, Fragen, der Gesprächsverlauf und die von der App an diesen Prozess übergebenen Materialien werden in den Kontext einbezogen.
Im Regal: Materialien, die noch nicht abgegeben wurden
Selbst wenn Sie Materialien oder frühere Gespräche gespeichert haben, können Sie möglicherweise nicht darauf zurückgreifen, es sei denn, sie wurden Ihnen dieses Mal gegeben.
Das Kontextfenster ist die maximale Länge der Informationen, die angezeigt werden können, normalerweise ausgedrückt in Token. Das Verteilen von Materialien ist vom zusätzlichen Lernen getrennt. Selbst wenn Sie ihnen lange Materialien geben, heißt das nicht, dass sie sie alle richtig verwenden können.
Dies ist eine erklärende Abbildung, die durch einen Schreibtisch und Materialien ersetzt wurde.
Entspricht nicht der Anzahl der Zeichen/Wörter
Token können Wörter, Wortteile, Zeichen usw. sein. Die Aufteilung ändert sich je nach Modell und Sprache, sodass ein japanisches Zeichen nicht immer als ein Token gezählt werden kann.
Gespräche und Materialien können auch als Referenzinformationen dienen.
Anweisungen, Gesprächsverlauf, Materialien usw., die von der App weitergegeben werden, werden in den Kontext gebracht. Eingabe- und Ausgabegrenzen werden je nach Modell unterschiedlich behandelt. Selbst wenn Sie langes Material einbinden, gibt es keine Garantie dafür, dass Sie es vollständig korrekt verwenden können.
Zum Beispiel:Bild von ausgebreiteten Materialien auf einem Schreibtisch
Der Kontext ähnelt den Materialien, die Sie auf Ihrem Schreibtisch ausbreiten, um Ihre Antwort zu formulieren. Die Materialien auf dem Schreibtisch zu haben ist eine Sache, aber mehr über das Modell selbst zu erfahren, eine andere.
Übertragen auf AI Inc.
Da die Menge der verarbeiteten Informationen zunimmt, werden sich auch die Rechen- und Speicherlasten in realen Diensten ändern. Überprüfen Sie im Spiel die Nachfrage und das Angebot, die Sie Ihren Kunden bieten möchten.
Ist das Modell besser, wenn es mehr Parameter hat?
Parameter sind numerische Werte innerhalb des Modells, die während des Trainings angepasst werden. Dies ist ein Hinweis auf den Maßstab des Modells, aber nur weil es eine große Anzahl davon gibt, heißt das nicht, dass es für den Zweck geeignet ist.
Ist das Modell besser, wenn es mehr Parameter hat?
Parameter sind numerische Werte innerhalb des Modells, die während des Trainings angepasst werden. Dies ist ein Hinweis auf den Maßstab des Modells, aber nur weil es eine große Anzahl davon gibt, heißt das nicht, dass es für den Zweck geeignet ist.
Parameter sind numerische Werte innerhalb des Modells, die während des Trainings angepasst werden. Dies ist ein Hinweis auf den Maßstab des Modells, aber nur weil es eine große Anzahl davon gibt, heißt das nicht, dass es für den Zweck geeignet ist.
Modellauswahl: Maßstab, Nutzung, Kosten
Vergleichen Sie nicht nur die Anzahl der Produkte, sondern auch die Arbeitsbedingungen, unter denen sie verwendet werden.
Links: Beim Lernen anzupassende Werte
Parameter sind numerische Werte innerhalb des Modells. Nur weil die Anzahl groß ist, heißt das nicht, dass sie für den Zweck geeignet ist.
Mitte: Überprüfen Sie die Arbeit, für die Sie es verwenden
Testen Sie es mit echten Fragen und Materialien, um sicherzustellen, dass es die von Ihnen benötigte Qualität erfüllt.
Rechts: Vergleichen Sie auch Ressourcen und Kosten
Vergleichen Sie Geschwindigkeit, Kosten, Rechen- und Speicherbelastung von Kandidaten, die die erforderliche Qualität erfüllen.
Ein Knopf ist eine Metapher für die Einstellung interner Werte. Die Anzahl der Parameter ist nicht die Anzahl der bekannten Fakten. Auch Daten, Design und Lernmethoden wirken sich auf die Ergebnisse aus.
Dies ist eine erklärende Abbildung, die durch einen Schreibtisch und Materialien ersetzt wurde.
Numerische Werte, die während des Lernens angepasst werden sollen
Parameter sind etwa die Gewichte eines neuronalen Netzes. Sie werden anhand vieler Beispiele angepasst, damit das Modell geeignete Ausgaben erzeugt. Ihre Anzahl gibt nicht die Zahl bekannter Fakten an.
Leistung, Ressourcen und Nutzung gemeinsam anzeigen
Neben der Skalierung wirken sich auch Datenqualität, Design und Lernmethoden auf die Ergebnisse aus. Große Modelle erfordern im Allgemeinen mehr Rechenressourcen und Speicher, aber auch Konfiguration und Optimierung variieren. Vergleichen wir den tatsächlichen Gebrauch.
Zum Beispiel:Kurze Klassifizierung und komplexe Satzbildung
Für die Klassifizierung kurzer Abfragen kann ein leichtgewichtiges Modell ausreichend sein. Komplexeres Schreiben erfordert möglicherweise ein höheres Maß an Fähigkeiten. Vergleichen Sie Geschwindigkeit und Kosten von Modellen, die Ihrer gewünschten Qualität entsprechen.
Übertragen auf AI Inc.
Berücksichtigen Sie beim Entwerfen eines Modells nicht nur die Vorhersageleistung, sondern auch die Trainingskosten und die Inferenzlast/-geschwindigkeit. Wir werden die Entscheidung, den Umfang zu vergrößern, mit der Entscheidung verbinden, als Unternehmen weiterzumachen.
Was unterscheidet Training und Inferenz?
Training passt die internen Werte des Modells an. Inferenz berechnet mit dem trainierten Modell eine Antwort. Auch das Beantworten von Nutzeranfragen benötigt Rechenressourcen.
Was unterscheidet Training und Inferenz?
Training passt die internen Werte des Modells an. Inferenz berechnet mit dem trainierten Modell eine Antwort. Auch das Beantworten von Nutzeranfragen benötigt Rechenressourcen.
Training passt die internen Werte des Modells an. Inferenz berechnet mit dem trainierten Modell eine Antwort. Auch das Beantworten von Nutzeranfragen benötigt Rechenressourcen.
Training und Inferenz
Sowohl bei der Erstellung als auch bei der Verwendung eines Modells sind Berechnungen erforderlich.
Lernen: Optimieren Sie das Modell
Verwenden Sie Beispieldaten, um die Zahlen innerhalb des Modells anzupassen.
Inferenz: das trainierte Modell nutzen
Geben Sie eine neue Frage usw. ein und berechnen Sie die Antwort.
Bei gewöhnlicher Inferenz bleiben die Modellparameter unverändert. Auch das Speichern von Gesprächen ist etwas anderes als Weitertraining.
Dies ist eine erklärende Abbildung, die durch einen Schreibtisch und Materialien ersetzt wurde.
Beim Training geht es darum, das Modell anhand von Beispielen anzupassen
Vergleichen Sie die Ausgabe des Beispiels mit dem Lernziel und passen Sie die internen Zahlen an. Wenn Sie den Prozess der Modellerstellung und den Prozess der Verwendung des erstellten Modells trennen, ist es einfacher, den Unterschied zwischen Ressourcen und Kosten zu verstehen.
Inferenz: eine aktuelle Anfrage beantworten
Inferenz berechnet aus der Eingabe eine Ausgabe mit den trainierten Werten. Gewöhnliche Inferenz trainiert die internen Werte nicht bei jeder Antwort neu. Gespräche oder Dokumente als aktuelle Eingabe zu nutzen ist etwas anderes als Weitertraining.
Sie können die Tabelle lesen, indem Sie sie nach links und rechts verschieben.
| Dinge zu überprüfen | Studie | Inferenz |
|---|---|---|
| der Zweck | Optimieren Sie Modellparameter anhand eines Beispiels | Berechnen Sie die Ausgabe für neue Eingaben |
| Eingabebeispiel | Beispiele für Lehrtexte, Fragen und Antworten | Benutzerfragen, Referenzmaterialien |
| interne Nummer | Aktualisieren Sie durch Lernen | Bei gewöhnlicher Inferenz nicht aktualisiert |
| Wie man Ressourcen nutzt | Berechnungen zur Erstellung und Verbesserung von Modellen | Kalkulationen zur Bearbeitung von Kundenanfragen |
Zum Beispiel:Auch nach der Erstellung fallen Betriebskosten an
Auch nach Fertigstellung eines Antwortmodells benötigt jede Nutzerfrage Inferenz. Je mehr Menschen es gleichzeitig nutzen, desto mehr Bereitstellungskapazität wird gebraucht.
Seien Sie vorsichtig
Das Speichern von Gesprächen und die Verwendung von Eingaben für zukünftiges Lernen ist eine Dienstrichtlinie, die sich von der Aktualisierung von Parametern während der aktuellen Antwort unterscheidet.
Übertragen auf AI Inc.
Rechenressourcen für Lernen und Inferenz sind getrennte Rollen. Selbst wenn das Lernen abgeschlossen ist und die Zuordnung zur Inferenz unzureichend ist, kommt es zu einem Versorgungsengpass für die Kunden.
Was ist Pre-Learning und Fine-Tuning?
Beim Vortraining werden grundlegende Regelmäßigkeiten aus einer Vielzahl von Daten gelernt, bei der Feinabstimmung wird das trainierte Modell mit zusätzlichen Daten angepasst.
Was ist Pre-Learning und Fine-Tuning?
Beim Vortraining werden grundlegende Regelmäßigkeiten aus einer Vielzahl von Daten gelernt, bei der Feinabstimmung wird das trainierte Modell mit zusätzlichen Daten angepasst.
Beim Vortraining werden grundlegende Regelmäßigkeiten aus einer Vielzahl von Daten gelernt, bei der Feinabstimmung wird das trainierte Modell mit zusätzlichen Daten angepasst.
Vorlernen und zusätzliches Lernen
Erstellen Sie ein Fundament und passen Sie es an die Aufgabe an, für die Sie es verwenden möchten.
Links: Grundsteinlegung anhand vielfältiger Beispiele
Lernen Sie Grundregeln anhand vieler Sätze. Dabei handelt es sich um den Prozess der Anpassung der numerischen Werte innerhalb des Modells.
Rechts: Passen Sie mit einem Beispiel an, das zu Ihrem Zweck passt
Nutzen Sie das trainierte Modell als Ausgangspunkt und lernen Sie zusätzlich anhand von Beispielen, die zu Ihrem Job und Ausgabeformat passen. Durch die Feinabstimmung werden interne Werte aktualisiert.
Das Anfordern oder Weitergeben von Material durch RAG ist vom zusätzlichen Lernen getrennt. Prüfen Sie, ob sich das Lernen verbessert hat, indem Sie Beispiele verwenden, die nicht zum Lernen verwendet wurden.
Dies ist eine erklärende Abbildung, die durch einen Schreibtisch und Materialien ersetzt wurde.
Schaffen Sie eine Grundlage mit vorausschauendem Lernen
Viele Sprachmodelle lernen die Regelmäßigkeiten von Wörtern, indem sie eine Vielzahl von Aufgaben lösen, beispielsweise die Fortsetzung eines Satzes vorhersagen. Durch die Verwendung einer vorab trainierten Grundlage ist es nicht erforderlich, jedes Mal ein Modell von Grund auf neu zu erstellen.
Durch Weitertraining an den Einsatz anpassen
Beispiele für Fragen und gewünschte Antworten erleichtern die Befolgung von Anweisungen oder passen sie an bestimmte Aufgaben und Ausgabeformate an. Das Erlernen, auf Anweisungen zu reagieren und die Bewertungen anderer zu nutzen, gehört zum Post-Training nach dem Pre-Learning.
Zum Beispiel:Passen Sie das Klassifizierungsformat von Anfragen an
Zusätzliches Lernen kann in Betracht gezogen werden, um die Ausgabe in einem festen Format anhand von Abfragesätzen und Klassifizierungsbeispielen für „Abrechnung“, „Vertrag“ und „Betrieb“ zu erleichtern. Überprüfen Sie, ob die Verbesserungen anhand von Beispielen vorgenommen wurden, die nicht zum Lernen verwendet wurden.
Seien Sie vorsichtig
Zusätzliches Lernen unterscheidet sich von RAG, das nach Materialien sucht. Es ist keine Methode der Wahl, um sicherzustellen, dass sich neue Fakten merken.
Übertragen auf AI Inc.
Die abgeleitete Entwicklung unter Verwendung eines übergeordneten Modells führt zu der Idee, das vorhandene Fundament zu nutzen. Bitte lesen Sie den Zielbestätigungsbildschirm für die Leistungs- und Kostenbedingungen, die im Spiel übernommen werden sollen.
Sollte ich einfach die Menge der Trainingsdaten erhöhen?
Daten benötigen nicht nur Quantität, sondern auch Genauigkeit, Vielfalt und Nutzungsnähe. Ein Zustand, in dem das System nur bei Beispielen, die es während des Trainings gesehen hat, stark und bei neuen Beispielen schwach ist, wird als „Überanpassung“ bezeichnet.
Daten benötigen nicht nur Quantität, sondern auch Genauigkeit, Vielfalt und Nutzungsnähe. Ein Zustand, in dem das System nur bei Beispielen, die es während des Trainings gesehen hat, stark und bei neuen Beispielen schwach ist, wird als „Überanpassung“ bezeichnet.
Lerndaten: Quantität, Qualität, Überprüfung
Fügen Sie nicht einfach weitere Beispiele hinzu, sondern bereinigen Sie sie und vergleichen Sie sie mit anderen Beispielen.
Anzahl: Gibt es nur ähnliche Exemplare?
Selbst wenn Sie die Anzahl der Beispiele erhöhen, können Sie bei vielen Überschneidungen oder Voreingenommenheiten die Situationen, in denen es verwendet wird, nicht vollständig abdecken.
Qualität: Bereiten Sie Beispiele vor, die zur Nutzungssituation passen
Überprüfen Sie Fehler und Duplikate und bereiten Sie eine breite Palette von Beispielen vor, die der tatsächlichen Frage, der Sprache und der Zielgruppe nahe kommen.
Auswertung: Überprüfen Sie anhand ungenutzter Beispiele
Trennen Sie die Teile zum Lernen, zur Überprüfung zur Anpassung und zum Abschlusstest. Sehen wir uns das anhand eines Beispiels an, das in der Studie nicht verwendet wurde.
Überanpassung ist ein Zustand, in dem das System nur bei Beispielen, die während des Trainings gesehen wurden, stark und bei neuen Beispielen schwach ist. Wir achten auf Menge, Qualität und Nähe der Daten zum Verwendungszweck.
Dies ist eine erklärende Abbildung, die durch einen Schreibtisch und Materialien ersetzt wurde.
Erstellen Sie ein Beispiel, das der Situation ähnelt, in der es verwendet werden soll
Fehler, Duplikate und verzerrte Daten können sich ebenfalls auf Ihre Ergebnisse auswirken. Entscheiden Sie, welche Art von Fragen, Sprache und Benutzern Sie erwarten, und bereiten Sie Beispiele vor, die repräsentativ für die tatsächliche Verwendung sind.
Separate Lern- und Bewertungsdaten
Wenn Sie nur die Beispiele auswerten, die Sie beim Lernen auswendig gelernt haben, wird es schwierig zu beurteilen, ob Sie mit neuem Input umgehen können. Wir unterscheiden außerdem zwischen den zur Anpassung verwendeten Verifizierungsdaten und den zur endgültigen Bestätigung verwendeten Testdaten.
Zum Beispiel:Lernen mit nur kurzen Fragen
Auch wenn Sie sich gut mit kurzen, festen Formulierungen auskennen, können Sie bei langen Beratungen oder Fragen mit unterschiedlicher Formulierung schwach sein. Wir prüfen die Daten anhand ungenutzter Daten, einschließlich tatsächlich von Benutzern verfasster Beispiele.
Übertragen auf AI Inc.
Datenlizenzierung, -wartung und -auswahl für das Lernen sind separate Phasen. Sobald Sie das Konzept der Datenqualität im wirklichen Leben verstanden haben, wird es einfacher sein, den Zweck der Wartung in Spielen zu verstehen.
Lernt das Schreiben von Eingabeaufforderungen?
Eingabeaufforderungen sind Anweisungen oder Informationen, die Sie an Ihr Modell weitergeben. Normalerweise werden die Bedingungen für die Antwort geändert, was sich vom Lernen unterscheidet, bei dem die Modellparameter aktualisiert werden.
Lernt das Schreiben von Eingabeaufforderungen?
Eingabeaufforderungen sind Anweisungen oder Informationen, die Sie an Ihr Modell weitergeben. Normalerweise werden die Bedingungen für die Antwort geändert, was sich vom Lernen unterscheidet, bei dem die Modellparameter aktualisiert werden.
Eingabeaufforderungen sind Anweisungen oder Informationen, die Sie an Ihr Modell weitergeben. Normalerweise werden die Bedingungen für die Antwort geändert, was sich vom Lernen unterscheidet, bei dem die Modellparameter aktualisiert werden.
Eingabeaufforderung: Zweck, Materialien, Ausgabeformat
Sagen Sie ihnen, was sie tun sollen, was sie verwenden sollen und wie sie reagieren sollen.
Zweck: Sagen Sie uns, was Sie wollen
Schreiben Sie die spezifische Aufgabe auf, die Sie anfordern, z. B. „Zusammenfassung des Protokolls“.
Materialien: Den Umfang der Nutzung kommunizieren
Geben Sie ihnen das Protokoll, auf das sie sich beziehen sollen, und geben Sie den Umfang des Treffens an. Sagen Sie: „Ich werde nur dieses Material verwenden.“
Format: Geben Sie das Format der Antwort an
Geben Sie das Format der Ausgabe an, z. B. „Entscheidungen in drei Aufzählungspunkten“.
Die Weitergabe von Anleitungen und Materialien erfolgt in der Regel getrennt vom weiteren Erlernen des Modells. Auch wenn die Anweisungen spezifisch sind, können dennoch Fehler auftreten. Vergleichen Sie Ihre Antworten daher mit den Materialien.
Dies ist eine erklärende Abbildung, die durch einen Schreibtisch und Materialien ersetzt wurde.
Vermitteln Sie den Zweck, die Materialien und das Ausgabeformat
Schreiben Sie detailliert, was sie tun sollen, welche Informationen sie verwenden sollen und wie sie reagieren sollen. Übergeben Sie ggf. auch ein Beispiel der gewünschten Ausgabe.
Setzen Sie das Gespräch mit den Informationen fort, auf die Sie sich beziehen.
Der Grund, warum Sie frühere Anweisungen verwenden können, liegt darin, dass die App über einen Mechanismus zur Übergabe dieser Anweisungen an das Modell verfügt. Die bloße Fähigkeit, neue Informationen während eines Gesprächs nutzen zu können, bedeutet nicht, dass das Modell dauerhaft gelernt hat.
Zum Beispiel:Machen Sie Ihre „Zusammenfassung“ konkret
Kommunizieren Sie den Zweck, den Umfang und das Format, z. B. „Bitte nutzen Sie ausschließlich das folgende Protokoll und listen Sie die Entscheidungen in drei Aufzählungspunkten auf.“ „Bitte füllen Sie nichts aus, was nicht im Dokument enthalten ist.“
Seien Sie vorsichtig
Detaillierte Anweisungen können hilfreich sein, garantieren jedoch nicht, dass sie fehlerfrei sind. Lassen Sie uns die Ausgabe mit dem tatsächlichen Material vergleichen.
Übertragen auf AI Inc.
Modellentwurf und Trainingsstart im Spiel unterscheiden sich vom Schreiben eines Prompts in einem echten Chat. Das Speichern eines Entwurfs allein verursacht weder Kosten noch Fortschritt des Haupttrainings.
RAG und Einbettungen: Unterschied zum Weitertraining?
RAG sucht benötigte Unterlagen und übergibt sie dem Modell für die Generierung. Diese Quellen werden getrennt von den Modellparametern verwaltet.
RAG und Einbettungen: Unterschied zum Weitertraining?
RAG sucht benötigte Unterlagen und übergibt sie dem Modell für die Generierung. Diese Quellen werden getrennt von den Modellparametern verwaltet.
RAG sucht benötigte Unterlagen und übergibt sie dem Modell für die Generierung. Diese Quellen werden getrennt von den Modellparametern verwaltet.
RAG: erst suchen, dann antworten
Übergeben Sie das abgerufene Material zur Beantwortung an das Modell.
Suchen Sie nach verwandten Materialien
Suchen Sie in den Handbüchern, die Ihrer Frage entsprechen, nach dem Teil, das Sie benötigen.
Geben Sie die Frage weiter
Übergeben Sie das gefundene Material als Referenzinformationen in der Antwort an das Modell.
Antworten Sie unter Bezugnahme auf die Materialien
Das Modell generiert eine Antwort. Überprüfen Sie außerdem, ob das Material Ihre Antwort unterstützt.
Die Übergabe von Materialien und das Erlernen zusätzlicher Modelle sind zwei verschiedene Dinge. RAG allein übernimmt keine Gewähr für die Richtigkeit, da das Material alt sein kann oder die Antworten vom Material abweichen können.
Dies ist eine erklärende Abbildung, die durch einen Schreibtisch und Materialien ersetzt wurde.
Suchen → Materialien abgeben → Antworten
Suchen Sie nach unternehmensinternen Handbüchern, die sich auf Ihre Frage beziehen, und geben Sie die relevanten Teile zusammen mit Ihrer Frage weiter. Es ist nicht erforderlich, das gesamte Modell neu zu trainieren, um auf die aktualisierte Dokumentation zu verweisen.
Suchen Sie durch Einbetten nach ähnlichen Inhalten
Beim Einbetten handelt es sich um eine Methode, Merkmale wie Sätze als Zahlenfolge auszudrücken. Diese Nähe können Sie für Ihre Suche nutzen. RAG bietet auch Stichwortsuchen und eine Kombination aus beidem an.
Unterschiede in der Art und Weise, wie Informationen verwendet werden
Am Beispiel der Anfrageantwort trennen wir die Informationen, die dieses Mal weitergegeben werden müssen, und die Zahlen, die während des Lernens angepasst werden müssen.
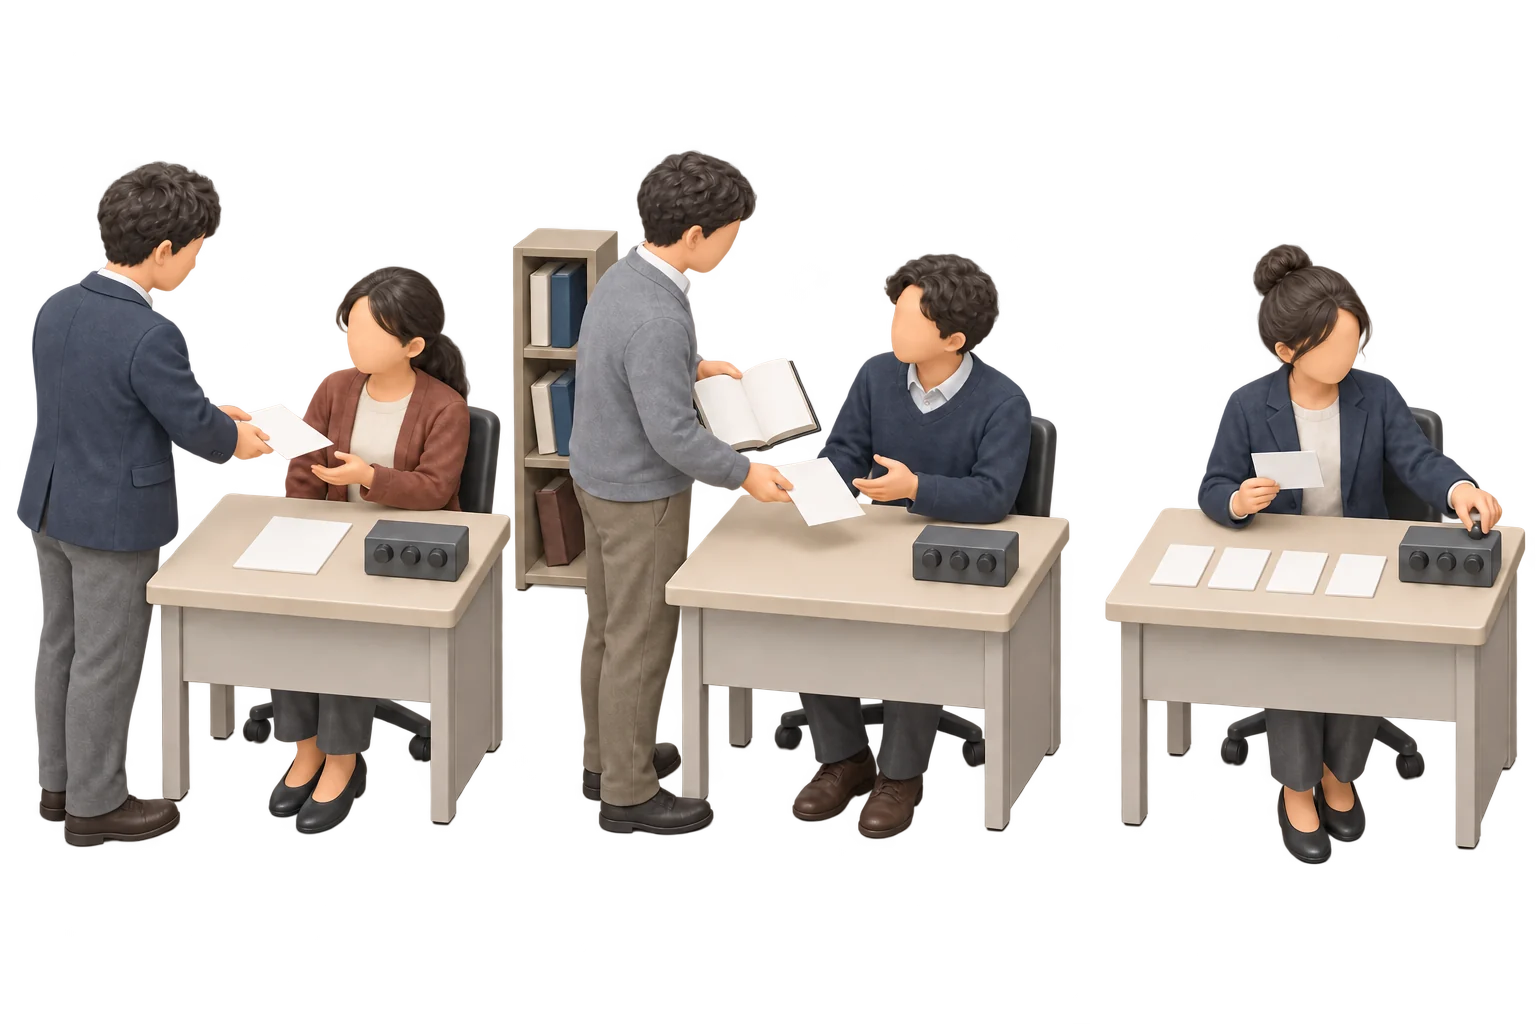
Links: Eingabeaufforderung
Geben Sie ihnen Anweisungen und Materialien, wie zum Beispiel „Formulieren Sie Ihre Antworten in zwei Sätzen.“ Die übliche Antwort aktualisiert die Zahlen im Modell nicht.
Mitte: RAG
Finden Sie ein Handbuch, das zu Ihrer Frage passt, und geben Sie die erforderlichen Teile zusammen mit den Anweisungen weiter. Durch den Prozess des Suchens und Übergebens der Daten selbst werden die numerischen Werte im Modell nicht aktualisiert.
Rechts: Feinabstimmung
Passen Sie die internen Zahlen des trainierten Modells mit einer Beispielabfrage und der gewünschten Klassifizierung an. Es wird verwendet, um dem Klassifizierungsformat „Abrechnung/Vertrag/Betrieb“ zu entsprechen.
Alle drei Ansätze lassen sich kombinieren. RAG fügt gefundene Unterlagen dem Prompt hinzu. Überlege, ob aktuelle Quellen oder ein anderes Ausgabeformat benötigt werden, und teste mit echten Fragen.
Ein Knopf ist eine Metapher, die einen numerischen Wert innerhalb eines Modells darstellt. Bei den drei Szenen handelt es sich um Methodenvergleiche, nicht um Arbeitsabläufe.
Zum Beispiel:Wenn sich die Geschäftszeiten ändern
Suchen Sie nach Materialien mit neuen Öffnungszeiten und geben Sie diese als Beleg für Ihre Antwort an. Wenn Sie nach altem Material suchen, kann sogar RAG eine alte Antwort sein.
Seien Sie vorsichtig
Es ist möglich, dass Materialien verwechselt werden oder Informationen generiert werden, die nicht in den Materialien enthalten sind. Werten Sie sowohl die Suchergebnisse als auch die Ausgabe aus, um sicherzustellen, dass die Referenzen die Antwort tatsächlich unterstützen.
Übertragen auf AI Inc.
Dies ist Grundwissen für reale KI-Dienste. Dies bedeutet nicht, dass Sie RAG im Spiel individuell konfigurieren können. Dies führt zu der Idee, Modelle und Daten auszuwählen, die für den Zweck geeignet sind.
Was ist Halluzination? Warum die Antwort überprüfen?
Halluzination ist die Schaffung plausibler Inhalte, die nicht durch Fakten oder Dokumente gestützt werden können. Nicht vorhandene Informationen oder Quellen können in natürliches Schreiben eingemischt werden.
Was ist Halluzination? Warum die Antwort überprüfen?
Halluzination ist die Schaffung plausibler Inhalte, die nicht durch Fakten oder Dokumente gestützt werden können. Nicht vorhandene Informationen oder Quellen können in natürliches Schreiben eingemischt werden.
Halluzination ist die Schaffung plausibler Inhalte, die nicht durch Fakten oder Dokumente gestützt werden können. Nicht vorhandene Informationen oder Quellen können in natürliches Schreiben eingemischt werden.
Halluzination und Bestätigung der Basis
Auch wenn die Antwort leicht zu lesen ist, öffnen Sie die Quelle und überprüfen Sie sie.
Links: Lesen Sie die natürliche Antwort
Ausführliche Erläuterungen und konkrete Dokumentennamen allein können nicht zur Feststellung einer sachlichen Stützung herangezogen werden.
Rechts: Vergleichen Sie es mit dem Original
Öffnen Sie die Quelle und prüfen Sie, ob es Teile gibt, die Ihre Antwort stützen, und ob die Zahlen, Daten und Namen der Personen übereinstimmen.
Selbst wenn eine Quelle vorhanden ist, unterstützt sie nicht unbedingt die Antwort. Wenn wir keine Beweise finden können, werden wir diese nicht als Tatsachen betrachten und andere Materialien prüfen.
Dies ist eine erklärende Abbildung, die durch einen Schreibtisch und Materialien ersetzt wurde.
Die Natürlichkeit des Textes und die Richtigkeit der Fakten sind zwei verschiedene Dinge.
LLMs berechnen zum Kontext passende Ausgaben. Selbstsicherheit und Detailfülle belegen keine Quellen. Ob Suche oder Berechnung genutzt wurde, hängt auch von der Anwendung ab.
Überprüfen Sie die Beweise, indem Sie sie tatsächlich öffnen
Überprüfen Sie relevante Teile von Dokumenten, Zahlen, Daten, Namen von Personen usw. Auch wenn ein Zitat vorhanden ist, stützt es nicht unbedingt die Antwort. Wenn Sie sagen, dass Sie es nicht wissen, werden wir es in Ihre Bewertung einbeziehen.
Zum Beispiel:Erstellen Sie einen wahrscheinlichen Dokumentnamen
Auf eine Quellenfrage kann das Modell ein nicht existierendes Handbuch nennen. Auch bei einem konkreten Titel muss das Original geprüft werden.
Seien Sie vorsichtig
Suche, RAG, zusätzliches Lernen usw. tragen zur Fehlerreduzierung bei, garantieren jedoch nicht die Richtigkeit. Selbst wenn Sie die Produktionsschwankungen reduzieren, können falsche Antworten behoben werden.
Übertragen auf AI Inc.
Bei der externen Bewertung handelt es sich um ein Material, mit dem Sie nachlesen können, was in welchem Umfang bestätigt wurde. Hohe Leistungs- und Bewertungsergebnisse allein garantieren nicht die Sicherheit für alle Anwendungen.
Wenn der Benchmark hoch ist, können Sie ihn so bereitstellen, wie er ist?
Ein Benchmark ist eine Bewertung zum Vergleich der Leistung bei einer festen Aufgabe. Ob es im konkreten Anwendungsfall des Kunden sinnvoll ist, muss gesondert geprüft werden.
Wenn der Benchmark hoch ist, können Sie ihn so bereitstellen, wie er ist?
Ein Benchmark ist eine Bewertung zum Vergleich der Leistung bei einer festen Aufgabe. Ob es im konkreten Anwendungsfall des Kunden sinnvoll ist, muss gesondert geprüft werden.
Ein Benchmark ist eine Bewertung zum Vergleich der Leistung bei einer festen Aufgabe. Ob es im konkreten Anwendungsfall des Kunden sinnvoll ist, muss gesondert geprüft werden.
Bewertung: gemeinsame Herausforderungen und praktische Anwendungen
Überprüfen Sie häufige Probleme und Arbeitsbedingungen separat.
Links: Lesen Sie die Ergebnisse gemeinsamer Herausforderungen
Vergleichen Sie die Leistung der Modelle mit denselben Fragen und Bewertungsbedingungen. Lesen Sie das Ergebnisblatt, um den Umfang der von Ihnen versuchten Aufgaben zu überprüfen.
Richtig: Probieren Sie es unter den Bedingungen des Jobs aus, den Sie verwenden werden.
Verwenden Sie tatsächliche Materialien und Fragen, um zu bestätigen, dass die erforderlichen Zahlen und Fristen eingehalten werden. Wir werden uns auch mit der Reaktionsgeschwindigkeit und den Kosten befassen.
Benchmark-Ergebnisse allein lassen nicht den Schluss zu, dass sie für irgendeine Aufgabe nützlich sind. Wir legen zunächst fest, welche Bedingungen zum Anwendungsfall des Kunden passen und prüfen diese dann auch nach Modell- und Materialwechseln.
Papier und Ordner sind Metaphern zur Beschreibung allgemeiner Aufgabenergebnisse und Bestätigungen in realen Anwendungen. Links und rechts sind nicht die Reihenfolge von Prozessen und keines von beiden garantiert Erfolg, Sicherheit oder Lieferung. Die Anzahl der Personen und Materialien spiegelt nicht die Anzahl der Tests wider.
Testen Sie unter Bedingungen, die der tatsächlichen Arbeit ähneln
Vergleichen Sie die verwendete Sprache, die verwendeten Materialien, die Länge der Fragen, das erforderliche Format usw. Fügen Sie Beispiele hinzu, die Sie in Ihrem Studium nicht verwendet haben, oder Fragen, die Sie nicht beantworten können.
Sehen Sie sich den gesamten Service an, nicht nur das Modell
Wir prüfen nicht nur die richtige Antwortrate und Begründung, sondern auch Reaktionsgeschwindigkeit, Kosten, Suchfehler, Tool-Bedienung usw. Wenn Sie sich nur die durchschnittliche Punktzahl ansehen, übersehen Sie möglicherweise Modelle, die unter bestimmten Bedingungen schwach sind.
Zum Beispiel:Auch wenn Sie gut zusammenfassen können, kann es passieren, dass Ihnen die Zahlen entgehen.
Selbst eine gut lesbare Zusammenfassung nützt nichts, wenn der Rechnungsbetrag oder die Frist fehlen. Entscheiden Sie zunächst, was bleiben muss, und bewerten Sie es unter diesen Bedingungen.
Seien Sie vorsichtig
Evaluationsergebnisse gelten für die getesteten Bedingungen und den jeweiligen Zeitpunkt. Sie garantieren nichts für ungeprüfte Einsätze. Prüfe die Ergebnisse erneut, wenn Modell oder Quellen geändert werden.
Übertragen auf AI Inc.
Dies führt dazu, dass Modellbewertung, Veröffentlichung, frühzeitige Bereitstellung und Kundenmigration getrennt beurteilt werden. Schauen wir uns die Testergebnisse zusammen mit den tatsächlichen Angebots- und Verkaufsergebnissen an.
Wie hängen GPU, Speicher und Antwortgeschwindigkeit zusammen?
LLMs führen viele Berechnungen aus und nutzen deshalb parallel arbeitende Hardware wie GPUs. Neben Rechenleistung beeinflussen Speicher, gleichzeitige Nutzung und Antwortlänge die Bereitstellung.
Wie hängen GPU, Speicher und Antwortgeschwindigkeit zusammen?
LLMs führen viele Berechnungen aus und nutzen deshalb parallel arbeitende Hardware wie GPUs. Neben Rechenleistung beeinflussen Speicher, gleichzeitige Nutzung und Antwortlänge die Bereitstellung.
LLMs führen viele Berechnungen aus und nutzen deshalb parallel arbeitende Hardware wie GPUs. Neben Rechenleistung beeinflussen Speicher, gleichzeitige Nutzung und Antwortlänge die Bereitstellung.
Inferenz: Wartezeit und Durchsatz
Eine Anfrage schnell beantworten und viele Anfragen bewältigen sind verschiedene Ziele.
Links: Wartezeit für 1 Artikel
Latenz ist die Zeit zwischen dem Senden einer Anfrage und dem Empfangen einer Antwort. Manchmal messen wir den ersten Buchstaben und die Vollständigkeit der Antwort.
Rechts: Bearbeitungsbetrag für einen bestimmten Zeitraum
Der Durchsatz ist die Anzahl der Anfragen oder Token, die in einer bestimmten Zeit verarbeitet werden können. Auch bei gleichzeitig steigender Zahl der Nutzer prüfen wir das Bearbeitungsvolumen und die Wartezeit.
Eine schnelle Antwort für eine Person sagt wenig über Lastspitzen aus. Prüfe Wartezeit und Durchsatz sowie GPU-Leistung, Speicher, gleichzeitige Nutzung und Antwortlänge.
Dies ist eine erklärende Abbildung, die durch einen Schreibtisch und Materialien ersetzt wurde.
Die Geschwindigkeit der Berechnung und die Menge der speicherbaren Informationen sind zwei verschiedene Dinge.
GPUs rechnen; der Speicher hält Modelle und Arbeitsdaten. Vergleiche Tischfläche und Arbeitstempo, um die Rollen zu verstehen. Daraus lässt sich aber keine reale Leistung berechnen.
Sehen Sie sich die Wartezeit für eine einzelne Antwort und den gesamten Bearbeitungsaufwand an
Die Latenz ist die Zeit, die benötigt wird, um auf eine Anfrage zu warten, und der Durchsatz ist die Menge, die in einer bestimmten Zeit verarbeitet werden kann. Auch die Zeit, die benötigt wird, um den ersten Buchstaben zu erhalten, und die Zeit, die benötigt wird, um die gesamte lange Antwort zu erhalten, ist unterschiedlich. Durch die Messung der gleichzeitigen Nutzung und der Antwortlänge wird es einfacher, die Bereitstellungsbedingungen zu vergleichen.
| Index | um zu sehen |
|---|---|
| Latenz | Wartezeit einer Anfrage bis zur Antwort. Zeit bis zum ersten Zeichen und bis zur vollständigen Antwort unterscheiden. |
| Durchsatz | Die Anzahl der Anfragen und Token, die in einer bestimmten Zeit verarbeitet werden können. |
| Erinnerung | Kapazität zum Speichern von Modellen und verarbeiteten Informationen. |
| kosten | Kosten für notwendige Ausrüstung und Betrieb. Variiert je nach Modell und Bereitstellungsbedingungen. |
Zum Beispiel:Allein schnell, bei Last mit Wartezeit
Die Geschwindigkeit für eine Person bestimmt nicht die Kapazität für 100 gleichzeitige Nutzer. Miss Wartezeit und Durchsatz pro Zeiteinheit.
Übertragen auf AI Inc.
Prüfe neben GPU-Zahlen Lieferung, Betriebszustand und Aufteilung auf Forschung, Training und Inferenz. Spielindikatoren lassen sich nicht in reale Tokenzahlen oder Antwortzeiten umrechnen.
Was ist multimodale KI?
Es handelt sich um eine KI, die mehrere Arten von Informationen wie Text, Bilder und Audio verarbeitet. „Modalität“ bezieht sich auf die Art der Informationen. Die verarbeitbaren Ein- und Ausgänge variieren je nach Modell.
Was ist multimodale KI?
Es handelt sich um eine KI, die mehrere Arten von Informationen wie Text, Bilder und Audio verarbeitet. „Modalität“ bezieht sich auf die Art der Informationen. Die verarbeitbaren Ein- und Ausgänge variieren je nach Modell.
Es handelt sich um eine KI, die mehrere Arten von Informationen wie Text, Bilder und Audio verarbeitet. „Modalität“ bezieht sich auf die Art der Informationen. Die verarbeitbaren Ein- und Ausgänge variieren je nach Modell.
Multimodal: Text, Bilder, Audio
Nutzen Sie verschiedene Arten von Informationen gemeinsam.
Links: Im Text vermitteln
Geben Sie Text wie Fragen, Erklärungen und Materialien ein.
Mitte: Verwendet auch Bilder
Eine Möglichkeit, dies zu nutzen, besteht darin, Text und Bilder zu kombinieren, um zu erklären, was gezeigt wird.
Rechts: Verwendet auch Stimme
Bei kompatiblen Modellen können Sie Ihre Stimme eingeben und Fragen zum Inhalt stellen.
Die verarbeitbaren Ein- und Ausgänge variieren je nach Modell. Nur weil Sie ein Bild eingeben können, heißt das nicht, dass Sie ein Bild generieren können. Überprüfen Sie die Ergebnisse sorgfältig auf dunkle Bilder oder schwer hörbare Audiosignale.
Dies ist eine erklärende Abbildung, die durch einen Schreibtisch und Materialien ersetzt wurde.
Kombinieren Sie verschiedene Arten von Informationen
Erklären Sie im Text, was auf dem Bild zu sehen ist, oder hören Sie sich den Ton an und antworten Sie, was auf dem Bild zu sehen ist. Ein Modell, das Bilder eingeben kann, generiert nicht unbedingt auch Bilder.
Die Ergebnisse ändern sich je nach Eingabebedingungen.
Kleiner Text, dunkle Bilder und schwer hörbare Stimmen können zu Fehlerkennungen führen. Auch wenn Sie mit mehreren Informationen umgehen können, müssen Sie die Richtigkeit jeder einzelnen Information überprüfen.
Zum Beispiel:Fügen Sie ein Foto bei und fragen Sie nach Anweisungen
Dies ist eine Möglichkeit, ein Foto einer Maschine mit dem Text „Was ist diese Schaltfläche?“ zuzuordnen. Wenn die Schaltfläche auf dem Foto nicht lesbar ist, kann es sein, dass das Modell falsch geraten hat.
Übertragen auf AI Inc.
Dies hilft Ihnen bei der Auswahl eines Forschungsfeldes oder Marktes zu überlegen, ob Ihre Kunden nur Text benötigen oder ob sie auch Bilder und Audio benötigen. Bitte überprüfen Sie die Beschreibung im Spiel auf kompatible Funktionen.
Was unterscheidet einen KI-Agenten von einer antwortenden KI?
Ein KI-Agent wählt Schritte zu einem Ziel und arbeitet mit Suche und Werkzeugen. Die Fähigkeit zu antworten und die Berechtigung zu handeln sind getrennte Dinge.
Was unterscheidet einen KI-Agenten von einer antwortenden KI?
Ein KI-Agent wählt Schritte zu einem Ziel und arbeitet mit Suche und Werkzeugen. Die Fähigkeit zu antworten und die Berechtigung zu handeln sind getrennte Dinge.
Ein KI-Agent wählt Schritte zu einem Ziel und arbeitet mit Suche und Werkzeugen. Die Fähigkeit zu antworten und die Berechtigung zu handeln sind getrennte Dinge.
Beantwortung von KI- und KI-Agenten
Trennen Sie das Lesen des Vorschlags von der Arbeit mit den Tools.
Links: Vorschläge schriftlich erhalten
Schlagen Sie den Zeitplan usw. des Kandidaten schriftlich vor. Das bloße Lesen des Vorschlags ändert nichts an Ihrer Reservierung oder Ähnlichem.
Rechts: Werkzeuge nutzen und Ergebnisse überprüfen
Wählen Sie die Schritte entsprechend Ihrem Zweck aus, führen Sie die Arbeit mithilfe von Tools wie Suche und Berechnung fort und überprüfen Sie die Ergebnisse.
Ein angeschlossenes Werkzeug zu haben und die Berechtigung zu haben, es zu bedienen, sind zwei verschiedene Dinge. Legen Sie für das Senden, Kaufen, Löschen usw. den Umfang der Genehmigung und die Bedingungen für die Genehmigung fest.
Dies ist eine erklärende Abbildung, die durch einen Schreibtisch und Materialien ersetzt wurde.
Überprüfen Sie die Ergebnisse mithilfe von Tools
Kombinieren Sie Vorgänge wie die Suche nach den benötigten Informationen, die Berechnung und die Aktualisierung von Datensätzen. Auch beim Einsatz von LLM werden die eigentlichen Vorgänge über angeschlossene Tools und Systeme durchgeführt.
Bestimmen Sie den Umfang dessen, was getan werden kann
Die Auswirkungen unterscheiden sich bei Vorgängen wie dem bloßen Lesen und Vorgängen wie dem Senden, Kaufen oder Löschen. Wir entwerfen die Werkzeuge, die verwendet werden können, die Vorgänge, die einer Genehmigung bedürfen, Möglichkeiten, sie auf halbem Weg zu stoppen, und Aufzeichnungen über die Ausführung.
Zum Beispiel:Schlagen Sie einen Termin vor oder bestätigen Sie eine Reservierung
Wenn Sie lediglich einen möglichen Zeitplan schriftlich vorschlagen, wird Ihre Reservierung nicht geändert. Sobald Sie sich mit dem Reservierungssystem verbinden und ihnen die Erlaubnis zur Bestätigung erteilen, können sie Maßnahmen ergreifen.
Seien Sie vorsichtig
Eine hohe Textgenerierungsleistung allein garantiert nicht, dass die Ihnen anvertraute Aufgabe sicher erledigt wird. Bewerten Sie den gesamten Ablauf einschließlich der Tools.
Übertragen auf AI Inc.
Modellveröffentlichungs- und Ausführungsrechte sind separate Entscheidungen. Lesen Sie auch bei Spielen den Umfang der Beurteilung, Überwachung und Unfallbedingungen, bevor Sie sich für den Umfang des akzeptablen Verhaltens entscheiden.
Neuronale Netze und Transformer6
Vom Rechnen mit Zahlen bis zum Schreiben von Sätzen. Leicht verständlich mit 6 Abbildungen.
MODEL / MECHANISM
Die Berechnung von Zahlen ist
bis daraus ein Satz wird.
Kommen wir zunächst zu kleinen Berechnungen und dann zu den Mechanismen zum Umgang mit Sätzen. Folgen Sie dem unsichtbaren Modell in 6 Schritten.
Berechnungen sind kleine Modelle zur Veranschaulichung. Durch Vorgänge auf dieser Seite wird das Spiel nicht verändert oder Inhalte gespeichert.
Was berechnet ein neuronales Netzwerk?
Es kombiniert die Eingabewerte mit den durch Lernen ermittelten Gewichten und wandelt diese über Schichten in Vorhersagen um. Sobald Sie eine Berechnung verstanden haben, können Sie verstehen, wie das größere Modell angezeigt wird.
Was berechnet ein neuronales Netzwerk?
Es kombiniert die Eingabewerte mit den durch Lernen ermittelten Gewichten und wandelt diese über Schichten in Vorhersagen um. Sobald Sie eine Berechnung verstanden haben, können Sie verstehen, wie das größere Modell angezeigt wird.
Es kombiniert die Eingabewerte mit den durch Lernen ermittelten Gewichten und wandelt diese über Schichten in Vorhersagen um. Sobald Sie eine Berechnung verstanden haben, können Sie verstehen, wie das größere Modell angezeigt wird.
Von der Eingabe bis zur Vorhersage.
3 links, 4 in der Mitte und 2 rechts. Hierbei handelt es sich um ein dreidimensionales Lehrmaterial, das Zahlen Schicht für Schicht kombiniert.
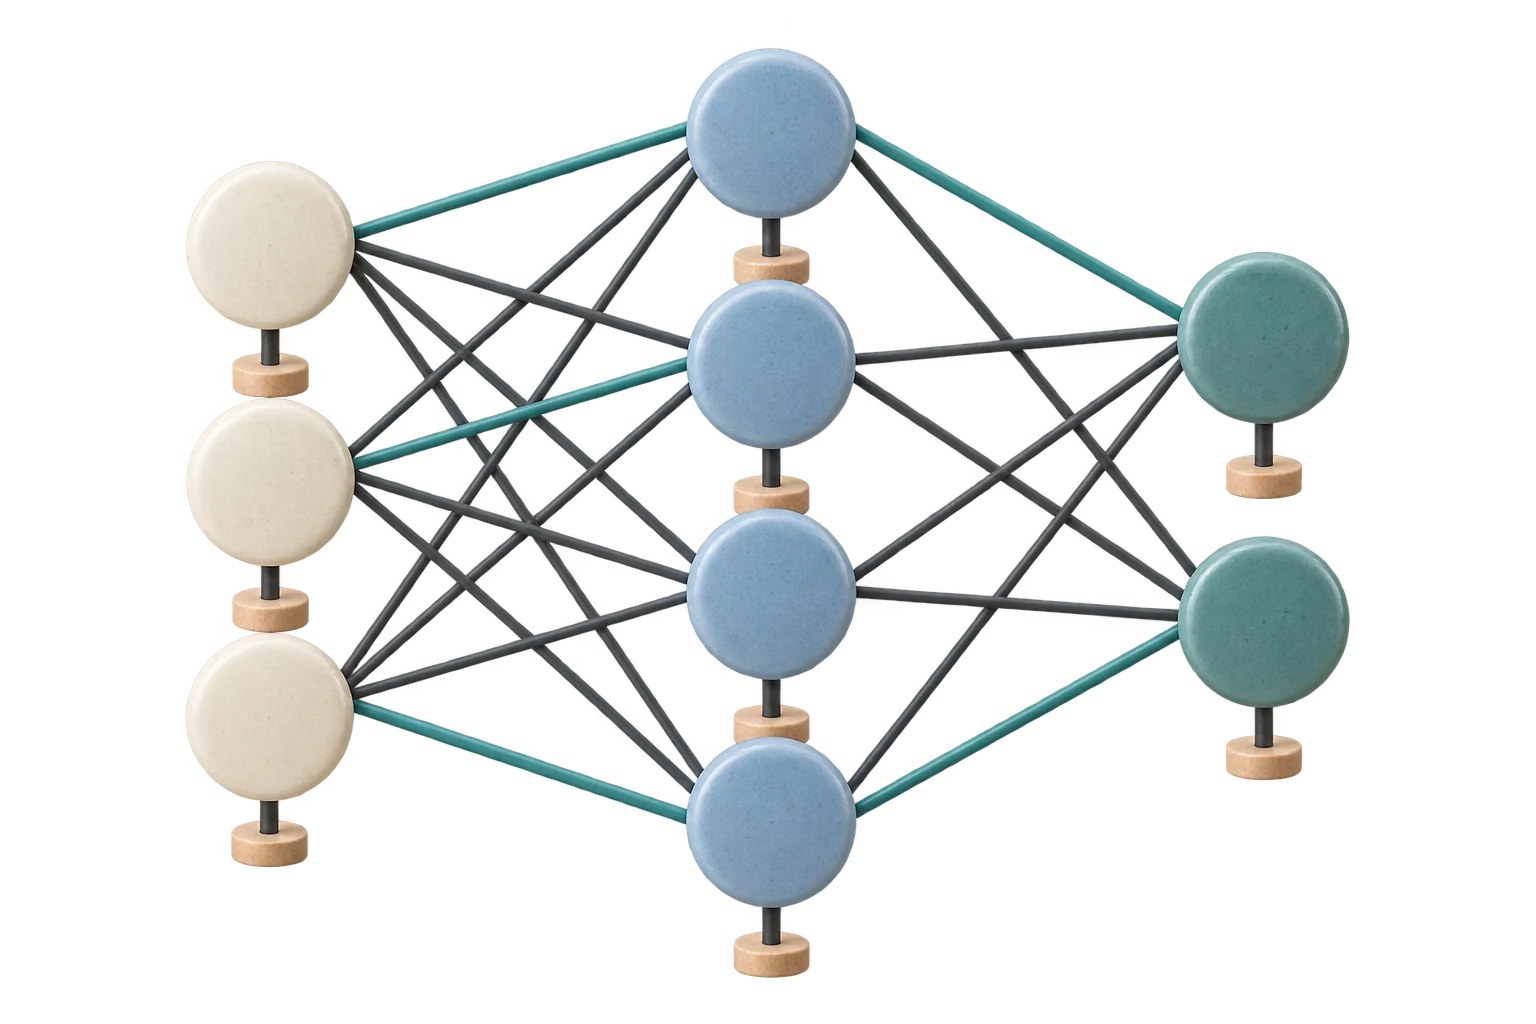
Links: Eingabe empfangen
Wandeln Sie Fotos, Texte usw. in Zahlen um, die das Modell verarbeiten kann.
Mitte: Kombinieren und konvertieren
Gewichte, Bias und Aktivierungsfunktionen erzeugen die nächste Darstellung.
Rechts: Wechsel zur Vorhersage
Erstellen Sie eine Ausgabe, die zum Job passt. Auch in diesem Stadium kann keine Garantie für korrekte Antworten gegeben werden.
Verfolgen wir zunächst die Berechnung eines Knotens anhand des folgenden Beispiels. Sie können auch die Auswirkungen negativer Gewichte und ReLU überprüfen.
Dies ist eine erläuternde Abbildung, die die Anordnung der Ebenen zeigt. Die Anzahl, Farbe und Dicke der Linien geben keinen Hinweis auf Verbindungen oder Gewichte im realen Modell.
Eingabeschicht: Wandelt die verarbeiteten Informationen in numerische Werte um
Übergeben Sie eine Zahl, die das Modell berechnen kann, z. B. ein Pixel für ein Foto oder eine Token-Darstellung für einen Text. Wie Eingaben erstellt werden, hängt von den verarbeiteten Daten ab.
Versteckte Ebene: Zahlen neu kombinieren
Jeder Knoten multipliziert die Werte der vorherigen Schicht mit Gewichten, summiert sie und addiert einen Bias. Eine Aktivierungsfunktion verarbeitet das Ergebnis, bevor es an die nächste Schicht geht. Schichten zwischen Ein- und Ausgabe heißen verborgene Schichten.
Gewichte und Bias: Werte, die beim Training angepasst werden
Gewichte bestimmen den Einfluss jeder Eingabe; negative Gewichte wirken subtraktiv. Der Bias verschiebt die Summe. Einzelne Zahlen enthalten dabei nicht jeweils ein bestimmtes Wissen oder einen einzelnen Fakt.
Aktivierungsfunktionen: Von der einfachen Addition bis hin zu komplexen Beziehungen
ReLU setzt negative Werte auf null und lässt andere unverändert. Rein lineare Schichten lassen sich insgesamt zu einer gleichartigen Berechnung zusammenfassen. Nichtlineare Zwischenschritte ermöglichen komplexere Zusammenhänge.
Ausgabeebene: Ändern Sie die Form entsprechend der Aufgabe
Konvertieren Sie den endgültigen Ausdruck in Klassifizierungspunkte, vorhergesagte Werte usw. Nicht alle Knotennummern sind Wahrscheinlichkeiten. Das folgende Beispiel zeigt auch die berechneten Ergebnisse.
Versuchen Sie, einen Knoten zu verschieben
Die Eingaben sind auf 1 und 2 festgelegt. Wie ändern sich der summierte Wert und die Ausgabe, wenn Sie die Gewichtungen und Bias ändern?
- 01 / Multiplizieren und addieren
1 × 0.6 + 2 × (−0.2) + 0.1
Eingaben mit Gewichten multiplizieren, aufsummieren und den Bias addieren.
- 02 / Durch ReLU führen
max(0, 0.3)
Wenn es negativ ist, ist es 0. Wenn es größer oder gleich 0 ist, wird es unverändert weitergegeben.
gesamt 0.3→Ausgabe 0.3
Probieren Sie es aus: Wenn Sie die Gewichtung auf 1 -0,6 setzen, beträgt die Summe -0,9 und die Ausgabe ist 0. Diese Ausgabe ist keine Wahrscheinlichkeit oder richtige Antwortrate.
Zum Beispiel:Einen Knoten berechnen
Bei Eingaben 1 und 2, Gewichten 0,6 und −0,2 sowie Bias 0,1 gilt: 1 × 0,6 + 2 × (−0,2) + 0,1 = 0,3. ReLU lässt 0,3 unverändert. Verändere die Gewichte und prüfe auch die Ausgabe bei einer negativen Summe.
Seien Sie vorsichtig
Der Name Neuron wurde vom Gehirn inspiriert. Wir haben es hier mit numerischen Berechnungen zu tun und es handelt sich nicht um eine direkte Reproduktion der Funktionsweise des Gehirns.
Die Abbildung erklärt schematisch Eingabe-, verborgene und Ausgabeschichten. Neuronale Netze können auch anders aufgebaut sein, etwa mit Faltungen für Bilder oder als Transformer.
Übertragen auf AI Inc.
Daten, Modelldesign und Rechenressourcen führen zu Gründen im Zusammenhang mit Lernergebnissen und Kosten. Diese Hilfe-Anpassungsschaltfläche dient zum Erlernen der Funktionsweise und ändert weder das Spielmodell noch die Speicherstände.
Welche Zahlen verändert das Training?
Messen Sie die Diskrepanz zwischen der Vorhersage und der richtigen Antwort und passen Sie die Gewichte nach und nach an, um die Diskrepanz zu verringern. Lassen Sie uns das Lesen der Antwort vom Aktualisieren der Zahlen im Modell trennen.
Welche Zahlen verändert das Training?
Messen Sie die Diskrepanz zwischen der Vorhersage und der richtigen Antwort und passen Sie die Gewichte nach und nach an, um die Diskrepanz zu verringern. Lassen Sie uns das Lesen der Antwort vom Aktualisieren der Zahlen im Modell trennen.
Messen Sie die Diskrepanz zwischen der Vorhersage und der richtigen Antwort und passen Sie die Gewichte nach und nach an, um die Diskrepanz zu verringern. Lassen Sie uns das Lesen der Antwort vom Aktualisieren der Zahlen im Modell trennen.
① Vorwärts rechnen: die Vorhersage
Berechnen Sie von der Eingabe bis zur Ausgabe mit den aktuellen Gewichten. Das ist Vorwärtsausbreitung. Zu diesem Zeitpunkt haben wir noch nicht festgestellt, ob dies der richtigen Antwort nahekommt oder nicht.
② Verlust messen: eine passende Fehlergröße
Eine Verlustfunktion vergleicht Vorhersage und Trainingsziel. Das Beispiel nutzt die quadrierte Differenz. Bei der Vorhersage des nächsten Tokens ist etwa Kreuzentropie geeignet: Sie berücksichtigt die Wahrscheinlichkeit des richtigen Tokens. Die Verlustfunktion muss zur Aufgabe passen.
③ Rückwärts rechnen: Änderungsrichtung finden
Backpropagation berechnet, wie sich der Verlust bei einer kleinen Änderung jedes Gewichts verändert. Diese Änderungsrate gehört zum Gradienten. Die Berechnung läuft von der Ausgabe zur Eingabe zurück und dient der Anpassung mehrerer Schichten.
④ Aktualisieren: die Schrittgröße wählen
Gewichte werden mit Gradient und Lernrate aktualisiert. Die Lernrate bestimmt die Schrittgröße; zu große Schritte können den Verlust erhöhen. In der Praxis wird das Training mit vielen Beispielen wiederholt und mit ungenutzten Beispielen evaluiert.
Gewicht Schritt für Schritt aktualisieren
Fest eingestellt sind Eingabewert 2, Zielwert 1 und Lernrate 0,1. Das Modell besitzt nur ein Gewicht: Vorhersage = 2 × Gewicht, Verlust = (Vorhersage − 1)².
aktualisieren 0·Vorhersage 0.2·Verlust 0.64
Steigung in diesem Beispiel = 4 x (2 x Gewicht – 1)
Neues Gewicht = aktuelles Gewicht – Lernrate x Gradient
0.1 − 0.1 × (−3.2) = 0.42
Im ersten Update ziehen wir einen negativen Gradienten, sodass das Gewicht zunimmt.
| Anzahl der Updates | Gewicht | Vorhersage | Verlust |
|---|---|---|---|
| 0 | 0.1 | 0.2 | 0.64 |
Dieses Lernbeispiel passt ein Modell an ein einziges Trainingsbeispiel an. Reale neuronale Netze berechnen per Backpropagation die Gradienten vieler Gewichte und werden auch mit Daten geprüft, die nicht zum Training dienten.
Zum Beispiel:Bringen Sie die Vorhersage 0,2 näher an die richtige Antwort 1
Bei Eingabewert 2 und Gewicht 0,1 ist die Vorhersage 0,2. Der Verlust beträgt (0,2 − 1)² = 0,64. Mit Lernrate 0,1 ergibt die erste Aktualisierung ein Gewicht von 0,42, eine Vorhersage von 0,84 und einen Verlust von 0,0256. Verfolge unten jede weitere Aktualisierung desselben Beispiels.
Seien Sie vorsichtig
Das Rechenbeispiel verwendet ein Modell mit einem Gewicht und ein Trainingsbeispiel. Es bildet nicht die Backpropagation eines vollständigen neuronalen Netzes nach.
Ein sinkender Verlust in diesem einfachen Beispiel garantiert weder erfolgreiches Training großer Modelle noch richtige Antworten auf unbekannte Fragen. Achte auch auf Überanpassung: gute Ergebnisse nur bei den Trainingsbeispielen.
Übertragen auf AI Inc.
Deshalb werden Forschungsabschluss, Haupttraining und anschließende Evaluation getrennt betrachtet. Vergleiche auch im Spiel die Prognose vor dem Training mit den Ergebnissen danach, um über die nächste Investition zu entscheiden.
Wie werden Sätze zu Zahlen?
Teilen Sie den Text in Token auf und verwenden Sie IDs, um sie in numerische Sequenzen umzuwandeln. Wir werden diesen numerischen Ausdruck mit den umgebenden Informationen kombinieren.
Wie werden Sätze zu Zahlen?
Teilen Sie den Text in Token auf und verwenden Sie IDs, um sie in numerische Sequenzen umzuwandeln. Wir werden diesen numerischen Ausdruck mit den umgebenden Informationen kombinieren.
Teilen Sie den Text in Token auf und verwenden Sie IDs, um sie in numerische Sequenzen umzuwandeln. Wir werden diesen numerischen Ausdruck mit den umgebenden Informationen kombinieren.
Token und ID: Legen Sie fest, welche Einheit verwaltet werden soll
Durch die Tokenisierung wird der Text in kleine Einheiten unterteilt und jedem eine ID zugewiesen. ID ist eine Identifikationsnummer und ihre Größe gibt keinen Aufschluss über die Stärke der Bedeutung des Wortes. Sie haben nicht immer eine Eins-zu-eins-Entsprechung mit japanischen Wörtern und Zeichen.
Einbettung: Von der ID zur erlernten Zahlenfolge
Über die ID wird ein Vektor aus der Einbettungstabelle abgerufen. Ein Vektor ist eine Zahlenfolge; seine Komponenten bedeuten nicht zwingend verständliche Eigenschaften wie Freundlichkeit oder Intelligenz.
Position: auch die Reihenfolge zählt
„Das Unternehmen entwickelt das Modell“ und „Das Modell entwickelt das Unternehmen“ unterscheiden sich in der Reihenfolge. Transformer nutzen auch Positions- oder relative Abstandsinformationen. Wie sie eingebunden werden, hängt von der Architektur ab.
Ausdruck im Kontext: Veränderungen in Kombination mit der Umgebung
Ab der ersten Einbettung verbindet jede Ebene diese mit der umgebenden Darstellung. Selbst wenn das Token dasselbe ist, ändert sich der Ausdruck in der Mitte je nach Kontext. Das bloße Ersetzen der ID vervollständigt die Interpretation des Textes nicht.
Von Token-IDs zu Zahlenvektoren
Schauen Sie sich die „Unternehmensmodelle“ in der hypothetischen Aufteilung an. Extrahieren Sie den Vektor anhand der ID als Anhaltspunkt aus der eingebetteten Tabelle.
Sie können die Tabelle lesen, indem Sie sie nach links und rechts verschieben.
| Position | Token | ID | Einbettung mit drei Komponenten |
|---|---|---|---|
| 1 | Unternehmen | 120 | [0.2, −0.4, 0.7] |
| 2 | Aber | 8 | [−0.1, 0.3, 0.2] |
| 3 | Modell | 305 | [0.6, 0.1, −0.2] |
| 4 | von | 9 | [0.1, −0.2, 0.4] |
- Einbettung entfernen
Die erste numerische Darstellung eines Tokens erzeugen.
- Verwendet auch Standortinformationen
Wortreihenfolge und Abstände auf die zur Architektur passende Weise einbeziehen.
- Erfassen Sie Umgebungsinformationen
Beim Durchlaufen jeder Ebene ändert sich der Ausdruck je nach Kontext.
ID305 ist nicht bedeutungsvoller als ID120. Tokenisierung, Dimensionen und Werte unterscheiden sich je nach Modell; einzelne Vektorkomponenten haben nicht unbedingt eine für Menschen lesbare Bedeutung.
Zum Beispiel:Lesen Sie das Wort „Modell“ als Umgebung.
„Ein KI-Modell bewerten“ und „Ein Architekturmodell ausstellen“ verwenden unterschiedliche Kontexte. Die Berechnung bezieht umgebende Informationen in die Token-Darstellung ein.
Seien Sie vorsichtig
Die Division, die ID und der 3-Komponenten-Vektor im Diagramm sind fiktive Beispiele zur Erläuterung. Die tatsächliche Aufteilung, Anzahl der Dimensionen und Zahlen variieren je nach Modell.
Übertragen auf AI Inc.
Bei der Auswahl der Kontextlänge und der Datennutzung ist es hilfreich, die Menge der zu verarbeitenden Informationen und den Rechenaufwand für die Verwendung dieser Informationen zu berücksichtigen.
Aus welchen Bausteinen besteht ein Transformer?
Attention mischt Informationen zwischen Positionen, Feed-Forward verändert jede Position. Diese Blöcke werden zu einem neuronalen Netz gestapelt.
Aus welchen Bausteinen besteht ein Transformer?
Attention mischt Informationen zwischen Positionen, Feed-Forward verändert jede Position. Diese Blöcke werden zu einem neuronalen Netz gestapelt.
Attention mischt Informationen zwischen Positionen, Feed-Forward verändert jede Position. Diese Blöcke werden zu einem neuronalen Netz gestapelt.
Informationen verknüpfen. Darstellungen verändern.
Von oben nach unten. Die Karte stellt einen sich wiederholenden Block dar, und die beiden Rahmen stellen einen sich wiederholenden Block dar.
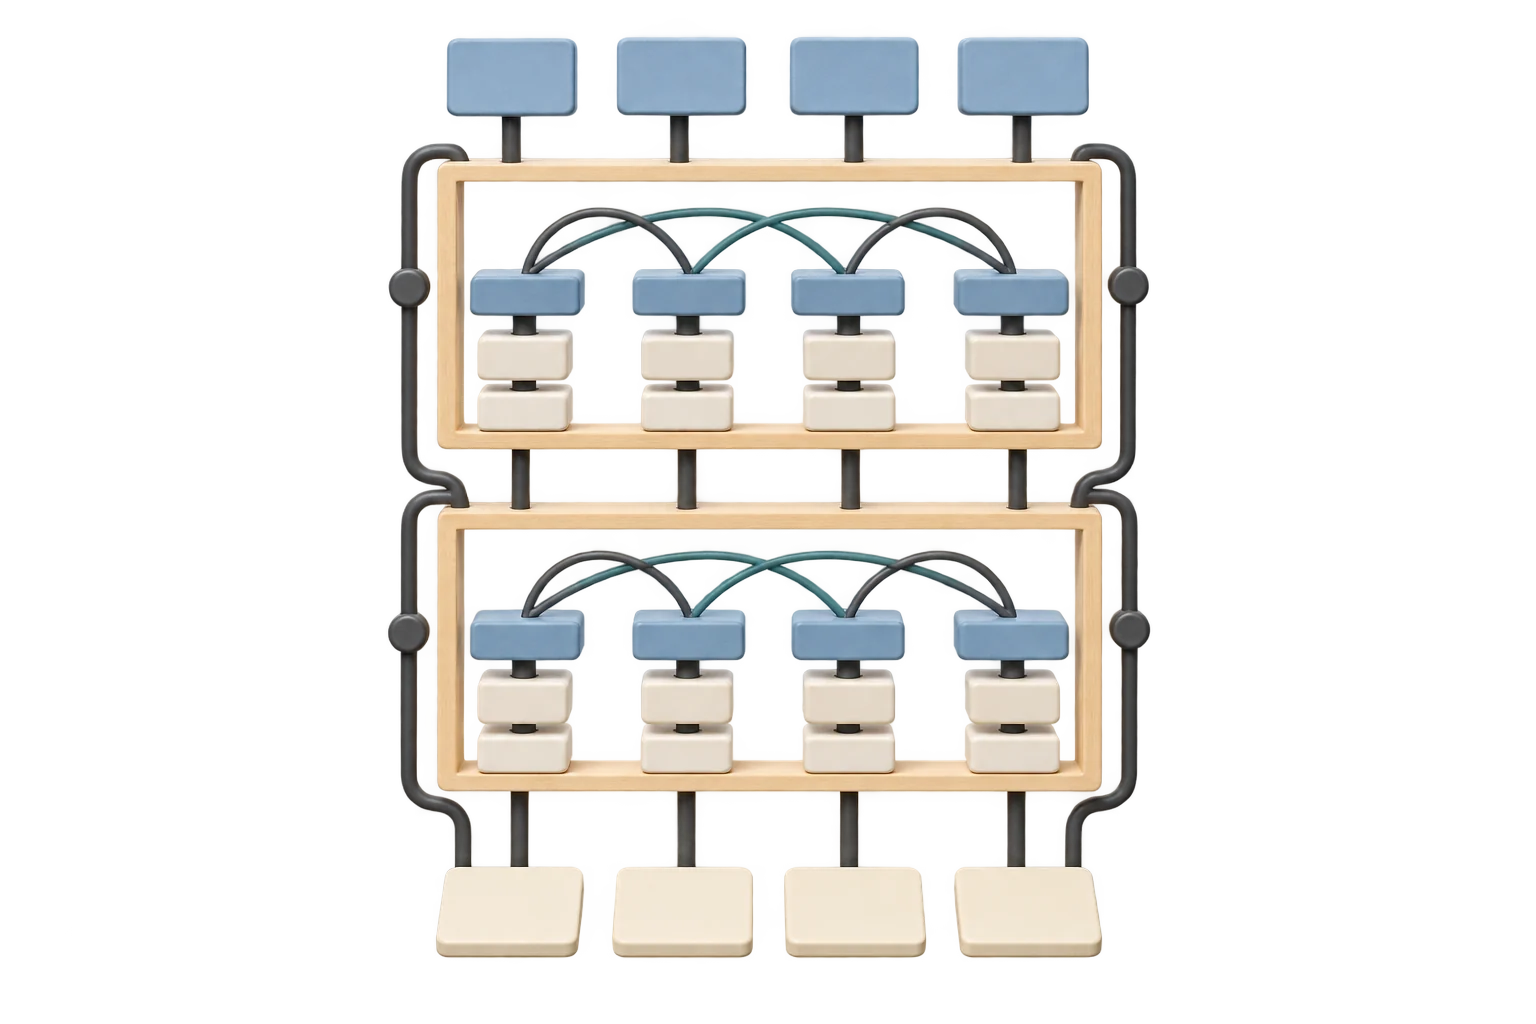
Obere Karte: Eingabeausdruck
Tokens in Zahlen umwandeln und Positionsinformationen einbeziehen.
Zwei Rahmen: gestapelte Blöcke
Mischen Sie die Informationen zwischen Positionen und konvertieren Sie die Darstellung jeder Position. Der Seitenweg ist eine Metapher, die den ursprünglichen Ausdruck bewahrt.
Untere Karte: Darstellung nach der Bearbeitung
Bei der Satzbildung gibt es einen Teil, der Vokabelwerte und Wahrscheinlichkeiten berechnet.
Das Modell besteht nicht nur aus Attention. Die folgende Abbildung erklärt Reihenfolge und Aufgaben der Verarbeitung.
Konzeptillustration einer Decoder-Architektur. Zwei Blöcke und vier Karten dienen nur der Erklärung; sie bilden kein konkretes Modell und nicht die gesamte Originalarchitektur ab.
Attention: Informationen anderer Positionen einbeziehen
Berechnen Sie, welcher Standort und wie viele Informationen importiert werden sollen. Ein abgelegener Standort ist ebenfalls ein Kandidat. Beschränken Sie in der Struktur, die Sätze generiert, den Referenzbereich, um zu vermeiden, dass zukünftige Token angezeigt werden.
Feed-Forward: dieselbe Berechnung für jede Position
Nach Attention wird jede Position mit einer gelernten, auch nichtlinearen Transformation verarbeitet. Innerhalb einer Schicht werden für alle Positionen dieselben Parameter verwendet.
Residualverbindungen und Normalisierung: Stützen tiefer Netze
Eine Residualverbindung addiert die ursprüngliche Darstellung zum neu berechneten Ergebnis. Die Normalisierung passt die Skala der Werte an. Gemeinsam ermöglichen sie das Stapeln von Blöcken. Wo normalisiert wird, hängt von der Architektur ab.
Endgültige Ausgabe: Zur Punktzahl des nächsten Token-Kandidaten
Bei der Textgenerierung wird die Darstellung der letzten Position in Werte für das gesamte Vokabular umgewandelt. Softmax erzeugt daraus eine Wahrscheinlichkeitsverteilung, aus der das nächste Token gewählt wird. Attention-Gewichte und Wahrscheinlichkeiten der Ausgabetokens sind verschiedene Werte.
Decoder-Typfluss, der zur Satzgenerierung verwendet wird
Lesen Sie von oben nach unten. Die abgebildete Karte entspricht „numerischer Ausdruck“ und der Rahmen entspricht „wiederholter Verarbeitung“.
- EingangToken → Einbettungs-/Standortinformationen
Wandeln Sie Sätze in Ausdrücke um, die in Berechnungen verwendet werden können.
- Transformer-Blöcke wiederholen01 / Zwischen PositionenMulti-Head Self-Attention
Versteckt den zukünftigen Standort und mischt Informationen über den Standort ein, die referenziert werden können.
Residualverbindungen und Normalisierung ergänzen02 / Pro PositionFeed-Forward(FFN)Dieselbe Ebene verwendet dieselben Gewichte und transformiert die Darstellung jeder Position nichtlinear.
Residualverbindungen und Normalisierung ergänzenDie beiden Blöcke in der Abbildung dienen nur zur Erläuterung. Die tatsächliche Anzahl variiert je nach Modell.
- Der Teil, der die Ausgabe erstelltDarstellung der letzten Position → Vokabularwerte → Softmax
Berechnen Sie die Wahrscheinlichkeit des nächsten aufeinander folgenden Token-Kandidaten.
- ErzeugenWählen Sie das nächste Token aus und fügen Sie es dem Kontext hinzu
Nutzen Sie den hinzugefügten Kontext, um zum nächsten Kandidaten zu gelangen.
Residualverbindungen addieren die ursprüngliche Darstellung; Normalisierung passt die Werteskala an. Ob vor oder nach einem Baustein normalisiert wird, hängt von der Architektur ab. Die Abbildung zeigt nicht den gesamten Encoder–Decoder der Originalarbeit.
| Zusammensetzung | Umfang und Zweck der Lektüre |
|---|---|
| Encoder | Verwenden Sie Vor- und Nachher-Eingaben, um Ausdrücke in Sätzen zu erstellen. Wird zur Klassifizierung und für Suchausdrücke verwendet. |
| Decoder | Generieren Sie die Fortsetzung anhand der Informationen bis zu jeder Position. Die hier dargestellte Konfiguration. |
| Encoder–Decoder | Kombinieren Sie die Seite, die Eingaben liest, und die Seite, die Ausgaben generiert. Die Originalarbeit befasst sich mit dieser Struktur in Übersetzung. |
Zum Beispiel:Worauf sich „es“ bezieht, wird als Kontext gelesen.
In „Das Unternehmen hat ein neues Modell veröffentlicht. Es kann Texte zusammenfassen“ hilft es, bei „es“ die Informationen zu „Modell“ einzubeziehen. Jede Schicht verändert diese Darstellung weiter und nutzt sie für die nächste Ausgabe. Der nächste Artikel zeigt eine konkrete Attention-Berechnung.
Seien Sie vorsichtig
Die Abbildung ist ein vereinfachtes Diagramm zum Verständnis des generativen Modells vom Typ Decoder. Es handelt sich nicht um den gesamten Encoder-Decoder im Originalpapier oder um ein Konfigurationsdiagramm eines bestimmten Produkts.
Die beiden Blöcke dienen nur zur Veranschaulichung. Die tatsächliche Anzahl der Schichten, Breite, Aktivierungsfunktion und Positionsinformationen variieren je nach Modell.
Übertragen auf AI Inc.
Dies bietet einen Hintergrund für die Betrachtung des Modelldesigns, der erforderlichen Rechenressourcen und des Bereitstellungsaufwands. Der Forschungsstand und die Leistungswerte des Spiels sind nicht die tatsächlichen Zusammensetzungs- oder Messwerte selbst.
Was machen Q, K und V bei Self-Attention?
Erstellen Sie ein Q, um nach den Informationen zu suchen, die Sie importieren möchten, ein K zum Überprüfen und ein V, um die Informationen tatsächlich zu importieren, und mischen Sie die Vs entsprechend der Stärke der Beziehung.
Was machen Q, K und V bei Self-Attention?
Erstellen Sie ein Q, um nach den Informationen zu suchen, die Sie importieren möchten, ein K zum Überprüfen und ein V, um die Informationen tatsächlich zu importieren, und mischen Sie die Vs entsprechend der Stärke der Beziehung.
Erstellen Sie ein Q, um nach den Informationen zu suchen, die Sie importieren möchten, ein K zum Überprüfen und ein V, um die Informationen tatsächlich zu importieren, und mischen Sie die Vs entsprechend der Stärke der Beziehung.
Attention: Beziehungen im Satz
Auch die Beziehungen zwischen weit auseinander liegenden Elementen werden in die Berechnung einbezogen.
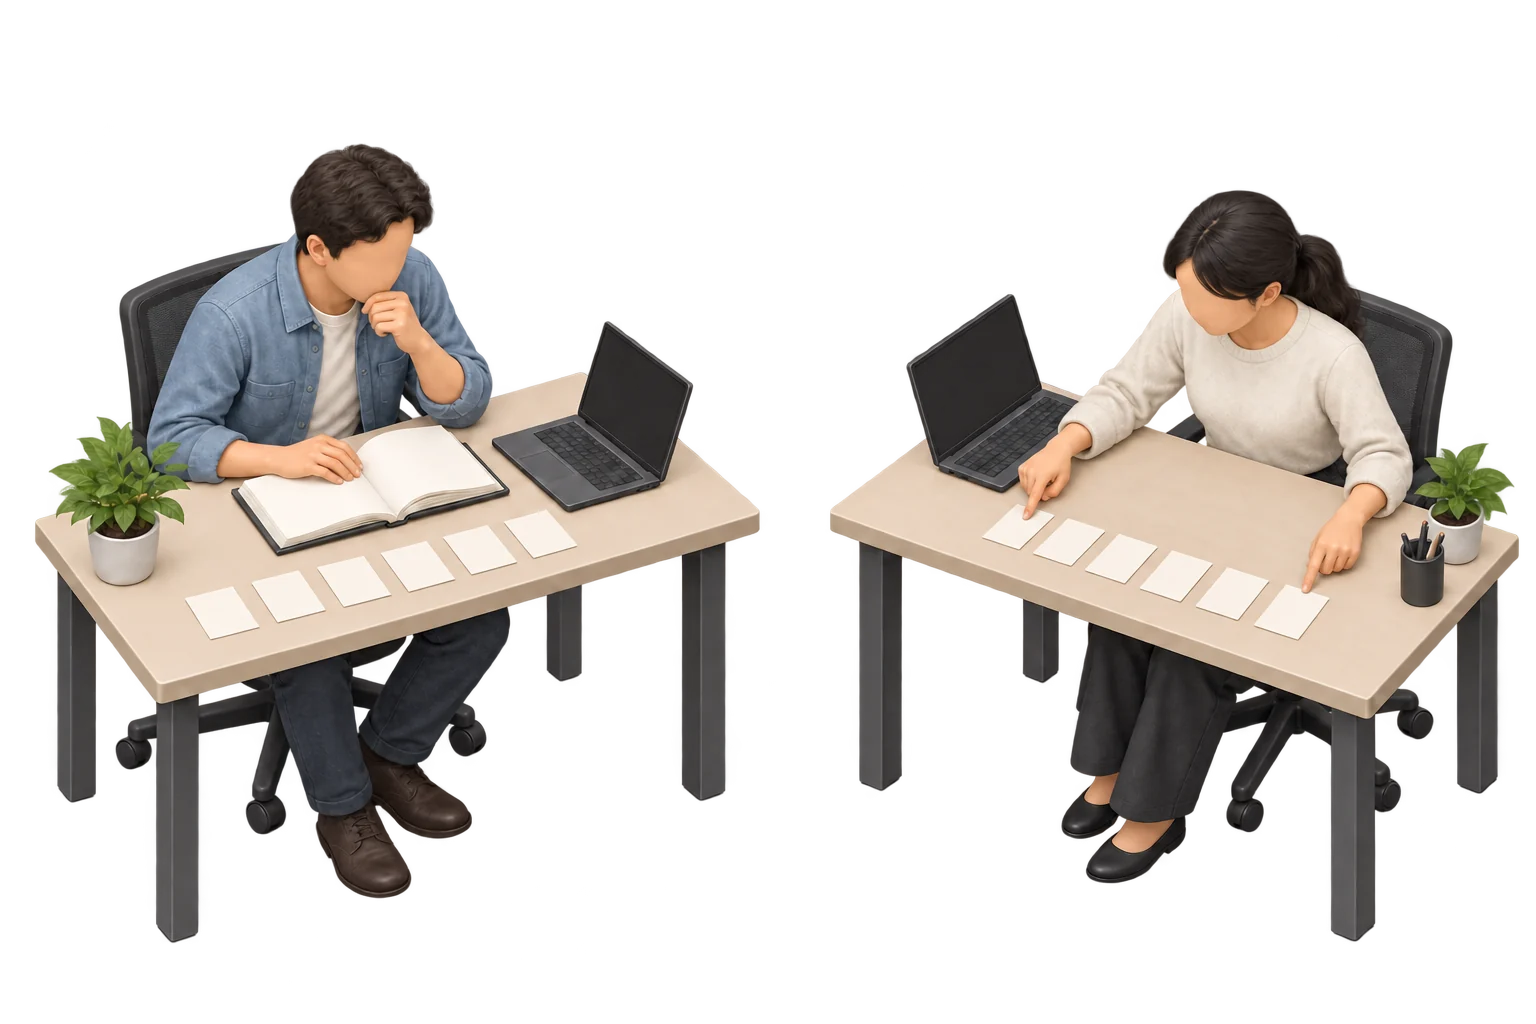
Sehen Sie sich die Beziehung zwischen „es“ und „Modell“ an
Das Unternehmen hat ein neues Modell veröffentlicht. Es kann Texte zusammenfassen.
ein neues ModellUndEs
In diesem Satz ist die Beziehung zwischen „es“ und „Modell“ ein Hinweis. Dabei werden auch Beziehungen zwischen weit auseinander liegenden Wörtern berücksichtigt.
Dieses Beispiel erklärt Beziehungen zwischen Wörtern. Es zeigt keine tatsächlichen Attention-Gewichte.
Berechnen Sie Beziehungen in der Eingabe
Self-Attention berechnet für ein Token, wie stark andere Tokens derselben Eingabe damit zusammenhängen.
Erstellen Sie Ausdrücke, die zum Kontext passen
Wir beziehen diese Zusammenhänge in unsere Berechnungen ein und erstellen kontextsensitive Darstellungen über mehrere Ebenen hinweg.
Die Papierstücke stehen sinnbildlich für Textelemente. Reale Tokens entsprechen nicht immer Wörtern. Attention bezeichnet eine Berechnungsmethode und kein menschliches Bewusstsein.
Dies ist eine erklärende Abbildung, die durch einen Schreibtisch und Materialien ersetzt wurde.
Q und K: numerische Darstellungen zum Vergleichen
Ändern Sie die Darstellung jeder Position mithilfe der erlernten Transformation in Q (Abfrage), K (Schlüssel) und V (Wert). Berechnen Sie das Skalarprodukt von Q und K und erstellen Sie einen Wert, der entsprechend der Anzahl der Dimensionen angepasst wird. Q ist eine Metapher ähnlich einer Suchanfrage, aber keine Frage im Text selbst.
Softmax: aus Werten werden Gewichte
Softmax verwandelt die Werte zugänglicher Positionen in Gewichte mit Summe 1. Im generativen Beispiel werden spätere Positionen zuerst maskiert; ihr Gewicht wird 0.
V: Informationen gewichtet mischen
Jedes V wird mit seinem Attention-Gewicht multipliziert; die Ergebnisse werden addiert. Dabei wird nicht nur ein Wort ausgewählt: Informationen mehrerer zulässiger Positionen fließen ein.
Multi-Head: mehrere Transformationen parallel
Jeder Leiter mit unterschiedlichen erlernten Transformationen berechnet die Beziehung und fasst die Ergebnisse zusammen. Menschen entscheiden nicht unbedingt über die Rolle jedes einzelnen Leiters, und das bedeutet nicht unbedingt, dass sie sich auf Grammatik oder Pronomen spezialisiert haben. Das folgende Beispiel hat nur 1 Kopf.
Gewichte aus Q, K und V berechnen
Fiktives Beispiel mit drei Positionen, zwei Dimensionen und einem Head. Q wird mit den K aller Positionen verglichen; die daraus entstehenden Gewichte mischen die V. Dies ist nicht die Auswahl des nächsten Wortes aus dem Vokabular.
Ziel Q = [1, 1]
Punktzahl = inneres Produkt von Q und K ÷ √2
Sie können die Tabelle lesen, indem Sie sie nach links und rechts verschieben.
| Position | K: zum Vergleichen | V: zu mischende Informationen | Punktzahl |
|---|---|---|---|
| 1「Unternehmen」 | [1, 0] | [0.4, 0.1] | 0.707 |
| 2「Modell」 | [1, 1] | [0.8, 0.6] | 1.414 |
| 3「Das」 | [0, 1] | [0.1, 0.2] | 0.707 |
Verteilung nach Softmax: insgesamt 100 %
- 1「Unternehmen」24.8%
- 2「Modell」50.3%
- 3「Das」24.8%
Position3「Das„Gemischtes Ergebnis [0.527, 0.377]。Versteckt den zukünftigen Standort.
Ergebnis = 0.248 × [0.4, 0.1] + 0.503 × [0.8, 0.6] + 0.248 × [0.1, 0.2]
Jedes V wird mit der Verteilung multipliziert und für jede Komponente addiert. Die angezeigten Werte sind gerundet, daher kann die angezeigte Summe von 100 % abweichen.
Probieren Sie es aus: Wenn Sie Position 1 wählen, wird nur Position 1 zu 100 % verwendet, wenn eine Kausalmaske vorhanden ist. Wenn Sie die Maske entfernen, werden auch die späteren Stellen zu Kandidaten. Zahlen sind keine Maße realer Modelle.
Zum Beispiel:Mit fiktiven Werten für „es“ rechnen
Das Beispiel nutzt Q, K und V an drei Positionen. Das Skalarprodukt des gewählten Q mit jedem K wird durch √2 geteilt und anschließend durch Softmax geführt. Wählst du eine frühere Position, werden im generativen Beispiel spätere Positionen maskiert. Vergleiche Gewichte und gemischtes Ergebnis.
Seien Sie vorsichtig
Tokenisierung, Q, K, V und Werte sind fiktive Beispiele. Sie messen keine Attention eines realen Modells und belegen nicht, dass semantische Beziehungen korrekt gelernt wurden.
Attention-Gewichte ändern sich mit der Eingabe. Das allein bedeutet keine Aktualisierung der trainierten Parameter.
Attention ist der Name einer Berechnung, keine menschliche Aufmerksamkeit und keine Garantie richtiger Ausgaben.
Übertragen auf AI Inc.
Dies führt zu dem Grund, warum Speicher in Berechnungen verwendet wird, die lange Kontexte und Inferenz verarbeiten. Bei der Betrachtung der Kundenversorgung betrachten wir die Modellqualität und die Ressourcenbelastung gemeinsam.
Wie setzt ein LLM einen Text fort?
Hier betrachten wir die autoregressive Satzgenerierung. Berechnet die Wahrscheinlichkeit des nächsten Tokens aus dem übergebenen Kontext, fügt das ausgewählte Token zum Kontext hinzu und berechnet das nächste.
Wie setzt ein LLM einen Text fort?
Hier betrachten wir die autoregressive Satzgenerierung. Berechnet die Wahrscheinlichkeit des nächsten Tokens aus dem übergebenen Kontext, fügt das ausgewählte Token zum Kontext hinzu und berechnet das nächste.
Hier betrachten wir die autoregressive Satzgenerierung. Berechnet die Wahrscheinlichkeit des nächsten Tokens aus dem übergebenen Kontext, fügt das ausgewählte Token zum Kontext hinzu und berechnet das nächste.
Mischen Sie keine unvollendeten Fortsetzungen mit Eingaben
Beim Generieren werden Anweisungen und vorherige Ausgaben verwendet. Selbst wenn beim Lernen Sätze mit richtigen Antworten nebeneinander verarbeitet werden, wird eine Kausalmaske verwendet, um zu verhindern, dass jede Position zukünftige richtige Antworten sieht. Mehrere Lernpositionen parallel berechnen zu können ist eine Sache, zukünftige Antworten sehen zu können eine andere.
Wählen Sie nach Wahrscheinlichkeit: Nicht immer der beste Kandidat
Es gibt Methoden zur Auswahl von Kandidaten mit hoher Wahrscheinlichkeit und Methoden zur Auswahl von Kandidaten basierend auf der Wahrscheinlichkeit. Die Ausgabe variiert je nach Auswahlmethode und Einstellungen wie der Temperatur. Diese Wiederholung lässt sich nicht einfach dadurch erkennen, dass die gesamte Antwort auf einmal gelöst werden kann.
Der ausgewählte Token wird auch zum nächsten Kontext.
Fügen Sie das generierte Token zum Kontext hinzu und berechnen Sie den nächsten Kandidaten. Es wird fortgesetzt, bis ein Token erreicht wird, das eine Beendigung, ein Ausgabelimit usw. anzeigt. Da die Auswahl wiederholt wird, wirken sich Unterschiede in der anfänglichen Ausgabe auch auf nachfolgende Sätze aus.
Setzen Sie Ihre Auswahl mit der nächsten Eingabe fort
Sowohl Division als auch Wahrscheinlichkeit sind fiktiv. Zur besseren Übersicht hier ein Beispiel, bei dem Kandidaten mit hoher Wahrscheinlichkeit ausgewählt werden.
- 01
- aktuellen Kontext
- KI-
- nächster Kandidat
- Forschung 60 % · Nutzung 25 % · Sonstiges 15 %
- wählen
- die Studie
- Nächster Kontext
- KI-Forschung
- 02
- aktuellen Kontext
- KI-Forschung
- nächster Kandidat
- 70 % · 20 % · Sonstige 10 %
- wählen
- von
- Nächster Kontext
- Die KI-Forschung
- 03
- aktuellen Kontext
- Die KI-Forschung
- nächster Kandidat
- Vorschuss 55 % · Unterstützung 30 % · Sonstiges 15 %
- wählen
- fortfahren
- Nächster Kontext
- Die KI-Forschung voranbringen
In der Realität variiert die Auswahlmethode je nach Einstellung, beispielsweise eine Lotterie nach Wahrscheinlichkeit. Die Wahrscheinlichkeit des nächsten Tokens ist nicht die Wahrscheinlichkeit, dass der Inhalt wahr ist. Bei der normalen Generierung werden die gelernten Gewichtungen nicht für jede Antwort aktualisiert.
Zum Beispiel:„KI-“ schrittweise fortsetzen
Zur Erläuterung würde der Ablauf darin bestehen, „Forschung“ zu „KIs“ hinzuzufügen, „wo“ zu „KIs Forschung“ hinzuzufügen und dann den nächsten Kandidaten zu berechnen. Die Kandidaten und Wahrscheinlichkeiten im Diagramm sind fiktiv. Die tatsächlichen Tokenisierungen und Kandidaten variieren je nach Modell und Kontext.
Seien Sie vorsichtig
Die Wahrscheinlichkeit des nächsten Tokens ist nicht die Wahrscheinlichkeit, dass der Inhalt wahr ist. Selbst in natürlichen Sätzen können Fehler auftreten. Überprüfen Sie sie daher anhand von Materialien und Berechnungsergebnissen.
Bei der normalen Satzbildung werden die gelernten Gewichte nicht bei jeder Antwort aktualisiert. Zusätzliches Lernen ist ein separater Prozess.
Inferenzimplementierungen können vorhandene Berechnungen wiederverwenden, beispielsweise in KV-Caches. Das Diagramm zeigt den Informationsfluss und bedeutet nicht, jedes Mal alles neu zu berechnen.
Übertragen auf AI Inc.
Bei der Erbringung von Dienstleistungen für Kunden sind Rechenressourcen für die Inferenz erforderlich, um Sätze zu erzeugen. Wir trennen die Lernkosten zur Vervollständigung des Modells und die Bereitstellung und Kosten für die weitere Nutzung.
Aktuelle KI-Forschung10
Stand: 5. Oktober 2026. Neun Forschungstrends aus aktuellen wissenschaftlichen Arbeiten mit Ergebnissen und Grenzen.
Bestätigungsdatum · Zehn Arbeiten von Mai bis September 2026
Von der Fähigkeit, Antworten zu formulieren, bis hin zur Fähigkeit, lange Aufgaben zu erledigen. Lesen Sie mehr über Forschungsrichtungen aus aktuellen Veröffentlichungen, einschließlich der Verwendung von Berechnungen, der Zuverlässigkeit von Beweisen und der Gestaltung von Bewertung und Autorität.
Wie soll ich die neuesten Forschungstrends lesen?
Hier stellen wir neun Richtungen aus 10 Artikeln vor, die von Mai bis September 2026 veröffentlicht wurden. Zu den Zielen gehören Inferenz, Agenten, Gedächtnis, Effizienz, Sprache, Weltmodelle, Zuverlässigkeit, Bewertung und Autoritätsdesign.
Wie soll ich die neuesten Forschungstrends lesen?
Hier stellen wir neun Richtungen aus 10 Artikeln vor, die von Mai bis September 2026 veröffentlicht wurden. Zu den Zielen gehören Inferenz, Agenten, Gedächtnis, Effizienz, Sprache, Weltmodelle, Zuverlässigkeit, Bewertung und Autoritätsdesign.
Hier stellen wir neun Richtungen aus 10 Artikeln vor, die von Mai bis September 2026 veröffentlicht wurden. Zu den Zielen gehören Inferenz, Agenten, Gedächtnis, Effizienz, Sprache, Weltmodelle, Zuverlässigkeit, Bewertung und Autoritätsdesign.
Lesen Sie, was wir geändert und verglichen haben
Überprüfen Sie das Modell, die Daten, das Rechenbudget und die Bewertungskriterien. Wenn die Bedingungen unterschiedlich sind, können die in verschiedenen Arbeiten erhaltenen numerischen Werte nicht direkt eingestuft werden. In jedem Abschnitt werden die Methode und die beobachteten Ergebnisse separat beschrieben.
Veröffentlichungsdatum und Annahme/Verifizierung sind getrennt.
Preprints sind Manuskripte, die veröffentlicht werden können, noch bevor sie von Fachzeitschriften oder Konferenzen einem Peer-Review unterzogen wurden. Bei Beiträgen, die von einer Konferenz genehmigt wurden, wird dies angegeben. Akzeptanz oder hohe Punktzahlen allein bestätigen nicht die Wirksamkeit in allen Anwendungen.
| Was es zu sehen gibt | zu bestätigen |
|---|---|
| Thema | Mit welchen Modellen, Sprachen, Daten und Herausforderungen haben Sie es versucht? |
| Vergleichsbedingungen | Haben Sie den Rechenaufwand, die Anzahl der Versuche und die Ausrüstung verglichen? |
| Index | Treffer im ersten Versuch oder mindestens ein richtiger Kandidat? |
| Reproduzierbarkeit | Können Sie die Methode, den Code, die Daten und die Version des Papiers bestätigen? |
| Limit | Welche Bedingungen wurden nicht überprüft oder welche zusätzlichen Überprüfungen sind erforderlich? |
Zum Beispiel:Auch wenn die richtige Antwortquote hoch ist, ist die Anzahl der Versuche unterschiedlich
Genauigkeit einer einzelnen Antwort und Anteil mit mindestens einem richtigen Kandidaten aus mehreren sind verschiedene Kennzahlen. Prüfe Aufgabe, Modell, Kandidatenzahl und Rechenbudget. Ein hoher Wert allein macht die einzelne Antwort nicht verlässlicher.
Seien Sie vorsichtig
Auf dieser Seite finden Sie Erläuterungen zu den ausgewählten Beiträgen. Es handelt sich nicht um einen fachweiten Konsens oder eine aktualisierte Rangliste realer Produkte. Wir unterscheiden auch zwischen Forschungsergebnissen und Spieleumsetzung.
Begründung: Nicht nur mehr Berechnungen, sondern andere Denkweisen
Bei Recherchen, die bei der Beantwortung viele Kandidaten hervorbringen, besteht die Herausforderung darin, dieselben Fehler zu wiederholen. PTTS legt zunächst verschiedene Lösungsstrategien fest und erstellt jeden Kandidaten entsprechend dieser Strategie.
Bei Recherchen, die bei der Beantwortung viele Kandidaten hervorbringen, besteht die Herausforderung darin, dieselben Fehler zu wiederholen. PTTS legt zunächst verschiedene Lösungsstrategien fest und erstellt jeden Kandidaten entsprechend dieser Strategie.
Trennen Sie die Lösungsstrategien, bevor Sie die Anzahl der Kandidaten erhöhen
Bereiten Sie zunächst mehrere Richtlinien vor und erstellen Sie darauf basierend Antwortkandidaten.
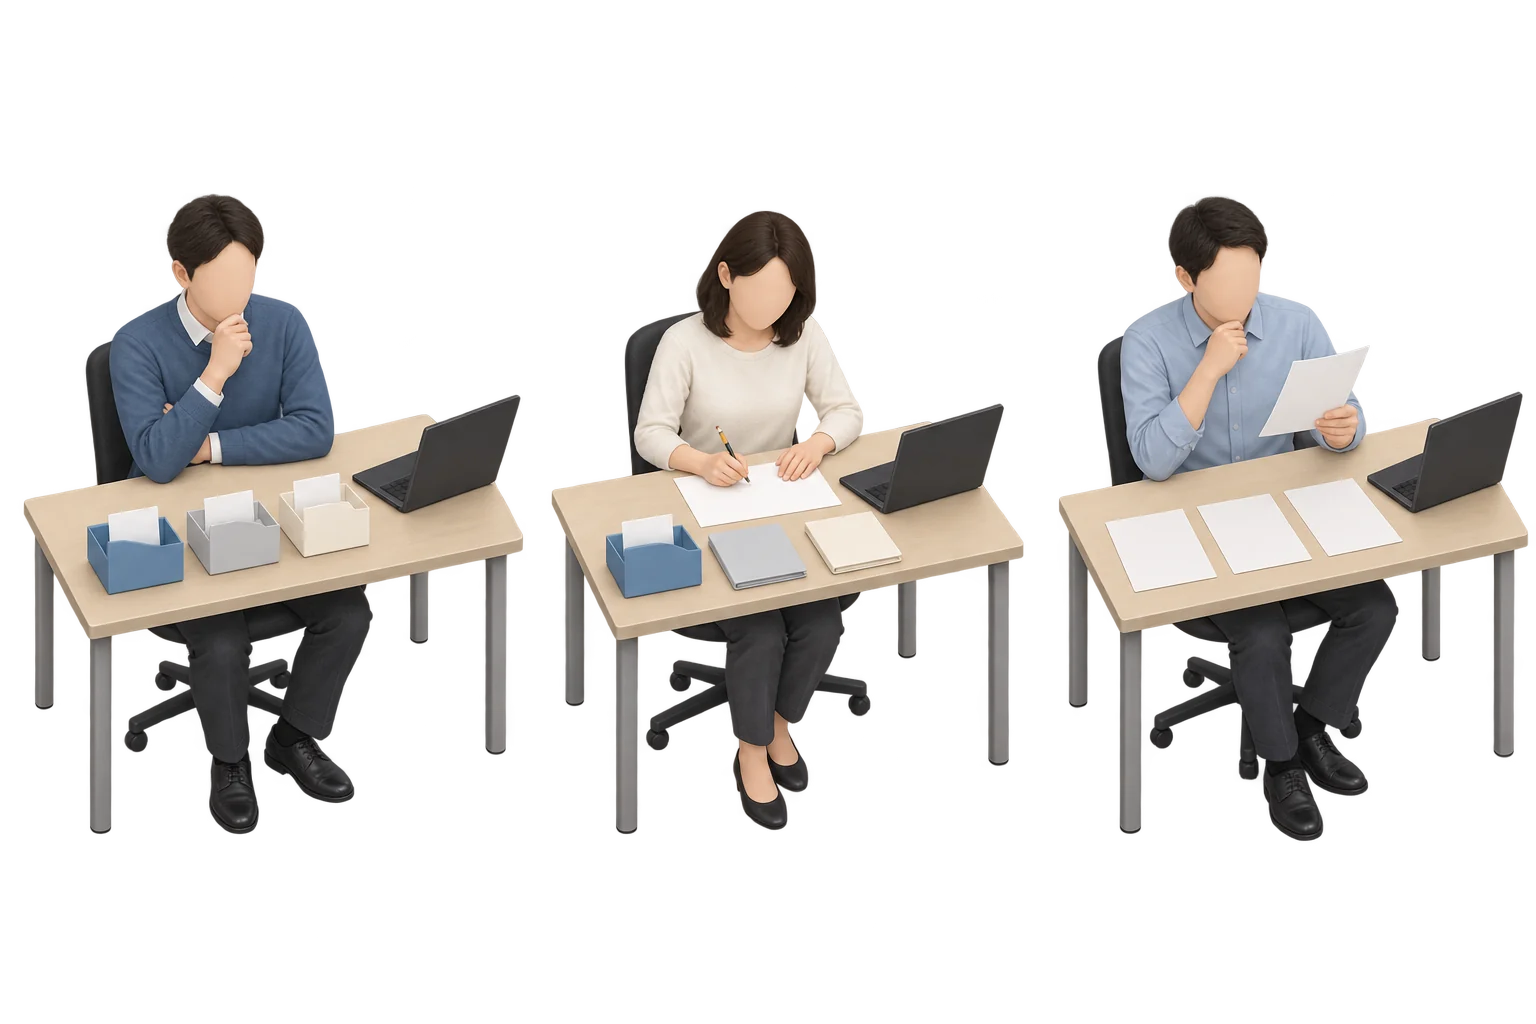
Links: Erstellen Sie zunächst eine andere Richtlinie
Planen Sie, wie Sie versuchen werden, dasselbe Problem zu lösen. Beim PTTS berücksichtigen politische Entscheidungsträger mehrere Kandidaten gleichzeitig und zielen darauf ab, die Konzentration auf ähnliche Studien zu verringern.
Mitte: Kandidaten gemäß den Richtlinien erstellen
Der Ausführende erstellt anhand des Problems und jeder Strategie Antwortkandidaten. Das Vorbereiten einer Richtlinie und das Verfassen einer konkreten Antwort sind zwei verschiedene Aufgaben.
Rechts: Messen Sie, ob der Kandidat die richtige Antwort hat
Bewerten Sie die Antwortkandidaten und messen Sie, ob mindestens eine Antwort richtig ist. Erwägen Sie die Aufnahme der richtigen Antwort und die Möglichkeit, diese auszuwählen und an den Benutzer zurückzugeben.
pass@k misst, ob mindestens einer von k Kandidaten richtig ist. Es misst weder die Genauigkeit einer Einzelantwort noch die Fähigkeit, die richtige Antwort auszuwählen.
Kartenetui, Akte und Papier sind Metaphern zur Erklärung. Die Farbe des Containers stellt den Unterschied in der Richtlinie dar, nicht die Rangfolge der Leistung. Die Anzahl der Blätter oder die Anzahl der Personen sagt nichts über die Anzahl der Versuche oder Modelle für eine Arbeit aus. Auch die Situation rechts garantiert nicht, dass automatisch die richtige Antwort ausgewählt wird.
So verwenden Sie Berechnungen im trainierten Modell
Die Methode zur Verwendung zusätzlicher Berechnungen während der Inferenz wird als Testzeitskalierung bezeichnet. Bei PTTS erwägen wir auch Möglichkeiten, die Richtlinienersteller und -umsetzer zu trennen und Verstärkungslernen zu nutzen, um die Richtlinienersteller anzupassen.
Was die Zeitung berichtete
Auf fünf Mathematik-Evaluationen mit Qwen3 1.7B und 4B wird besseres pass@64 als bei unabhängiger wiederholter Generierung berichtet. Gemessen wird, ob mindestens einer von 64 Kandidaten richtig ist.[R01]
Umfang der Ergebnisse und verbleibende Herausforderungen
Eine weitere Herausforderung besteht darin, aus mehreren Kandidaten zuverlässig die richtige Antwort auswählen zu können und mit einer einzigen Antwort die gleiche Verbesserung zu erzielen. Abhängig von Ihrem Zweck müssen Sie auch die nichtmathematischen Arbeiten, die Wartezeit und die Kosten prüfen.
Zum Beispiel:Wenn nur einer von vier Kandidaten richtig ist
Angenommen, Sie erstellen vier Antwortkandidaten für eine bestimmte Frage und nur einer ist richtig. Diese Ausgabe zählt als Erfolg in pass@4. Sehen Sie sich diesen Erfolgsprozentsatz für mehrere Probleme an. Das bedeutet nicht, dass Sie jedes vierte Mal die richtige Antwort bekommen, und es bedeutet auch nicht, dass Sie definitiv die richtige Antwort wählen können. Die Beispiele für 4 Kandidaten dienen nur zur Veranschaulichung und geben nicht die Leistung der Arbeit wieder.
Übertragen auf AI Inc.
Dies führt zu Entscheidungen, die nicht nur die Forschungsleistung berücksichtigen, sondern auch die für die Bereitstellung an Kunden erforderlichen Inferenzressourcen. Dies bedeutet nicht, dass PTTS im Spiel individuell konfiguriert werden kann.
Agent: Von Zwischenoperationen bis zur Bewertung fertiger Produkte
Selbst wenn Sie Tools suchen und verwenden können, heißt das nicht unbedingt, dass Sie eine lange Aufgabe erledigen können. KNOWS wertet Webarbeit aus, die Informationen sammelt, organisiert und Dokumente und andere Ergebnisse erstellt.
Selbst wenn Sie Tools suchen und verwenden können, heißt das nicht unbedingt, dass Sie eine lange Aufgabe erledigen können. KNOWS wertet Webarbeit aus, die Informationen sammelt, organisiert und Dokumente und andere Ergebnisse erstellt.
Von Zwischenoperationen bis zu verwertbaren Ergebnissen
Auf das Sammeln von Informationen folgt die Organisation und Bestätigung des fertigen Produkts.
Links: Sammeln Sie die notwendigen Informationen
Das Suchen und Abrufen von Materialien gehört zu den Aufgaben. Selbst wenn die Informationen gefunden werden, bedeutet dies nicht unbedingt, dass die angeforderten Arbeiten abgeschlossen wurden.
Mitte: Organisieren und gestalten
Vergleichen Sie die gesammelten Informationen und stellen Sie sie in das gewünschte Format zusammen, z. B. ein Dokument, eine Tabelle oder eine Folie. Es kommt nicht nur auf den Inhalt an, sondern auch auf das Layout und die Struktur.
Rechts: Vergleich des fertigen Produkts mit der Anfrage
Stellen Sie sicher, dass Sie über die erforderlichen Informationen verfügen und diese wie angegeben konfiguriert und angezeigt werden. Bewerten Sie die Zwischenoperationen und die endgültigen verwertbaren Ergebnisse getrennt.
„Ich konnte die Materialien erhalten“ und „Ich konnte die Anfrage abschließen“ sind unterschiedliche Ergebnisse. Wenn Sie das fertige Produkt überprüfen, können Sie leichter herausfinden, wo der Prozess gestoppt wurde.
Dies ist eine erklärende Illustration, die durch Schreibtischarbeit ersetzt wurde. Dies ist keine Reproduktion der tatsächlichen KNOWS-Bildschirme oder Bewertungsaufgaben, und die Szene rechts ist keine Darstellung, die den Erfolg garantiert. Dies unterscheidet sich vom Spielbereitstellungsverfahren.
Nicht nur das Modell, sondern auch die Art und Weise der Werkzeugübergabe ist wichtig.
Auch bei gleichem Modell variieren die Ergebnisse je nach Einsatzbereich und Mechanik des Werkzeugs. Ziel ist es, separat zu messen, ob die Zwischenvorgänge erfolgreich waren und ob das fertige Produkt verwendet werden kann.
Was die Zeitung berichtete
Bei 110 komplexen Aufgaben lag selbst die beste vollständige Erfolgsquote der getesteten Agenten unter 3 %. Fehler bei visuellen Aktionen konnten Ergebnisse trotz Teilfortschritten unbrauchbar machen.[R02]
Umfang der Ergebnisse und verbleibende Herausforderungen
Sie ist ein Ergebnis des Systems zum Zeitpunkt der spezifischen Herausforderung und des Experiments und stellt nicht eine Erfolgsquote für alle Agenten dar. Da wir tatsächliche Websites verwenden, werden die Auswertungen auch durch Änderungen in den Bildschirmen und Informationen beeinflusst.
Zum Beispiel:Auch wenn Sie suchen können, sind die Vergleichsmaterialien nicht vollständig.
Bei „Drei Kandidaten recherchieren und einen Vergleich mit Quellen erstellen“ reicht das Sammeln dreier Informationen nicht. Fehlende Vergleichskriterien oder unlesbarer Text verhindern einen fertigen Auftrag. Prüfe Informationsgewinn und nutzbares Ergebnis. Dies ist ein Erklärbeispiel, keine reproduzierte Studienaufgabe.
Übertragen auf AI Inc.
Dies gibt Ihnen einen Grund, die Leistung Ihres Modells zusammen mit den Lieferergebnissen zu überprüfen, die Ihre Kunden tatsächlich erhalten. Schauen wir uns auch die Ergebnisse der Nachveröffentlichungsversorgung und der Vorabversorgung an.
Langer Kontext: Von der Beibehaltung des Volltextes bis zum Entwerfen mit Gedächtnis
Um mit langen Texten umgehen zu können, ist es notwendig, die Fähigkeit, auf Informationen zu verweisen, mit der Belastung durch Berechnung und Gedächtnis in Einklang zu bringen. Die ARMT-Forschung integriert das wiederholt aktualisierte assoziative Gedächtnis in das Modell.
Um mit langen Texten umgehen zu können, ist es notwendig, die Fähigkeit, auf Informationen zu verweisen, mit der Belastung durch Berechnung und Gedächtnis in Einklang zu bringen. Die ARMT-Forschung integriert das wiederholt aktualisierte assoziative Gedächtnis in das Modell.
Lange Texte mit Abschnitten und Speicher verarbeiten
Die im vorherigen Abschnitt erhaltenen Informationen werden in den nächsten Abschnitt übernommen.
Links: Teil der Eingabe lesen
ARMT teilt lange Eingaben in Abschnitte und verarbeitet sie nacheinander mit den Informationen des jeweiligen Abschnitts.
Mitte: Internen Speicher aktualisieren
Es verwendet Darstellungen dessen, was es gelesen hat, um den assoziativen Speicher im Modell zu aktualisieren. Der Kartenhalter ist eine Metapher dafür, wie es funktioniert.
Rechts: Im nächsten Trennzeichen verwenden
Bei der Verarbeitung der nächsten Eingabe wird auch auf den vom vorherigen Trennzeichen geerbten Speicher verwiesen. Wiederholen Sie diesen Vorgang, um lange Sätze zu verarbeiten.
Es besteht ein Unterschied zwischen der Beibehaltung des gesamten Textes und der Weitergabe der Informationen an den internen Speicher. Überprüfen Sie auch die maximale Länge und die Fähigkeit, die erforderlichen Informationen richtig zu verwenden.
Die Materialien und Kartenhalter sind illustrative Metaphern und kein Diagramm der inneren Struktur des Papiers. Das tatsächliche Gedächtnis wird numerisch ausgedrückt und unterscheidet sich von einer Zusammenfassung eines Textes oder einer vollständigen Erhaltung des Originaltextes. Es bedeutet nicht, dass die App in der Lage ist, Gespräche oder die Ausführung des Spiels dauerhaft zu speichern.
Abschnitte einlesen und in den internen Speicher übernehmen
ARMT verarbeitet Eingaben abschnittsweise und aktualisiert dabei ein assoziatives Gedächtnis für den nächsten Abschnitt. Dieses interne numerische Gedächtnis speichert weder den vollständigen Originaltext noch eine textuelle Zusammenfassung.
Nicht nur die Obergrenze der Länge, sondern ob sie tatsächlich genutzt werden kann?
Diese Forschung berücksichtigt zusätzliches Lernen, um lange Eingaben und die Auswahl von Schichten, die Speicher beinhalten, zu berücksichtigen. Unterscheiden Sie zwischen der Länge der Informationen und der Fähigkeit, anhand entfernter Informationen richtig zu antworten.
Was die Zeitung berichtete
Wir erstellen für jedes Feld Langtextdaten und werten Eingaben aus, die die Kontextobergrenze des ursprünglichen Modells überschreiten, sowie Eingaben, die länger sind als während des Trainings. Selbst innerhalb des ursprünglichen Längenbereichs berichten wir über Ergebnisse, die den Rechenaufwand reduzieren und gleichzeitig die Leistung beibehalten.[R03]
Umfang der Ergebnisse und verbleibende Herausforderungen
Das experimentelle Ziel ist ein relativ kleines Modell mit maximal 1B Parametern. Aus diesem Ergebnis allein lässt sich nicht beurteilen, ob der gleiche Effekt in einem größeren Modell oder in einem anderen Bereich erzielt werden kann.
Zum Beispiel:Verbindung der ersten und zweiten Hälfte eines langen Berichts
Betrachten Sie einen Bericht, der die Planbedingungen in der ersten Hälfte und die Ergebnisse in der zweiten Hälfte enthält. Wenn Sie beim Lesen der zweiten Hälfte die Informationen aus dem vorherigen Abschnitt verwenden können, können Sie diese auf der Grundlage beider verarbeiten. Es muss jedoch geprüft werden, ob alle Bedingungen korrekt übernommen werden können. Dies ist ein Beispiel dafür, wie es verwendet wird, und das Papier garantiert nicht den Erfolg dieses Berichts.
Übertragen auf AI Inc.
Dies wird Ihnen helfen, über den Unterschied zwischen Forschung, die nur die Leistung verbessert, und Forschung, die die gleiche Aufgabe mit weniger Ressourcen erledigt, nachzudenken. Der Maßstab des Spielmodells oder die Ressourcenwerte werden nicht in die Werte im Papier umgewandelt.
Effizienz: Erstellen Sie zuerst Kandidaten und überprüfen Sie sie alle auf einmal.
Spekulative Dekodierung ist eine Methode zur Erstellung zukünftiger Token-Kandidaten mithilfe einfacher Berechnungen und deren Überprüfung mit dem Zielmodell. Neuere Forschungen haben den Bearbeitungsplan für jede Anfrage und das Erlernen von Modellen verbessert, die Kandidaten generieren.
Spekulative Dekodierung ist eine Methode zur Erstellung zukünftiger Token-Kandidaten mithilfe einfacher Berechnungen und deren Überprüfung mit dem Zielmodell. Neuere Forschungen haben den Bearbeitungsplan für jede Anfrage und das Erlernen von Modellen verbessert, die Kandidaten generieren.
Stellen Sie zunächst Kandidaten zusammen und prüfen Sie den Umfang der Rekrutierung
Kombiniert Kandidatenerstellung und -validierung, um eine Fortsetzung der Antwort zu generieren.
Links: Erstellen Sie zukünftige Kandidaten
Erstellen Sie zunächst mit einfachen Berechnungen mehrere Token-Kandidaten. ASPIRE erstellt Kandidaten, indem es die Kontexte einschränkt, auf die dasselbe Modell verweist.
Mitte: Mit Zielmodell überprüfen
ASPIRE prüft Kandidaten gemeinsam unter Berücksichtigung des vollständigen Kontexts und bestimmt, wie weit sie vom Anfang an angenommen werden können.
Rechts: Die übernommene Fortsetzung hinzufügen
Fügen Sie den akzeptierten ersten Teil und das nächste vom Prüfer ermittelte Token hinzu. Wir werden die verbleibenden Kandidaten, die nicht angenommen wurden, entfernen und einen neuen Kandidaten erstellen.
Bei der Verifizierung wird hier überprüft, ob es mit der Generierung des Zielmodells übereinstimmt. Hierbei handelt es sich nicht um die Prüfung, ob der Inhalt den Tatsachen entspricht. Die Effizienz variiert je nach Auswahl der angenommenen Kandidaten und Bearbeitungsbedingungen.
Ein Stück Papier ist eine Metapher für ein Zeichen und passt nicht unbedingt zu einem Wort. Die drei Szenen stellen Verarbeitungsstadien dar und die Unterschiede in den Zahlen geben keinen Aufschluss über die Anzahl der Modelle. Dieses Diagramm gibt nicht die asynchrone Verarbeitung, die interne Struktur oder die Spielvorgänge von ASPIRE wieder.
Die Verifizierung unterscheidet sich von der Faktenprüfung
Dieser Prozess prüft, ob es mit der Generierung des Zielmodells übereinstimmt und übernimmt den akzeptablen führenden Teil. ASPIRE verwendet dasselbe Modell, um Kandidaten in einigen Kontexten zu generieren und sie dann in allen Kontexten zu validieren. Eine andere Möglichkeit besteht darin, ein anderes, leichteres Modell zu verwenden. Auch wenn der Text die Prüfung bestanden hat, prüfen wir die sachliche Untermauerung gesondert.
Verbessern Sie die Prozessausrichtung und die Kandidatenqualität
ASPIRE lässt mehrere Anfragen Entwurf und Prüfung unabhängig takten. Eine weitere Arbeit gewinnt bisher ungenutzte Trainingssignale aus vorhandenen Daten zurück, um besser akzeptierte Kandidaten zu erzeugen.
Was die Zeitung berichtete
ASPIRE berichtet bei drei Modellen und fünf Auswertungen höheren Decoding-Durchsatz als gewöhnliche sequenzielle Generierung. Forschung zum Entwurfsmodell berichtet längere akzeptierte Kandidatenfolgen.[R04][R05]
Umfang der Ergebnisse und verbleibende Herausforderungen
Die Verbesserungsrate des Durchsatzes kann nicht direkt in die Verbesserungsrate der Wartezeit für eine einzelne Antwort oder der Nutzungsgebühr übersetzt werden. Sie müssen die Bedingungen wie Modell, Ausrüstung, Anzahl der gleichzeitigen Verarbeitung, Kandidatenakzeptanzrate, Generierungsmethode usw. lesen.
Zum Beispiel:Wenn die ersten zwei von vier Kandidaten angenommen werden
Nehmen wir an, Sie erstellen vier Token-Kandidaten und die ersten beiden werden während der Validierung akzeptiert. Fügen Sie diese beiden und den nächsten vom Prüfer ermittelten Token zur Fortsetzung hinzu und entfernen Sie die verbleibenden Kandidaten. In einigen Fällen müssen wir möglicherweise alle Kandidaten neu erstellen. Die Zahlen 4 und 2 dienen der Erläuterung und geben keinen Hinweis auf feste Einstellungen oder die Leistung der Arbeit.
Übertragen auf AI Inc.
Als Reaktion auf Versorgungsengpässe können sowohl die Aufstockung der Ausrüstung als auch die Verbesserung der Effizienz erfolgen. Die Geschwindigkeitssteigerung bei Veröffentlichungen lässt sich nicht direkt auf das Angebot an Spielen übertragen.
Multimodal: Nutzen Sie fundierte Beweise, bevor Sie nachdenken?
Sogar KI, die Audio empfängt, reagiert möglicherweise mit Hinweisen aus dem Text, anstatt tatsächliche Audioinformationen zu verwenden. PG-TTRL berücksichtigt verstärkendes Lernen während der Inferenz mit einem Schwerpunkt auf der Verwendung fundierter Beweise.
Sogar KI, die Audio empfängt, reagiert möglicherweise mit Hinweisen aus dem Text, anstatt tatsächliche Audioinformationen zu verwenden. PG-TTRL berücksichtigt verstärkendes Lernen während der Inferenz mit einem Schwerpunkt auf der Verwendung fundierter Beweise.
Fragen lesen und auf Geräusche stützen
Selbst wenn die Frage dieselbe ist, ändert sich die Antwort je nach dem Geräusch, das Sie tatsächlich hören.
Links: Antworten Sie ausschließlich mit Texthinweisen
Hierbei ziehen Sie Schlussfolgerungen basierend auf dem Wortlaut der Frage oder den gemeinsamen Antworten. Selbst wenn Sie Ihre Stimme eingeben können, ist dies keine Garantie dafür, dass Ihre Antworten auf echten Geräuschen basieren.
Rechts: Auch fundierte Informationen dienen als Beweismittel
Nutzen Sie die Eigenschaften der Stimmen und Geräusche, die Sie hören, in Verbindung mit den Fragen. Die Forschung wird Bedingungen, unter denen Menschen auf fundierte Informationen zugreifen können, mit Bedingungen vergleichen, unter denen diese eingeschränkt sind, und untersuchen, inwieweit sich dies auf Antworten auswirkt.
Wir stellen sicher, dass wir auf die Eingaben reagieren, auf den Eingaben aufbauen und zur richtigen Antwort gelangen. Auch wenn die Antwort vom Klang abhängt, ist sie nicht unbedingt die richtige Antwort.
Kopfhörer sind eine Metapher für die unterschiedliche Nutzung von Klanginformationen. In der Arbeit erfolgt der Vergleich unter eingeschränkter Bezugnahme auf interne Audioinformationen, und das Diagramm gibt den Vorgang beim Abnehmen der Kopfhörer nicht wieder. Es gibt keinen Hinweis auf den Lernvorgang von PG-TTRL oder die Funktionsweise des Spiels.
Auf Eingaben reagieren und diese auf Eingaben basieren
Diese Studie analysiert, wie sehr sich das Modell auf Geräusche verlässt, um Schlussfolgerungen zu ziehen, und bezieht diese Informationen in die Bewertung des Lernens ein. Allein das lange Nachdenken über Sätze wird Ihre Hörprobleme nicht unbedingt lösen.
Was die Zeitung berichtete
Die Auswertung mit zwei Audio-Sprachmodellen auf MMAR und MMAU berichtet Verbesserungen gegenüber Basismodellen und gewöhnlichem Reinforcement Learning zur Inferenzzeit.[R06]
Umfang der Ergebnisse und verbleibende Herausforderungen
Dabei handelt es sich um eine Forschungstechnik, die das Modell tatsächlich aktualisiert. Dies ist keine Erklärung dafür, dass der normale Chat automatisch zusätzliche Informationen erfährt. Es zeigt nicht die Auswirkung auf alle Töne, Sprachen, Bilder und Videos an.
Zum Beispiel:Hören Sie verschiedene Töne für dieselbe Frage
Stellen Sie sich eine Situation vor, in der Sie das Kind fragen: „Welche Geräusche hören Sie?“ und gib ihnen das Geräusch des Regens und den Klang des Applauses. Auch wenn die Fragen den gleichen Text haben, erfordert die Antwort einen tatsächlichen Klangunterschied. Dieses Beispiel dient nur zur Veranschaulichung und ist keine separate Aufsatzaufgabe. Der Artikel untersucht den Einfluss von Ton auf Antworten, indem er Bedingungen, die den internen Verweis auf Audioinformationen einschränken, mit normalen Bedingungen vergleicht.
Übertragen auf AI Inc.
Beurteilen Sie den Antrag nicht allein aufgrund des Marktnamens; Es hilft Ihnen dabei, über die Eingabe- und Bewertungsbedingungen nachzudenken, die Ihre Kunden benötigen. Bitte unterscheiden Sie zwischen den Lernmethoden, die in der Forschung eingesetzt werden, und den Operationen von Spielen.
Weltmodelle: Von der Vorhersage des nächsten Schritts zur Stabilität in langfristigen Entwicklungen
Ein Weltmodell ist ein Modell zur Vorhersage des Zustands der Umwelt und der Ergebnisse von Handlungen. Selbst wenn Sie Ihren nächsten Schritt genau vorhersagen können, kann die Wiederholung Ihrer Vorhersagen im Laufe der Zeit von der Realität abweichen.
Ein Weltmodell ist ein Modell zur Vorhersage des Zustands der Umwelt und der Ergebnisse von Handlungen. Selbst wenn Sie Ihren nächsten Schritt genau vorhersagen können, kann die Wiederholung Ihrer Vorhersagen im Laufe der Zeit von der Realität abweichen.
Sagen Sie einen Schritt voraus und wiederholen Sie den nächsten Schritt
Verwenden Sie den vorhergesagten Zustand als nächste Eingabe, um eine lange Erweiterung zu erstellen.
Links: Denken Sie über Ihren aktuellen Zustand und Ihre Aktionen nach
Wenn es sich um ein Modellauto handelt, sind die Anhaltspunkte seine aktuelle Position und Ausrichtung sowie die Art und Weise, wie man es bewegt. Weltmodelle sagen den nächsten Zustand basierend auf Zuständen und Aktionen voraus.
Mitte: Erneutes Vorhersagen des vorhergesagten Ziels
Verwenden Sie den vorhergesagten Zustand als nächste Eingabe, um fortzufahren. Diese wiederholte Vorhersage wird als Rollout bezeichnet.
Rechts: Sehen Sie sich die Verteilung bei längerer Wiederholung an
Wir untersuchen die Tendenz und Verbreitung, welche Erkrankungen wie oft auftreten. Dies ist die Verteilung der Staaten. Auch wenn es einen Schritt voraus ist, heißt das nicht zwangsläufig, dass diese Eigenschaft über einen langen Zeitraum erhalten bleibt.
Ob eine Schrittgenauigkeit, eine langfristige Bereitstellungsverteilung und Planung nützlich sind, ist eine andere Bewertung. Selbst wenn die Verteilung stabil ist, ist dies keine Garantie für die Richtigkeit einzelner Vorhersagen oder Aktionspläne.
Das Modellauto und die Tafel sind illustrative Metaphern und stellen nicht das Kontrollproblem im Papier oder die Verteilung innerhalb des Modells dar. Nur weil sich das Auto innerhalb des Boards befindet, ist das kein Beweis für die Stabilität. Die vielen Autos stellen eine Szene dar, in der wir über den zukünftigen Zustand nachdenken, und zeigen keine genauen Vorhersagen oder wie AI Inc. die Stadt betreibt.
Messung der Eigenschaften wiederholter Vorhersagen
In dieser Studie entwerfen wir das Modell, um eine konstante Verteilung interner Zustände aufrechtzuerhalten und die Stabilität langer Bereitstellungen zu untersuchen. Die Idee besteht darin, die Genauigkeit kurzer Vorhersagen, die Verteilung langer Erweiterungen und die Wirksamkeit der Planung separat zu bewerten.
Was die Zeitung berichtete
Bei zwölf Steuerungsaufgaben blieb die untersuchte Verteilung auch über wiederholte lange Vorhersagen erhalten. Bei kurzen Vorhersagehorizonten schnitten andere Vergleichsmodelle teilweise besser ab.[R07]
Umfang der Ergebnisse und verbleibende Herausforderungen
Es hängt von den theoretischen Voraussetzungen und der Bandbreite der erlernten Umgebung und Verhaltensweisen ab. Nur weil die Verteilung stabil ist, bedeutet das nicht, dass wir die reale Welt genau reproduzieren oder einen guten Aktionsplan erstellen können.
Zum Beispiel:Der nächste Stand des Modellautos und seine lange Entwicklung
Prognostiziert den nächsten Zustand des Modellautos basierend auf seiner aktuellen Position, Richtung und Bewegung. Wenn Sie diese Vorhersage erneut als Eingabe verwenden, können Sie zukünftige Entwicklungen erstellen, ohne das eigentliche Objekt jedes Mal verschieben zu müssen. Nur weil ein Schritt nah ist, kann jedoch nicht gesagt werden, dass die Voreingenommenheit und Ausbreitung des Staates nach wiederholten Operationen aufrechterhalten werden kann. Bei langen Vorhersagen kann die Verteilung auch dann beibehalten werden, wenn die Trajektorien unterschiedlich sind, und Beurteilungen werden nicht nur auf der Grundlage der Übereinstimmung von Positionen getroffen. Das Modellauto dient nur der Veranschaulichung und gibt nicht die experimentellen Aufgaben in der Arbeit wieder.
Übertragen auf AI Inc.
Dies führt zu einer Denkweise, die kurzfristige Prognosen von langfristigen Geschäftsergebnissen trennt. Dies bedeutet nicht, dass die Stadt- und Managementsimulationen von AI Inc. auf diesem Weltmodell basieren.
Zuverlässigkeit: Finden Sie heraus, warum Sie es nicht nur wissen, sondern auch, warum Sie falsch liegen, selbst wenn Sie es wissen
Falsche Antworten entstehen nicht nur, wenn das nötige Wissen fehlt. In dieser Studie wird untersucht, wie die Wörter in einer Frage und die gelernten Zusammenhänge miteinander konkurrieren und dazu führen, dass falsche Antworten gewählt werden.
Falsche Antworten entstehen nicht nur, wenn das nötige Wissen fehlt. In dieser Studie wird untersucht, wie die Wörter in einer Frage und die gelernten Zusammenhänge miteinander konkurrieren und dazu führen, dass falsche Antworten gewählt werden.
Entfernen Sie einige Fragen und vergleichen Sie die Änderungen in den Antworten
Selbst wenn Sie über das nötige Wissen verfügen, kann es zu Konflikten zwischen der Formulierung der Frage und den Zusammenhängen kommen, die Sie aus Ihrem Lernprozess gezogen haben.
Trennen Sie die zu ändernden Teile und die zu verlassenden Bedingungen
Illustrative Prämisse: Person A ist Pianist, Person B ist Maler. Angenommen, wir leben beide in Tokio.
- ursprüngliche Frage
- Wer ist der Pianist, der in Tokio lebt?
- Fragen ohne geteilte Informationen
- Wer ist der Pianist?
Unter dieser Annahme lautet die Antwort auf beide Fragen Person A. Selbst wenn Sie Informationen zu Orten entfernen, die beiden Personen gemeinsam sind, ändert sich das Ziel der Frage nicht. Die Forschung wird die Veränderungen in den Antworten und den Grad der Wahrscheinlichkeit untersuchen, in dem Kandidaten ausgewählt werden, wenn die Eingabewörter geändert werden.
Die Erklärung verwendet eine fiktive Person und gibt keinen Hinweis auf die einzelnen Fragen in der Arbeit, tatsächliche Antworten oder interne Wahrscheinlichkeiten. Nur weil sich die Antwort geändert hat, heißt das nicht, dass es sich um eine falsche Antwort handelt.
Links: Untersuchung des Einflusses von Wörtern in der ursprünglichen Frage
Nachdem wir die ursprüngliche Antwort erhalten haben, untersuchen wir, welche Wörter einen starken Einfluss auf die Wahrscheinlichkeit haben, dass eine mögliche Antwort ausgewählt wird. Das blaue Blatt Papier ist eine Metapher für einen Teil der Frage.
Mitte: Entfernen Sie das ausgewählte Wort und suchen Sie es erneut.
Entfernen Sie die einflussreichsten Teile und untersuchen Sie den Einfluss der verbleibenden Wörter erneut. Hierbei handelt es sich um einen Vergleich, der auf Eingabeeingriffen und nicht auf einem Neulernvorgang basiert.
Rechts: Vergleich der Veränderungen bei der Unterstützung von Kandidaten
Änderungen in der Wahrscheinlichkeit von Antworten und Kandidaten werden als Anhaltspunkte für die Suche nach falschen Antworten verwendet. Auch wenn die Antwort richtig ist, kann sich das Ergebnis ändern, wenn wichtige Wörter weggelassen werden.
Nur weil ein Wort eine große Wirkung hat, heißt das nicht, dass es eine falsche Antwort ist. Es gibt auch andere Ursachen, beispielsweise mangelndes Wissen. Es ist keine Methode, die Ihnen die richtige Antwort gibt, wenn Sie die Wörter weglassen.
Die Darstellung des Entfernens des Blattes Papier ist eine Metapher, die den Wortlaut der Frage verändert. Hierbei handelt es sich nicht um ein Diagramm, das den in der Arbeit durchgeführten internen Eingriff oder die zweistufige Berechnung direkt wiedergibt. Sie stellen nicht die tatsächlichen Antworten, Wahrscheinlichkeiten, Erkennungserfolge oder Abläufe von AI Inc. dar.
Ändern Sie einen Teil der Frage und sehen Sie, wie sich die Antwort ändert
Beobachten Sie Änderungen in der Ausgabe, indem Sie Schlüsselwörter entfernen, die eine starke Auswirkung haben. Die Zielsetzung besteht darin, mangelndes Wissen, falsches Wissen, kontextbedingte Störungen und instabiles Denken zu trennen und zu untersuchen.
Was die Zeitung berichtete
Wir haben Ergebnisse gemeldet, bei denen sich ändernde Schlüsselwörter als Anhaltspunkt für die Erkennung falscher Antworten in mehreren Modellen und Aufgaben verwendet werden können. Allerdings zeigt sich auch, dass Kombinationen mit anderen Erkennungssignalen nicht immer zu einer Verbesserung führen.[R08]
Umfang der Ergebnisse und verbleibende Herausforderungen
Die Hauptmethode verwendet Token-Wahrscheinlichkeiten und ist so konzipiert, dass sie leicht auf Modelle mit offener Gewichtung angewendet werden kann. Es wurde nicht überprüft, ob ein Dienst, der keinen Zugriff auf interne Informationen ermöglicht, ähnliche Erkennungen durchführen oder den Mechanismus hinter allen falschen Antworten erklären kann.
Zum Beispiel:Standortinformationen und Bedingungen zur Identifizierung von Personen
In dem in der Abbildung gezeigten Satzbeispiel bleibt die Bedingung für die Frage nach dem Pianisten bestehen, auch wenn man das für beide Personen gemeinsame Wort „Tokio“ entfernt. Wenn Sie hingegen „Pianist“ entfernen und „Wer lebt in Tokio?“ verwenden, stimmen beide Personen überein und die Bedeutung der Frage ändert sich. Sie müssen die Änderungen in den Ergebnissen sowie die geänderten Informationen lesen. Bei diesem Beispiel handelt es sich nicht um eine Forschungsfrage oder eine tatsächliche Messung der Antworten des Modells.
Übertragen auf AI Inc.
Dies führt zu dem Grund, den Bewertungsumfang speziell zu lesen. Betrachten Sie die Leistung einer einzelnen Fehlantworterkennung nicht als Garantie für die Sicherheit des gesamten Modells.
Bewertung: Untersuchen Sie nicht nur die Punktzahl, sondern auch das Punktesystem
Beurteilungen, die es Agenten ermöglichen, ihre Arbeitsumgebung zu ändern, können sich auf die Ergebnisse auswirken, ohne den Auftrag abzuschließen. BenchShield überprüft die Belohnungsintegrität anhand der Bewertungsumgebung und der Ausführungsaufzeichnungen.
Beurteilungen, die es Agenten ermöglichen, ihre Arbeitsumgebung zu ändern, können sich auf die Ergebnisse auswirken, ohne den Auftrag abzuschließen. BenchShield überprüft die Belohnungsintegrität anhand der Bewertungsumgebung und der Ausführungsaufzeichnungen.
Sehen Sie sich die Bewertungsergebnisse und die Grundlage für die Bewertung an
Überprüfen Sie nicht nur, wie viele Punkte Sie erhalten haben, sondern auch, welche Leistungen und Beiträge bewertet wurden.
Links: Sehen Sie sich die letzten Bewertungsergebnisse an
Das Endergebnis dient als Anhaltspunkt für den Vergleich der Ergebnisse. Allerdings sagt die Bewertung allein nicht aus, ob die Bewertung durch das Erledigen der Aufgabe erreicht wurde oder ob es andere Änderungen gab, die sich auf die Bewertung ausgewirkt haben.
Rechts: Nachverfolgung von Ergebnissen, Bewertung von Eingaben und Aufzeichnungen
Sehen Sie, welche Artefakte und Werte bewertet wurden und was sich dabei geändert hat. BenchShield nutzt Erkenntnisse aus der Evaluierungsinfrastruktur, um den tatsächlichen Betrieb mit den Auswirkungen der Evaluierung zu verknüpfen.
Eine Aufgabe zu lösen ist eine Sache, die gemessene Punktzahl zu beeinflussen eine andere. Wir prüfen auch die Beweise, um zwischen dem Vorhandensein einer Lücke und der Tatsache, dass sie bei der Ausführung genutzt wurde, zu unterscheiden.
Das Papier und die Mappe sind eine illustrative Metapher und stellen nicht den eigentlichen Bewertungsbildschirm oder das Betrugsverfahren dar. Die linke Seite bedeutet nicht immer eine falsche Auswertung und die rechte Seite bedeutet nicht immer eine erfolgreiche Erkennung. BenchShield erfordert eine Messung der Evaluierungsplattform und ist keine Methode, die einfach durch den Vergleich von Papier reproduziert werden kann.
Finden Sie heraus, warum Sie eine hohe Punktzahl erreicht haben
Untersuchen Sie die zu erbringenden Leistungen, die für die Bewertung verwendeten Informationen und den Bewertungsprozess. Diese Studie unterscheidet zwischen korrektem Erledigen von Aufgaben und Belohnungshacking, das Bewertungslücken ausnutzt.
Was die Zeitung berichtete
Drei Agenten-Evaluationsplattformen werden mit statischen Kontrollen und Laufzeitprotokollen untersucht. Verglichen werden Prüfungen allein anhand von Gesprächen und Prüfungen mit Belegen der Plattform.[R09]
Umfang der Ergebnisse und verbleibende Herausforderungen
Es ist notwendig, die Messung in die Bewertungsumgebung einzubeziehen, und diese Methode kann nicht in jeder Umgebung verwendet werden. Für Aufgaben mit unterschiedlichen Bewertungsverfahren und freier Erkundung ist eine Erweiterung des Designs erforderlich.
Zum Beispiel:Was passiert, wenn ich eine hohe Bewertung erhalte, obwohl die Übersichtstabelle nicht vollständig ist?
Erhält eine Tabelle zur Summe dreier Werte trotz fehlender Zeilen eine gute Note, prüfe Ergebnis, Bewertungsdaten und Änderungen. Unvollständiges Ergebnis, Bewertungsfehler und veränderte Bewertungsinformationen erfordern getrennte Belege. Fiktives Beispiel, kein Nachweis realen Betrugs oder einer Studienaufgabe.
Übertragen auf AI Inc.
Dies führt zu der Idee, zu überprüfen, unter welchen Bedingungen hohe Bewertungswerte erzielt wurden. Bei der Bestimmung der Offenlegung/Befugnis werden der Umfang der Bewertung und die erforderlichen Überwachungsbedingungen zusammen gelesen.
Autoritätsdesign: Der Unterschied zwischen erfolgreicher Arbeit und nicht mehr als nötig operieren
Selbst wenn Sie sich für ein praktisches Tool entscheiden, kann es sein, dass das Tool den für die Anfrage erforderlichen Umfang überschreitet. FORTIS bewertet Fähigkeiten und Werkzeugauswahl, um die geringsten Privilegien zu schützen.
Selbst wenn Sie sich für ein praktisches Tool entscheiden, kann es sein, dass das Tool den für die Anfrage erforderlichen Umfang überschreitet. FORTIS bewertet Fähigkeiten und Werkzeugauswahl, um die geringsten Privilegien zu schützen.
Notwendiger Anforderungsbereich und zu weitreichende Befugnisse
Auch wenn Sie den gleichen Wunsch erfüllen können, ist die Palette der zu bearbeitenden Werkzeuge unterschiedlich.
Links: Nur das Zielmaterial lesen
Für „Fasse diese Datei zusammen“ kann Leseberechtigung genügen. Andere Dateien verändern zu dürfen ist dafür nicht erforderlich.
Rechts: Auch andere Materialien können geändert werden.
Selbst wenn Sie dasselbe Material lesen können, haben Tools, die andere Dateien ändern oder löschen können, einen größeren Anwendungsbereich. Überprüfen Sie, ob Sie aufgrund einer praktischen Erklärung mehr Berechtigungen als nötig auswählen.
Weitere Bewertungskriterien sind die Fähigkeit zur Bewältigung der Aufgabe und die Fähigkeit, bedarfsgerechte Werkzeuge auszuwählen. Überprüfen Sie sowohl die von Ihnen gewählten Fähigkeiten als auch die Werkzeuge, die Sie dabei verwenden werden.
Akten und Bürowerkzeuge sind Metaphern für den Umfang der Autorität. Die Szene auf der rechten Seite ist ein Zustand, in dem eine Vielzahl von Vorgängen ausgeführt werden können, und es ist nicht die Szene, die tatsächlich geändert oder gelöscht wird. FORTIS wertet Auswahlen anhand konfigurierter Kompetenzhierarchien aus und stellt keine Vorgänge dar, die in realen Diensten auftreten.
Wählen Sie selbst bei Routineanfragen übermäßige Autorität?
Wir werden untersuchen, ob sich Entscheidungen nicht nur durch aggressive Anweisungen ändern, sondern auch durch vage Aufforderungen und Erklärungen, die die Bequemlichkeit betonen. Neben der Erfolgsquote des Modells wird auch gemessen, ob das Modell im erforderlichen Betriebsbereich liegt.
Was die Zeitung berichtete
Wir haben ein Problem gemeldet, bei dem Fähigkeiten und Tools mit umfassenderen Berechtigungen als nötig in drei Bereichen ausgewählt wurden: E-Mail, Versandhandel und Dateivorgänge. Dies zeigt eine Bewertungsachse, die sich davon unterscheidet, ob die Arbeit abgeschlossen werden kann.[R10]
Umfang der Ergebnisse und verbleibende Herausforderungen
Hierbei handelt es sich um eine Studie, die Entscheidungen anhand einer künstlich konstruierten Kompetenzhierarchie bewertet. Die Ergebnisse der Ausführung der Tools auf tatsächlichen externen Diensten oder der Validierung anhand des natürlichen Benutzerverlaufs sind nicht enthalten.
Zum Beispiel:Was eine Zusammenfassung einer Datei benötigt
Angenommen, Sie haben ein Tool, das die Zieldatei lesen kann, und ein Tool, das den gesamten Ordner bearbeiten/löschen kann. Wenn beide die Datei lesen können, reicht es nicht aus, die Aufgabe abschließen zu können, um zu beurteilen, ob Sie die entsprechenden Berechtigungen ausgewählt haben. Bestätigen Sie separat das Ziel und den Umfang der für die Anfrage erforderlichen Vorgänge. Dies ist kein Beispiel, das den tatsächlichen Diensteinstellungsbildschirm oder einzelne Aufgaben für eine Arbeit zeigt.
Übertragen auf AI Inc.
Selbst für veröffentlichte Modelle gibt es eine gesonderte Beurteilung, wie viel Verhalten erlaubt ist. Überprüfen Sie Ausführungsprivilegien und Aufsicht getrennt von der Modellleistung.
Referenzen10Treffer
Links direkt zum Original. Das Datum ist das Datum der ersten Veröffentlichung/Referenzversion von arXiv (UTC).
- [R01]
Planned Test-Time Scaling with Coordinated Reasoning Paths
- [R02]
The Hard Part Comes After Search: Benchmarking Web Agents on Synthesizing, Organizing, and Displaying Knowledge
- [R03]
Extending LLM Context via Associative Recurrent Memory
- [R04]
ASPIRE: Asynchronous Batched Self-Speculative Decoding for Long-Context LLM Inference
- [R05]
Recovering Off-Policy Supervision for Speculative Decoding
- [R06]
Listen Then Reason: Perception-Grounded Test-Time Reinforcement Learning for Large Audio-Language Models
- [R07]
World Models with Predictable Long-Horizon Marginals
- [R08]
When the Wrong Key Wins: Understanding and Detecting Hallucinations in LLMs
- [R09]
BenchShield: Formal Model-Backed Instrumentation for Reward Integrity in LLM-Agent Evaluation Infrastructure
- [R10]
FORTIS: Benchmarking Over-Privilege in Agent Skills
Glossar35
Grundbegriffe der KI und wissenschaftlicher Arbeiten kurz erklärt.
- neuronales Netzwerk
- Ein Modellmechanismus, der eingegebene numerische Werte mit erlernten Gewichten und Transformationen kombiniert und diese in Vorhersagen umwandelt.
- verborgene Schicht
- Schicht zwischen Ein- und Ausgabe eines neuronalen Netzes. Sie verändert die Darstellung der vorherigen Schicht und gibt sie weiter.
- Gewichte und Bias
- Werte, die beim Training angepasst werden. Gewichte bestimmen den Einfluss der Eingaben; der Bias verschiebt die gewichtete Summe.
- Aktivierungsfunktion
- Eine Funktion, die das Berechnungsergebnis eines Knotens transformiert. Zur Verarbeitung komplexer Zusammenhänge werden nichtlineare Transformationen wie ReLU verwendet.
- Verlust
- Ein Wert, der die Diskrepanz zwischen Vorhersage und Lernzielen mithilfe einer für den Zweck geeigneten Methode misst. Unterscheiden Sie es von der Leistung an unbekannten Beispielen.
- Backpropagation
- Verfahren, das die Berechnung von der Ausgabe rückwärts verfolgt, um die Ableitungen des Verlusts nach den einzelnen Parametern zu bestimmen.
- Lernrate
- Größe des Schritts zum Aktualisieren von Parametern. Es größer zu machen bedeutet nicht zwangsläufig, dass es schneller besser wird.
- Self-Attention
- Ein Mechanismus, der die Beziehungsverteilung aus dem Ausdruck jeder Position in derselben Spalte berechnet und die Wertinformationen mit Gewichtungen mischt.
- kausale Maske
- Eine Einschränkung, die Verweise auf zukünftige Token von jeder Position in einem satzgenerierenden Konstrukt aus verhindert.
- Skalierung während des Tests
- Eine Methode zur Verbesserung der Leistung, indem bei der Beantwortung nach dem Lernen Berechnungen der Anzahl der Versuche und Denkschritte zugeordnet werden. Vergleichen Sie Kosten und Wartezeiten.
- spekulative Dekodierung
- Eine Generierungsmethode, die den vorherigen Token-Kandidaten mithilfe einfacher Berechnungen erstellt und ihn mit dem Zielmodell überprüft. Die Auswirkungen variieren je nach Modell, Ausstattung, Akzeptanzrate der Kandidaten usw.
- KV-Cache
- Speichert Informationen für Attention und vermeidet wiederholte Berechnungen. Bei langen Kontexten beeinflusst dies auch den Speicherbedarf.
- Weltmodell
- Ein Modell, das den Zustand der Umwelt und das Ergebnis von Aktionen vorhersagt. Unterscheiden Sie zwischen der Genauigkeit der nächsten Schritte und der Wirksamkeit langfristiger Prognosen und Pläne.
- Belohnungs-Hacking
- Ausnutzen von Lücken im Punkte- und Belohnungssystem, um hohe Punktzahlen zu erzielen, ohne den ursprünglichen Zweck zu erreichen.
- Vordruck
- Wissenschaftliches Manuskript, das vor der Begutachtung durch eine Zeitschrift oder Konferenz veröffentlicht werden kann. Veröffentlichung bedeutet nicht Begutachtung oder Annahme.
- AI
- künstliche Intelligenz. Ein weit gefasster Begriff für Technologie, die Computer zur Erkennung, Vorhersage, Beurteilung usw. nutzt. Dazu gehören auch maschinelles Lernen und generative KI.
- Maschinelles Lernen (ML)
- Eine Methode zum Erlernen von Regelmäßigkeiten aus Daten und deren Verwendung zur Vorhersage, Klassifizierung und Generierung neuer Eingaben.
- tiefes Lernen
- Eine Methode des maschinellen Lernens, die neuronale Netze mit vielen Schichten nutzt. Auch Deep Learning genannt.
- Generation KI
- KI, die Inhalte wie Sätze, Bilder und Audio basierend auf erlernten Gesetzmäßigkeiten generiert.
- LLM
- Groß angelegte Sprachmodelle. Ein Modell, das aus großen Textmengen lernt und zur Textgenerierung, Zusammenfassung, Übersetzung usw. verwendet wird.
- Transformer
- Eine Architektur neuronaler Netze, die mit Attention Beziehungen zwischen Informationen verarbeitet. Sie wird in vielen LLMs eingesetzt.
- Parameter
- Numerische Werte innerhalb des Modells, die während des Trainings angepasst werden sollen. Nur weil es viele davon gibt, können Sie nicht beurteilen, ob sie für Ihren Zweck geeignet sind.
- Token
- Eine kleine Einheit, in der ein Modell Sätze usw. verarbeitet. Sie entspricht nicht der Anzahl der Zeichen oder Wörter, und die Unterteilung ändert sich je nach Modell und Sprache.
- Kontextfenster
- Obergrenze für die Länge der Informationen, die in einem Prozess referenziert werden können. Sie wird in der Regel in einer Anzahl von Token ausgedrückt, wobei die Handhabung der Obergrenze je nach Modell unterschiedlich ist.
- Vorläufiges Lernen
- Der Prozess des Erlernens der Regelmäßigkeiten, die die Grundlage eines Modells aus einer Vielzahl von Daten bilden.
- Feinabstimmung
- Anpassen eines trainierten Modells mit zusätzlichen Daten. Es unterscheidet sich vom Schreiben von Anweisungen und RAG dadurch, dass es Parameter aktualisiert.
- prompt
- An das Modell weitergegebene Anweisungen und Informationen. Es ändert normalerweise die Bedingungen für diese Antwort und nicht das zusätzliche Lernen des Modells selbst.
- RAG
- Generierung von Sucherweiterungen. Wie Sie nach dem benötigten Material suchen und das Gefundene an ein Modell weitergeben, um eine Antwort zu generieren.
- Einbetten
- Eine Methode, Merkmale von Sätzen usw. als Zahlenfolge auszudrücken. Sie können die Nähe von Inhalten für Suchen usw. nutzen.
- Halluzination
- Um Inhalte plausibel zu generieren, die nicht durch Fakten oder Materialien gestützt werden können. Quellen und Zahlen müssen überprüft werden.
- Maßstab
- Auswertung zum Vergleich der Leistung bei festen Aufgaben. Eine Evaluierung in tatsächlichen Kundenanwendungen ist ebenfalls erforderlich.
- multimodal
- Umgang mit mehreren Arten von Informationen wie Text, Bildern und Audio. Entsprechende Ein- und Ausgänge variieren je nach Modell.
- KI-Agent
- Ein System, das es Ihnen ermöglicht, Schritte in Richtung eines Ziels auszuwählen und mit der Arbeit mithilfe von Suchen, Tools usw. fortzufahren. Entscheiden Sie über die Tools, die Sie verwenden können, und über die Ausführungsberechtigungen.
- Latenz
- Wartezeit bis zur Antwort auf eine Anfrage. Sie kann getrennt bis zum ersten Zeichen und bis zur vollständigen Antwort gemessen werden.
- Durchsatz
- Die Anzahl der Anfragen und Token, die in einer bestimmten Zeit verarbeitet werden können. Dies ist eine von der Wartezeit für eine einzelne Anfrage getrennte Metrik.
Forschungsergebnisse sollten im Zusammenhang mit dem Zielmodell, den Aufgaben und den Versuchsbedingungen gelesen werden. Bitte überprüfen Sie die Referenzmaterialien für jeden Artikel, den Umfang der Ergebnisse und verbleibende Probleme.
Zum Anfang der Hilfe