Comprendre l’IA
Des bases de l’IA et des LLM à la recherche actuelle.
Catégories: 3 · Articles: 30 · Termes: 35
Recherchez dans « Comprendre l’IA ». Séparez les mots par des espaces pour trouver les articles qui les contiennent tous.
De ce que tu veux lire
Tous les sujets d’apprentissage
Articles: 30 · Termes: 35
Bases de l’IA et des LLM14
Comprenez recherche, entraînement et fourniture sans expérience en IA, grâce à des exemples concrets.
Cette catégorie concerne les connaissances de base de l’IA du monde réel. Les performances, le coût et le nombre de jours de jeu sont des expressions de la gestion du jeu. Les opérations associées peuvent être trouvées sous « Lire également » pour chaque élément.
Lire à partir d'illustrations
IA, apprentissage automatique et IA générative : quelles différences ?
L’IA regroupe les techniques informatiques de reconnaissance, prédiction ou décision. L’apprentissage automatique apprend des régularités dans les données ; l’IA générative produit notamment textes et images.
IA, apprentissage automatique et IA générative : quelles différences ?
L’IA regroupe les techniques informatiques de reconnaissance, prédiction ou décision. L’apprentissage automatique apprend des régularités dans les données ; l’IA générative produit notamment textes et images.
L’IA regroupe les techniques informatiques de reconnaissance, prédiction ou décision. L’apprentissage automatique apprend des régularités dans les données ; l’IA générative produit notamment textes et images.
IA, apprentissage automatique et IA générative
Même pour le même e-mail, les rôles de catégorisation et de création d’une réponse sont différents.
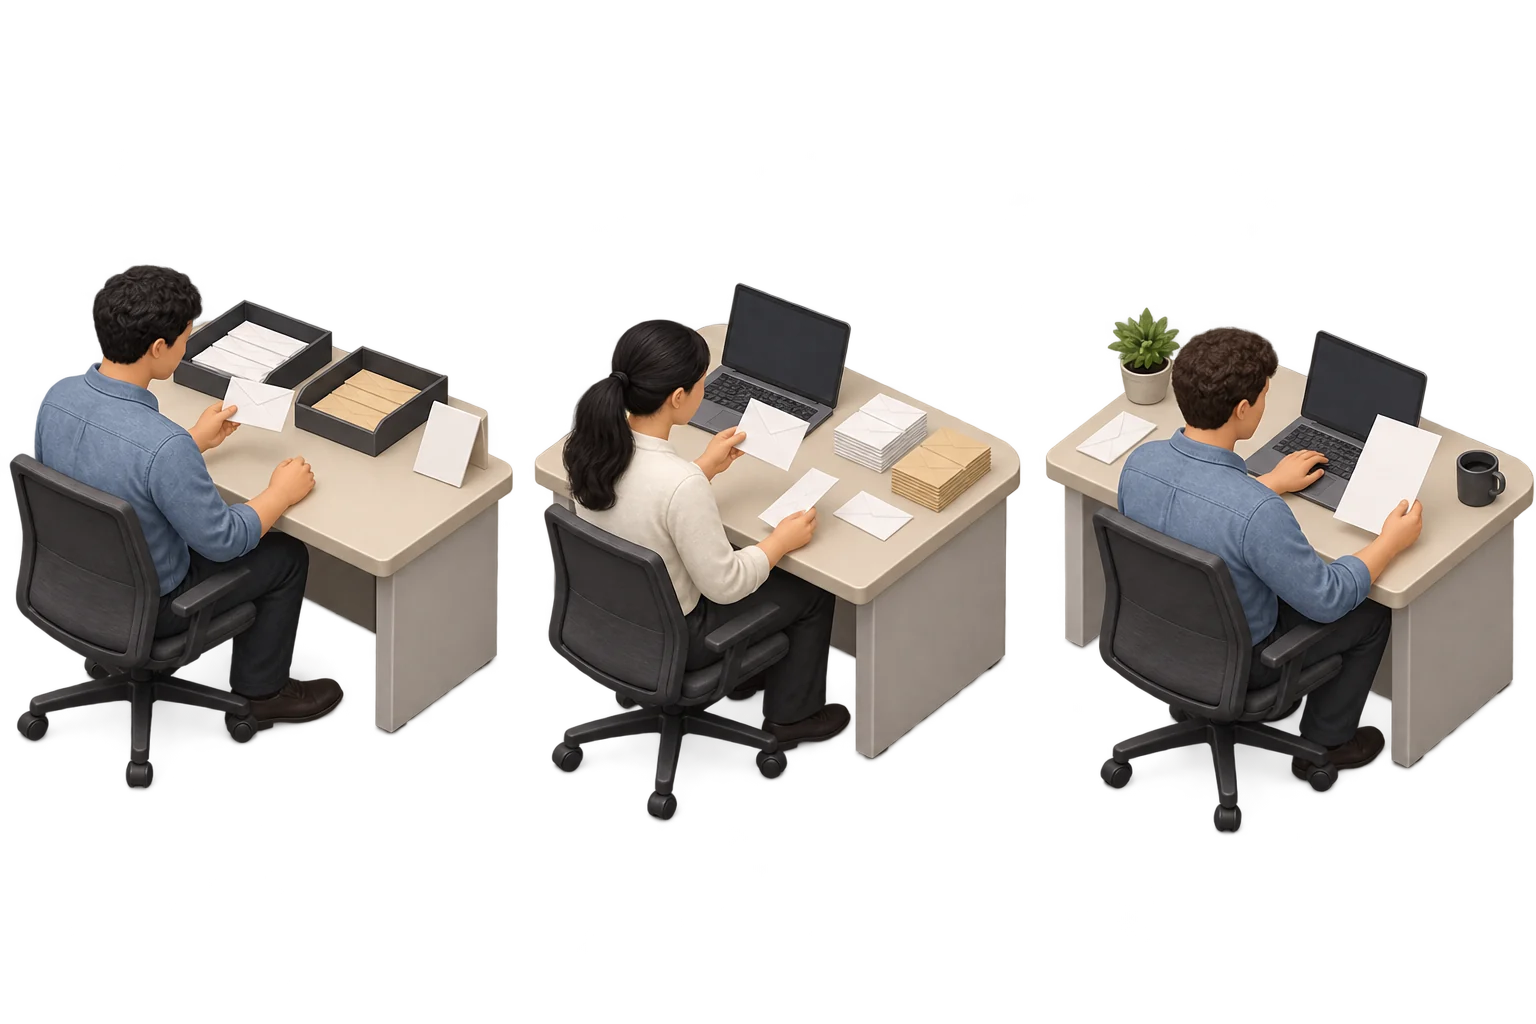
Gauche : Tri par règles
Triez les e-mails selon des conditions prédéterminées. L’IA dispose d’autres mécanismes que l’apprentissage à partir des données.
Centre : Apprentissage de la classification à partir d'exemples
Utilisez les e-mails classifiés et bien plus encore pour connaître les régularités et classer les nouveaux e-mails. Ceci est un exemple d’apprentissage automatique.
Droite : Créer une nouvelle réponse
Utilisez les régularités apprises pour générer des phrases qui correspondent aux instructions. Ceci est un exemple d’IA générative.
L’apprentissage automatique et l’IA générative sont tous deux inclus dans l’IA. L'apprentissage automatique est une méthode d'apprentissage et l'IA générative est le nom de l'IA qui crée du contenu. L'IA générative comme LLM est créée à l'aide de l'apprentissage automatique.
Il s'agit d'une illustration explicative qui a été remplacée par un bureau et du matériel.
L'apprentissage profond est un type d'apprentissage automatique
L’apprentissage profond combine de nombreuses couches d’un réseau neuronal et constitue notamment la base des LLM. Toutes les IA ne reposent pas sur cette méthode.
Vous pouvez lire le tableau en le déplaçant vers la gauche et la droite.
| mots | signification | exemple |
|---|---|---|
| AI | Tout l’art de faire un travail intellectuel. Cela comprend également des mécanismes qui fonctionnent selon des règles établies. | Adversaires du jeu, reconnaissance d'image |
| Apprentissage automatique (ML) | Apprenez les régularités de la prédiction et de la classification à l'aide d'exemples de données. | Classification des courriers indésirables, prévision des ventes |
| Génération IA | Générez du nouveau contenu en utilisant des régularités apprises. | Rédiger du texte, générer des images et du son |
Par exemple:Même email, mais rôles différents
"Déterminer s'il s'agit de spam" est une classification et "créer un texte de réponse" est une génération. Les entreprises d’IA choisissent leur technologie en fonction des tâches dont leurs clients ont besoin.
Dans AI Inc.
Lorsque vous choisissez un domaine d'études, pensez non seulement au nom de la technologie, mais également au type de travail que vous souhaitez que votre prochain modèle puisse effectuer.
Qu’est-ce qu’un LLM et comment produit-il du texte ?
LLM signifie grand modèle de langage. Il apprend des régularités à partir de nombreux textes pour générer, résumer ou traduire.
Qu’est-ce qu’un LLM et comment produit-il du texte ?
LLM signifie grand modèle de langage. Il apprend des régularités à partir de nombreux textes pour générer, résumer ou traduire.
LLM signifie grand modèle de langage. Il apprend des régularités à partir de nombreux textes pour générer, résumer ou traduire.
LLM : calculer la suite pour produire un texte
Calcule le prochain candidat à partir du contexte et continue.
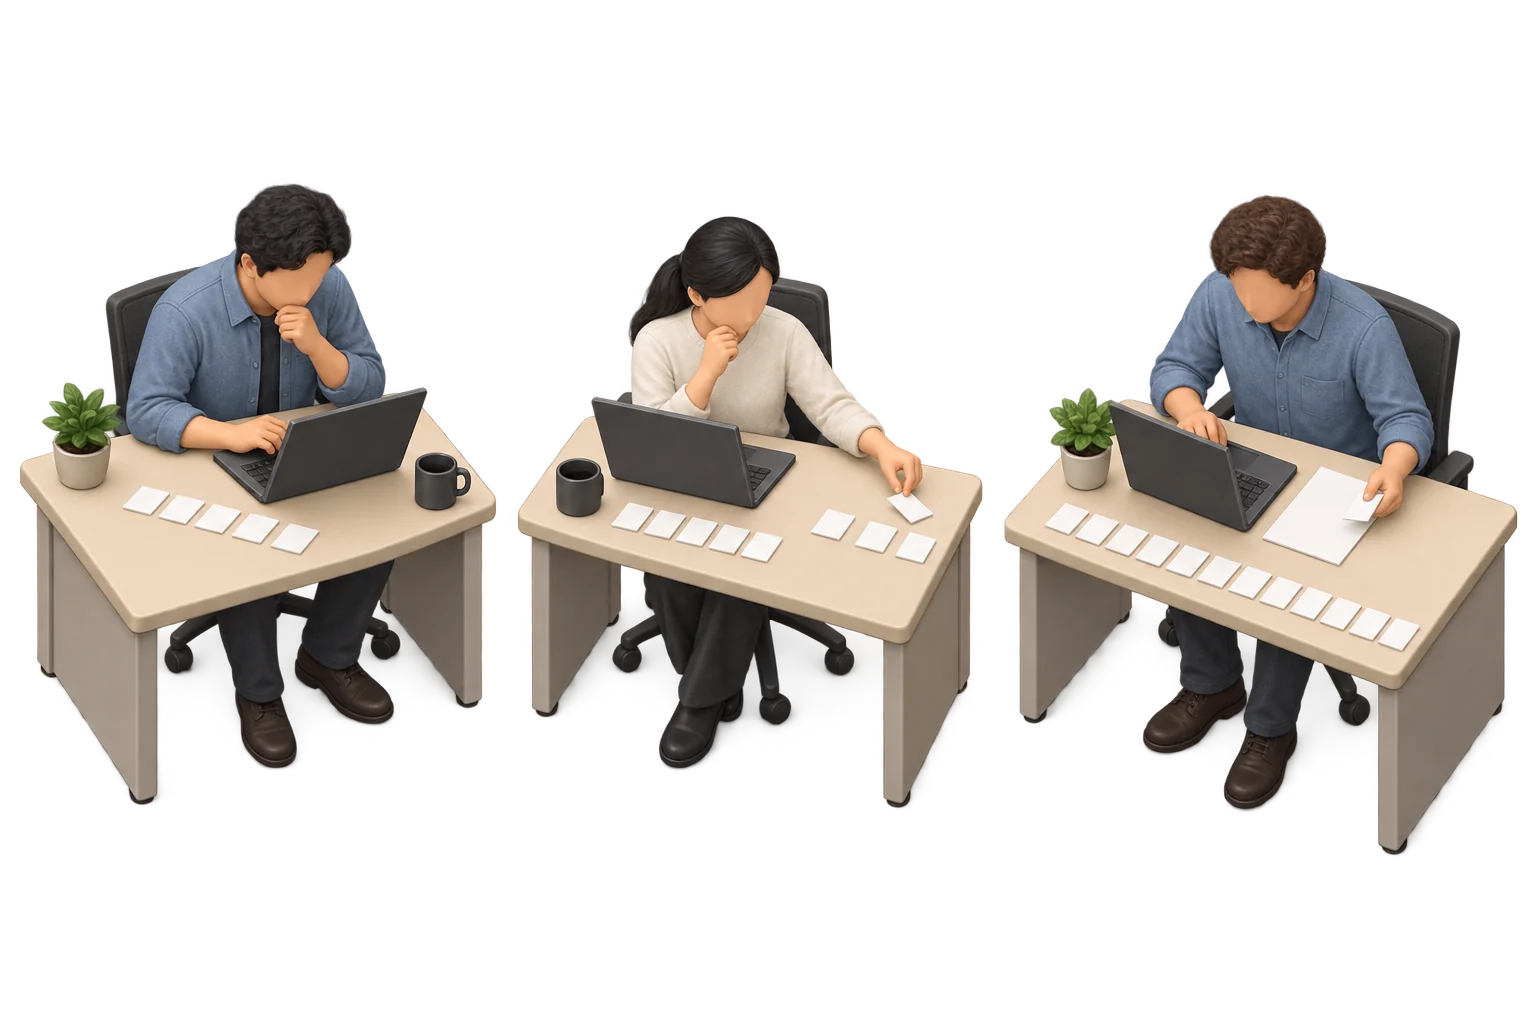
recevoir le contexte
Utilisez les instructions, les questions et le contenu généré précédemment.
Calculer la prochaine suggestion
Calculez le candidat et la probabilité du prochain jeton.
Écrivez une suite de la phrase
Répétez le processus de calcul du jeton suivant en utilisant le contenu nouvellement généré.
Un morceau de papier est une métaphore d’un jeton. Les jetons sont de petites unités de texte qui ne correspondent pas nécessairement aux mots. Il y a une différence entre le naturel du texte et l’exactitude des faits.
Il s'agit d'une illustration explicative qui a été remplacée par un bureau et du matériel.
Calculer les suggestions de suite
Il divise le texte en petites unités de jetons et calcule le prochain jeton candidat et sa probabilité en fonction de l'entrée et du contenu généré jusqu'à présent. Répétez ce processus pour créer une réponse.
Les modèles et les applications de chat sont différents
Le modèle est la partie qui calcule la sortie à partir de l'entrée. Les applications de chat utilisent des modèles qui combinent l'historique des conversations, la recherche, les fichiers, les outils, etc. Les fonctionnalités disponibles dépendent également de l'application.
Par exemple:Pensez à la suite de « Parce qu’il pleut ».
« Prendre un parapluie » ou « reporter la sortie » sont des suites adaptées au contexte. Les LLM calculent aussi de telles suites pour des textes plus longs. Le traitement ne se fait pas nécessairement mot par mot.
sois prudent
Même si vous pouvez écrire des phrases naturelles, cela ne signifie pas nécessairement que le contenu est correct. Vous devez revoir les connaissances acquises, le matériel distribué et l’étendue des informations recherchées.
Dans AI Inc.
Le modèle terminé et le produit API que nous fournissons à nos clients sont des étapes distinctes. Après avoir créé un modèle, cela mènera aux raisons d’ajuster l’utilisation, les prix et l’offre.
Que sont les jetons et les fenêtres contextuelles ?
Un jeton est une petite unité, telle qu'une phrase, que le modèle gère. La fenêtre contextuelle représente la limite supérieure de la longueur des informations pouvant être visualisées en un seul processus.
Que sont les jetons et les fenêtres contextuelles ?
Un jeton est une petite unité, telle qu'une phrase, que le modèle gère. La fenêtre contextuelle représente la limite supérieure de la longueur des informations pouvant être visualisées en un seul processus.
Un jeton est une petite unité, telle qu'une phrase, que le modèle gère. La fenêtre contextuelle représente la limite supérieure de la longueur des informations pouvant être visualisées en un seul processus.
Contexte : informations utilisées cette fois
Séparez les matériaux sur votre bureau de ceux stockés sur l'étagère.
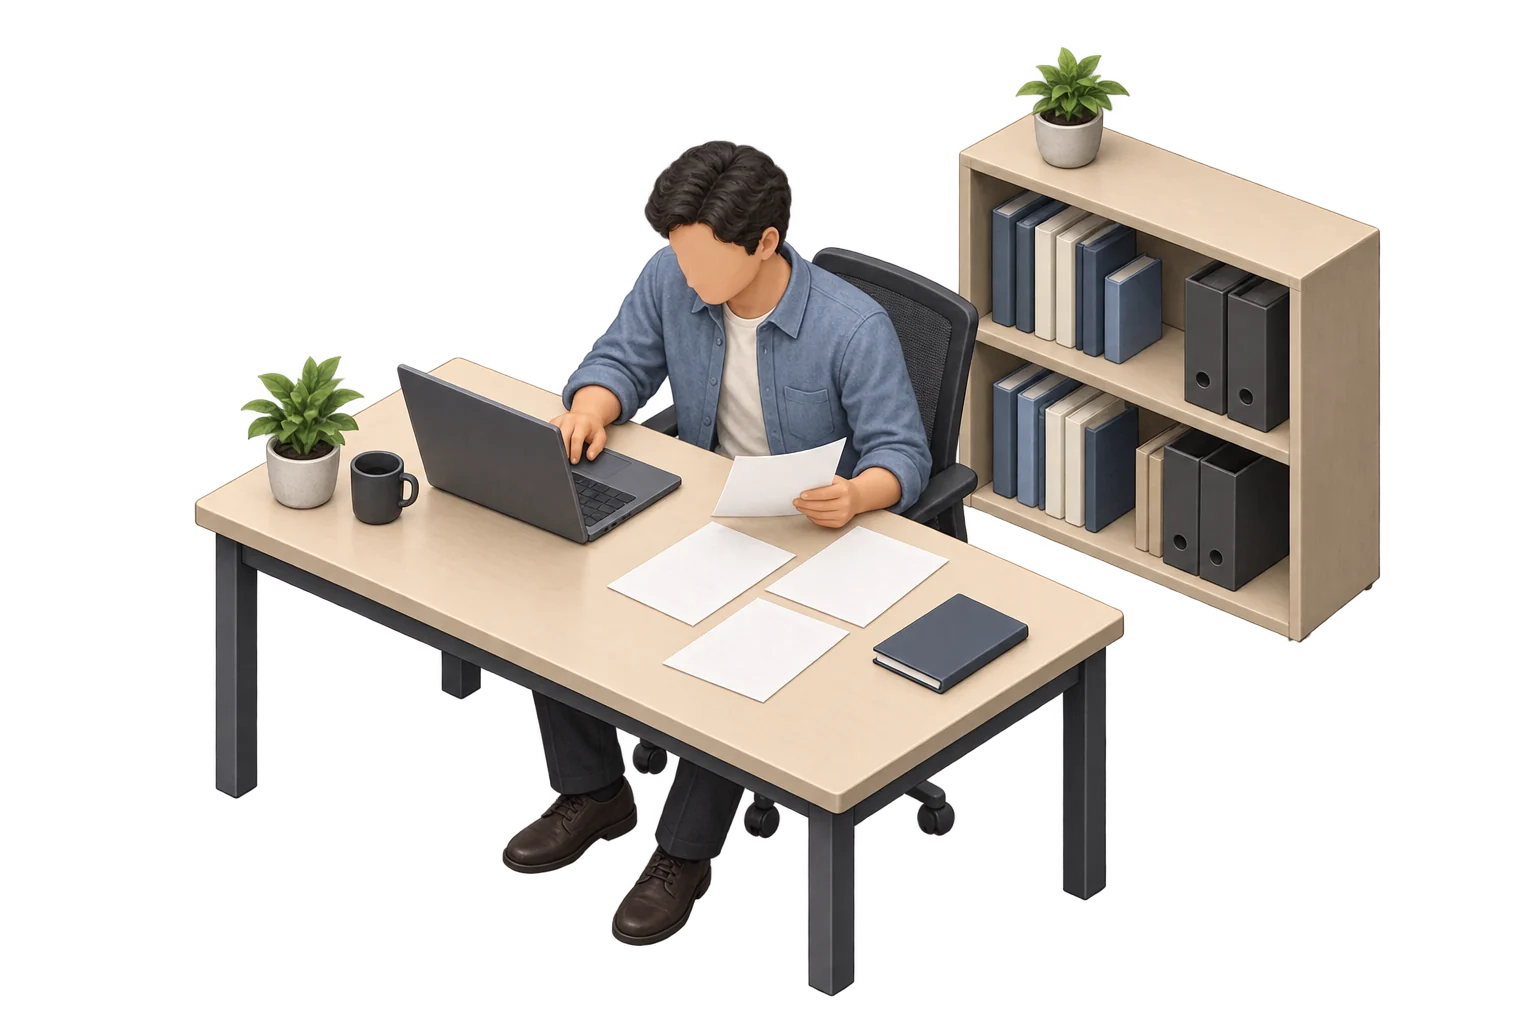
Sur le bureau : Information donnée cette fois
Les instructions, les questions, l'historique des conversations et les documents transmis par l'application à ce processus seront inclus dans le contexte.
À l’intérieur du rayon : matériels qui n’ont pas encore été remis
Même si vous avez sauvegardé des documents ou des conversations antérieures, vous ne pourrez peut-être pas vous y référer à moins qu'ils ne vous aient été remis cette fois-ci.
La fenêtre contextuelle correspond à la longueur maximale des informations pouvant être visualisées, généralement exprimée en jetons. La distribution de matériel est distincte de l’apprentissage supplémentaire. Même si vous leur donnez de longs documents, cela ne signifie pas qu’ils peuvent tous les utiliser correctement.
Il s'agit d'une illustration explicative qui a été remplacée par un bureau et du matériel.
Ne correspond pas au nombre de caractères/mots
Les jetons peuvent être des mots, des parties de mots, des caractères, etc. La division change en fonction du modèle et de la langue, de sorte qu'un caractère japonais ne peut pas toujours être compté comme un jeton.
Les conversations et les documents peuvent également servir d’informations de référence.
Les instructions, l'historique des conversations, les documents, etc. transmis par l'application sont mis en contexte. Les limites d'entrée et de sortie sont traitées différemment selon le modèle. Même si vous incluez du matériel long, rien ne garantit que vous serez en mesure de l’utiliser dans son intégralité avec précision.
Par exemple:Image de documents étalés sur un bureau
Le contexte est similaire aux documents que vous étalez sur votre bureau pour formuler votre réponse. Avoir le matériel sur votre bureau est une chose, mais en apprendre davantage sur le modèle lui-même en est une autre.
Dans AI Inc.
À mesure que la quantité d’informations traitées augmente, les charges de calcul et de mémoire changeront également dans les services du monde réel. Dans le jeu, vérifiez l'inférence de la demande et de l'offre à fournir à vos clients.
Le modèle est-il meilleur s’il comporte plus de paramètres ?
Les paramètres sont des valeurs numériques à l'intérieur du modèle qui sont ajustées lors de l'entraînement. C'est un indice sur l'échelle du modèle, mais ce n'est pas parce qu'il y en a un grand nombre qu'il est adapté à cet objectif.
Le modèle est-il meilleur s’il comporte plus de paramètres ?
Les paramètres sont des valeurs numériques à l'intérieur du modèle qui sont ajustées lors de l'entraînement. C'est un indice sur l'échelle du modèle, mais ce n'est pas parce qu'il y en a un grand nombre qu'il est adapté à cet objectif.
Les paramètres sont des valeurs numériques à l'intérieur du modèle qui sont ajustées lors de l'entraînement. C'est un indice sur l'échelle du modèle, mais ce n'est pas parce qu'il y en a un grand nombre qu'il est adapté à cet objectif.
Sélection du modèle : échelle, utilisation, coût
Comparez non seulement le nombre de produits, mais aussi les conditions de travail dans lesquelles ils seront utilisés.
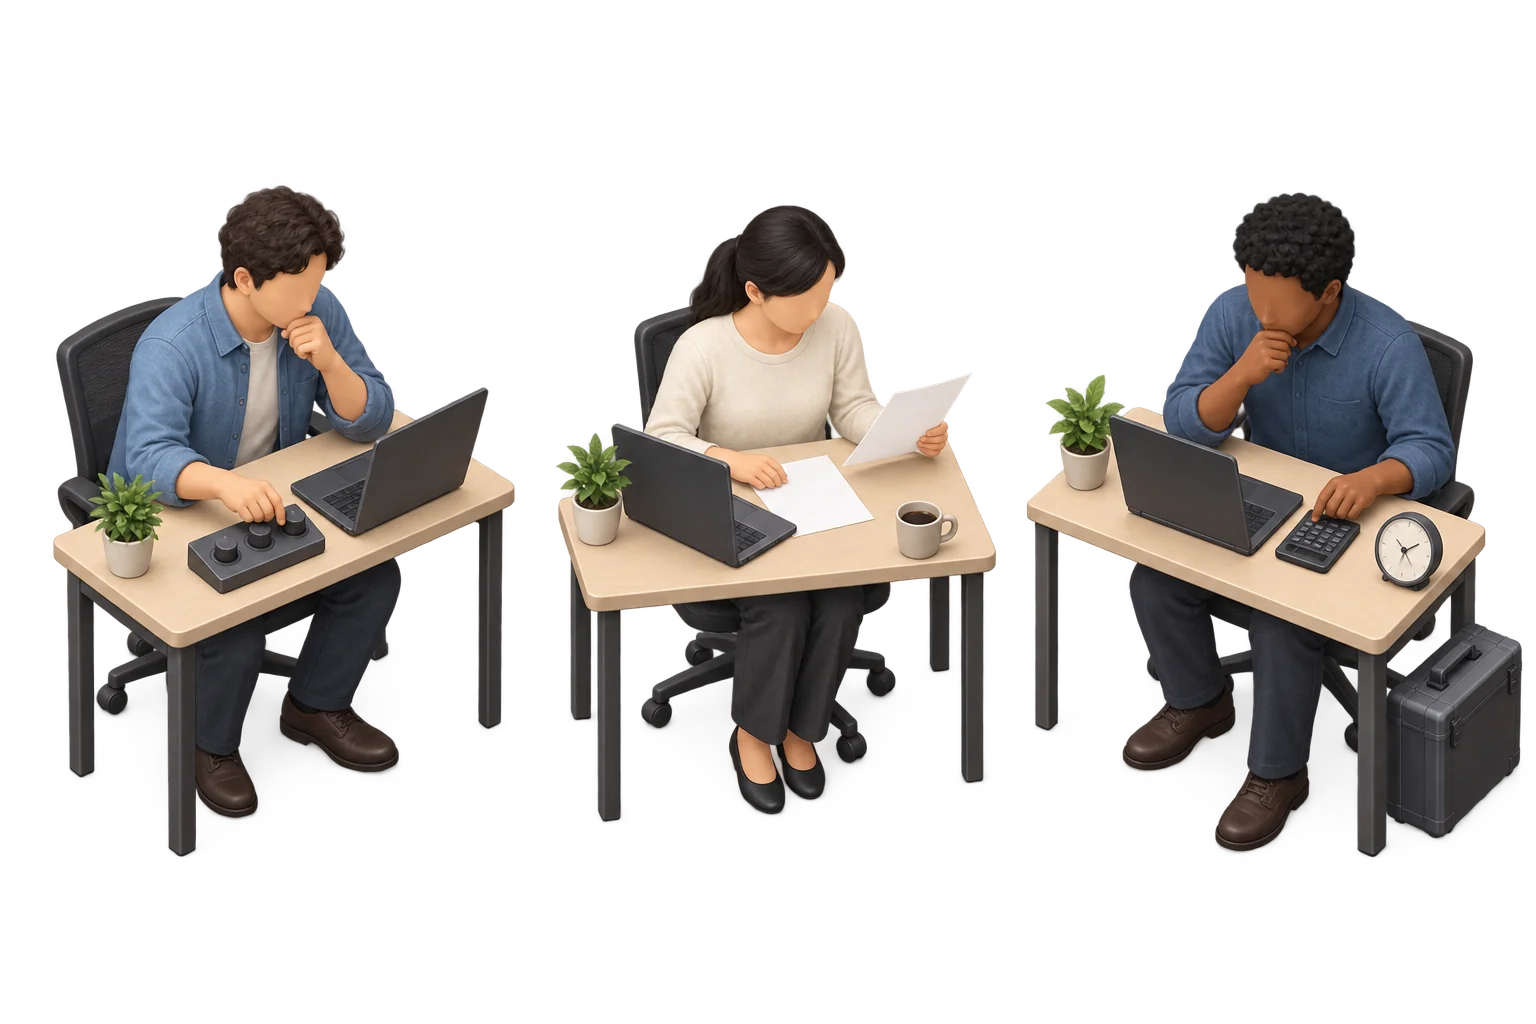
Gauche : Valeurs à ajuster lors de l'apprentissage
Les paramètres sont des valeurs numériques à l'intérieur du modèle. Ce n’est pas parce que le nombre est grand qu’il convient à l’objectif visé.
Centre : vérifiez auprès du travail pour lequel vous l'utilisez
Testez-le avec de vraies questions et du matériel pour vous assurer qu'il répond à la qualité dont vous avez besoin.
À droite : comparez également les ressources et les coûts
Comparez la vitesse, le coût, la charge de calcul et la charge de mémoire des candidats qui répondent à la qualité requise.
Un bouton est une métaphore pour ajuster les valeurs internes. Le nombre de paramètres n’est pas le nombre de faits connus. Les données, la conception et les méthodes d'apprentissage affectent également les résultats.
Il s'agit d'une illustration explicative qui a été remplacée par un bureau et du matériel.
Valeurs numériques à ajuster lors de l'apprentissage
Les paramètres comprennent notamment les poids d’un réseau neuronal. Ils sont ajustés à partir de nombreux exemples pour produire des sorties adaptées. Leur nombre n’indique pas combien de faits le modèle connaît.
Visualisation conjointe des performances, des ressources et des utilisations
Outre l’échelle, la qualité des données, la conception et les méthodes d’apprentissage affectent les résultats. Les grands modèles nécessitent généralement plus de ressources de calcul et de mémoire, mais la configuration et l'optimisation varient également. Comparons en utilisation réelle.
Par exemple:Classification courte et création de phrases complexes
Un modèle léger peut suffire pour classer les requêtes courtes. Une écriture plus complexe peut nécessiter un niveau de compétence plus élevé. Comparez la rapidité et le coût des modèles qui répondent à la qualité souhaitée.
Dans AI Inc.
Lors de la conception d'un modèle, tenez compte non seulement des performances prédictives, mais également du coût de formation et de la charge/vitesse d'inférence. Nous combinerons la décision d’augmenter la taille avec la décision de poursuivre notre activité.
Quelle différence entre entraînement et inférence ?
L’entraînement ajuste les valeurs internes du modèle. L’inférence calcule une réponse avec le modèle entraîné. Répondre aux utilisateurs demande aussi des ressources de calcul.
Quelle différence entre entraînement et inférence ?
L’entraînement ajuste les valeurs internes du modèle. L’inférence calcule une réponse avec le modèle entraîné. Répondre aux utilisateurs demande aussi des ressources de calcul.
L’entraînement ajuste les valeurs internes du modèle. L’inférence calcule une réponse avec le modèle entraîné. Répondre aux utilisateurs demande aussi des ressources de calcul.
Entraînement et inférence
Des calculs sont nécessaires à la fois lors de la création et de l'utilisation d'un modèle.
Apprentissage : Ajuster le modèle
Utilisez des exemples de données pour ajuster les nombres à l’intérieur du modèle.
Inférence : utiliser le modèle entraîné
Entrez une nouvelle question, etc., et calculez la réponse.
L’inférence ordinaire ne met pas à jour les paramètres internes du modèle. Sauvegarder des conversations diffère aussi d’un entraînement supplémentaire.
Il s'agit d'une illustration explicative qui a été remplacée par un bureau et du matériel.
La formation est un temps passé à ajuster le modèle à partir d'exemples
Comparez le résultat de l’exemple avec l’objectif d’apprentissage et ajustez les nombres internes. Si vous séparez le processus de création d'un modèle et le processus d'utilisation du modèle créé, il sera plus facile de comprendre la différence entre les ressources et les coûts.
L’inférence : répondre à la requête actuelle
L’inférence utilise les valeurs entraînées pour calculer une sortie à partir de l’entrée. L’inférence ordinaire ne réentraîne pas les valeurs internes à chaque réponse. Utiliser conversations ou documents comme entrée actuelle diffère d’un entraînement supplémentaire.
Vous pouvez lire le tableau en le déplaçant vers la gauche et la droite.
| choses à vérifier | étude | Inférence |
|---|---|---|
| le but | Ajuster les paramètres du modèle à partir de l'exemple | Calculer la sortie pour la nouvelle entrée |
| Exemple de saisie | Exemples de textes pédagogiques, questions et réponses | Questions des utilisateurs, documents de référence |
| numéro interne | Mettre à jour en apprenant | Non mis à jour lors de l’inférence ordinaire |
| Comment utiliser les ressources | Calculs pour créer et améliorer des modèles | Calculs pour le traitement des demandes des clients |
Par exemple:Même après sa création, il y a des coûts de fonctionnement
Même une fois le modèle de réponse terminé, chaque question d’un utilisateur nécessite de l’inférence. Davantage d’utilisateurs simultanés demandent davantage de capacité de service.
sois prudent
L'enregistrement des conversations et l'utilisation des entrées pour un apprentissage futur sont une politique de service différente de la mise à jour des paramètres lors de la réponse en cours.
Dans AI Inc.
Les ressources informatiques pour l’apprentissage et l’inférence ont des rôles distincts. Même si l'apprentissage est terminé, si l'allocation à l'inférence est insuffisante, il y aura une pénurie d'approvisionnement pour les clients.
Qu’est-ce que le pré-apprentissage et la mise au point ?
La pré-formation est le processus d'apprentissage des régularités de base à partir d'un large éventail de données, et le réglage fin est le processus d'ajustement du modèle formé avec des données supplémentaires.
Qu’est-ce que le pré-apprentissage et la mise au point ?
La pré-formation est le processus d'apprentissage des régularités de base à partir d'un large éventail de données, et le réglage fin est le processus d'ajustement du modèle formé avec des données supplémentaires.
La pré-formation est le processus d'apprentissage des régularités de base à partir d'un large éventail de données, et le réglage fin est le processus d'ajustement du modèle formé avec des données supplémentaires.
Pré-apprentissage et apprentissage complémentaire
Construisez une fondation et ajustez-la en fonction du travail pour lequel vous l'utiliserez.
À gauche : poser les bases avec un large éventail d’exemples
Apprenez les règles de base en utilisant de nombreuses phrases. Il s'agit du processus d'ajustement des valeurs numériques à l'intérieur du modèle.
À droite : Ajustez avec un exemple qui correspond à votre objectif
Utilisez le modèle formé comme point de départ et apprenez en outre avec des exemples adaptés à votre travail et à votre format de sortie. Le réglage fin met à jour les valeurs internes.
Inviter ou transmettre du matériel via RAG est distinct de l’apprentissage supplémentaire. Vérifiez si l'apprentissage s'est amélioré en utilisant des exemples qui n'ont pas été utilisés pour l'apprentissage.
Il s'agit d'une illustration explicative qui a été remplacée par un bureau et du matériel.
Construire une base avec un apprentissage avancé
De nombreux modèles linguistiques apprennent les régularités des mots en résolvant un grand nombre de tâches, comme prédire la suite d'une phrase. En utilisant une base pré-entraînée, il n’est pas nécessaire de créer un modèle à partir de zéro à chaque fois.
Adapter le modèle à l’usage par entraînement supplémentaire
Des exemples de questions et de réponses souhaitées rendent les instructions plus faciles à suivre ou adaptées à des tâches et des formats de sortie spécifiques. Apprendre à répondre aux instructions et à utiliser les évaluations des personnes est inclus en post-formation après le pré-apprentissage.
Par exemple:Aligner le format de classification des demandes de renseignements
Un apprentissage supplémentaire peut être envisagé pour faciliter la production dans un format fixe à l'aide de phrases de recherche et d'exemples de classification de « facturation », « contrat » et « opération ». Vérifiez si les améliorations ont été apportées à l'aide d'exemples qui n'ont pas été utilisés pour l'apprentissage.
sois prudent
L'apprentissage supplémentaire est différent de RAG, qui recherche du matériel. Ce n’est pas une méthode de choix pour garantir la mémorisation de nouveaux faits.
Dans AI Inc.
Le développement dérivé à l'aide d'un modèle parent conduit à l'idée d'utiliser la fondation existante. Veuillez lire l'écran de confirmation de l'objectif pour connaître les conditions de performance et de coût à conserver dans le jeu.
Dois-je simplement augmenter la quantité de données d’entraînement ?
Les données nécessitent non seulement de la quantité, mais aussi de l’exactitude, de la variété et de la proximité d’utilisation. Un état dans lequel le système est fort uniquement grâce aux exemples qu'il a vus au cours de la formation et faible avec de nouveaux exemples est appelé « surapprentissage ».
Les données nécessitent non seulement de la quantité, mais aussi de l’exactitude, de la variété et de la proximité d’utilisation. Un état dans lequel le système est fort uniquement grâce aux exemples qu'il a vus au cours de la formation et faible avec de nouveaux exemples est appelé « surapprentissage ».
Données d'apprentissage : quantité, qualité, comment vérifier
Ne vous contentez pas d'ajouter d'autres exemples, nettoyez-les et vérifiez-les avec d'autres exemples.
Quantité : Existe-t-il uniquement des exemples similaires ?
Même si vous augmentez le nombre d’exemples, s’il y a beaucoup de chevauchements ou de biais, vous ne pourrez pas couvrir entièrement les situations dans lesquelles ils sont utilisés.
Qualité : préparer des exemples qui correspondent à la situation d’utilisation
Passez en revue les erreurs et les doublons et préparez un large éventail d’exemples proches de la question, du langage et du public réels.
Évaluation : vérifiez avec des exemples inutilisés
Séparez les parties pour l'apprentissage, la vérification pour l'ajustement et le test final. Vérifions avec un exemple qui n'a pas été utilisé dans l'étude.
Le surapprentissage est un état dans lequel le système n'est fort qu'avec les exemples vus lors de la formation et faible avec de nouveaux exemples. Nous examinons la quantité, la qualité et la proximité des données par rapport à l'utilisation prévue.
Il s'agit d'une illustration explicative qui a été remplacée par un bureau et du matériel.
Créez un exemple similaire à la situation dans laquelle il sera utilisé
Les erreurs, les duplications et les données biaisées peuvent également affecter vos résultats. Décidez du type de questions, de langage et d'utilisateurs que vous attendez, et préparez des exemples représentatifs de l'utilisation réelle.
Séparer les données d'apprentissage et d'évaluation
Si vous évaluez uniquement les exemples que vous avez mémorisés pendant l'apprentissage, il sera difficile de juger si vous pouvez gérer de nouvelles entrées. Nous faisons également la distinction entre les données de vérification utilisées pour l'ajustement et les données de test utilisées pour la confirmation finale.
Par exemple:Apprendre avec seulement des questions courtes
Même si vous êtes doué pour les phrases courtes et fixes, vous pourriez être faible lors de longues consultations ou pour des questions avec des formulations différentes. Nous vérifierons avec les données inutilisées, y compris les exemples réellement écrits par les utilisateurs.
Dans AI Inc.
L'octroi de licences, la maintenance et la sélection des données pour l'apprentissage sont des étapes distinctes. Une fois que vous aurez compris le concept de qualité des données dans la vie réelle, il sera plus facile de comprendre le but de la maintenance dans les jeux.
L’écriture incite-t-elle à l’apprentissage ?
Les invites sont des instructions ou des informations que vous transmettez à votre modèle. Habituellement, les conditions de réponse sont modifiées, ce qui est différent de l'apprentissage, qui met à jour les paramètres du modèle.
L’écriture incite-t-elle à l’apprentissage ?
Les invites sont des instructions ou des informations que vous transmettez à votre modèle. Habituellement, les conditions de réponse sont modifiées, ce qui est différent de l'apprentissage, qui met à jour les paramètres du modèle.
Les invites sont des instructions ou des informations que vous transmettez à votre modèle. Habituellement, les conditions de réponse sont modifiées, ce qui est différent de l'apprentissage, qui met à jour les paramètres du modèle.
Invite : objectif, matériaux, format de sortie
Dites-leur ce que vous voulez qu'ils fassent, quoi utiliser et comment réagir.
Objectif : Dites-nous ce que vous voulez
Notez la tâche spécifique que vous demandez, par exemple « résumer le procès-verbal ».
Matériel : Communiquer le champ d’utilisation
Donnez-leur le procès-verbal auquel vous souhaitez qu'ils se réfèrent et indiquez la portée de la réunion en disant : « Je n'utiliserai que ce matériel ».
Format : indiquez le format de la réponse
Spécifiez le format du résultat, par exemple « Décisions en trois puces ».
La transmission des instructions et du matériel est généralement distincte de l'apprentissage ultérieur du modèle. Même si les instructions sont spécifiques, des erreurs se produiront toujours, alors vérifiez vos réponses avec le matériel.
Il s'agit d'une illustration explicative qui a été remplacée par un bureau et du matériel.
Transmettre l'objectif, les matériaux et le format de sortie
Écrivez en détail ce que vous voulez qu'ils fassent, quelles informations vous voulez qu'ils utilisent et comment vous voulez qu'ils réagissent. Si nécessaire, transmettez également un exemple du résultat souhaité.
Continuez la conversation avec les informations auxquelles vous faites référence.
La raison pour laquelle vous pouvez utiliser des instructions passées est que l'application dispose d'un mécanisme pour les transmettre au modèle. Le simple fait de pouvoir utiliser de nouvelles informations au cours d’une conversation ne signifie pas que le modèle a appris de manière permanente.
Par exemple:Rendez votre « résumé » spécifique
Communiquez l'objectif, la portée et le format, par exemple : « Veuillez utiliser uniquement les minutes suivantes et énumérer les décisions en trois puces. Veuillez ne rien remplir qui ne figure pas dans le document.''
sois prudent
Des instructions détaillées peuvent aider, mais elles ne garantissent pas qu'elles seront exemptes d'erreurs. Vérifions le résultat par rapport au matériel réel.
Dans AI Inc.
Concevoir un modèle ou lancer son entraînement dans le jeu diffère de la rédaction d’un prompt dans un vrai chat. Sauvegarder la conception seule ne déclenche ni coût ni progression de l’entraînement principal.
RAG et plongements : quelle différence avec l’ajustement ?
Le RAG recherche les documents utiles et les transmet au modèle pour générer une réponse. Les sources sont gérées séparément des paramètres du modèle.
RAG et plongements : quelle différence avec l’ajustement ?
Le RAG recherche les documents utiles et les transmet au modèle pour générer une réponse. Les sources sont gérées séparément des paramètres du modèle.
Le RAG recherche les documents utiles et les transmet au modèle pour générer une réponse. Les sources sont gérées séparément des paramètres du modèle.
RAG : chercher avant de répondre
Transmettez le matériel récupéré au modèle pour qu’il réponde.
Rechercher des documents connexes
Recherchez la pièce dont vous avez besoin dans les manuels qui correspondent à votre question.
transmettre la question
Transmettez le matériel trouvé au modèle comme information à référencer dans la réponse.
Répondez en vous référant aux matériaux
Le modèle génère une réponse. Vérifiez également que le matériel soutient votre réponse.
Remettre du matériel et apprendre des modèles supplémentaires sont deux choses différentes. RAG ne garantit pas à lui seul l'exactitude, car le matériel peut être ancien ou les réponses peuvent différer du matériel.
Il s'agit d'une illustration explicative qui a été remplacée par un bureau et du matériel.
Rechercher → Remettre le matériel → Réponse
Recherchez les manuels internes de l'entreprise liés à votre question et transmettez les parties pertinentes avec votre question. Il n'est pas nécessaire de recycler l'intégralité du modèle pour référencer la documentation mise à jour.
Rechercher du contenu similaire en l'intégrant
L'intégration est une méthode permettant d'exprimer des caractéristiques telles que des phrases sous la forme d'une séquence de nombres. Vous pouvez utiliser cette proximité pour votre recherche. RAG propose également des recherches par mots clés et une combinaison des deux.
Différences dans la manière dont les informations sont utilisées
En utilisant la réponse à une demande comme exemple, nous séparerons les informations à transmettre cette fois-ci et les nombres à ajuster au cours de l'apprentissage.
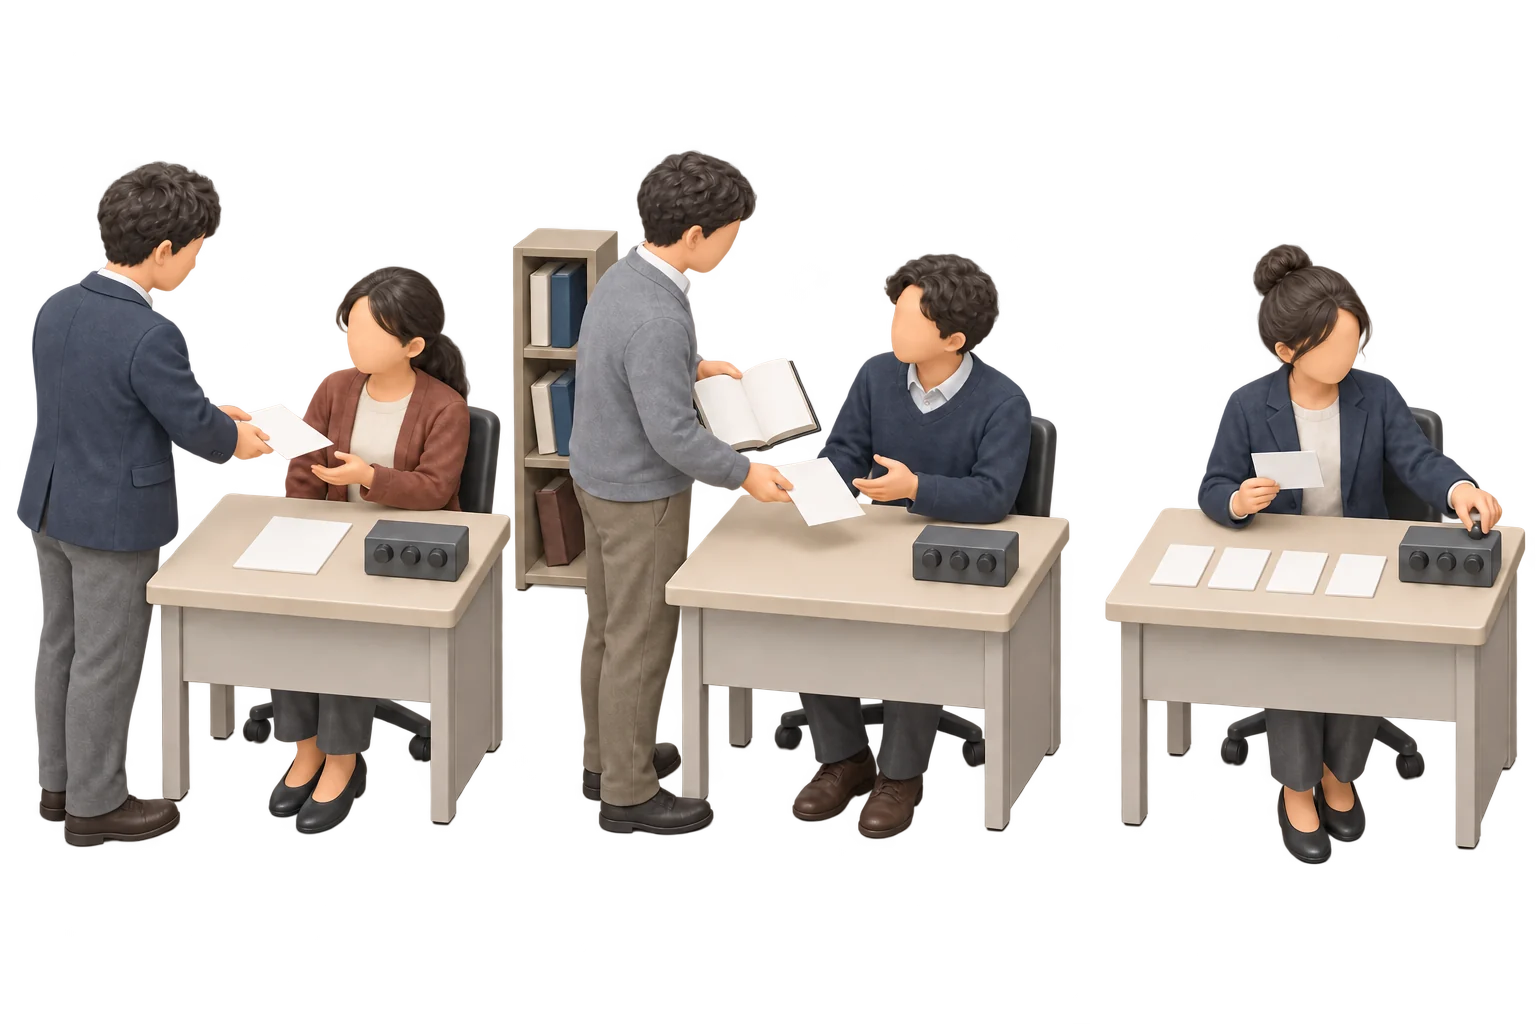
Gauche : invite
Donnez-leur des instructions et du matériel, tels que « Gardez vos réponses en deux phrases ». La réponse habituelle ne met pas à jour les nombres à l'intérieur du modèle.
Centre: RAG
Trouvez un manuel qui correspond à votre question et transmettez-lui les pièces nécessaires ainsi que les instructions. Le processus de recherche et de transmission des données lui-même ne met pas à jour les valeurs numériques à l'intérieur du modèle.
À droite : réglage fin
Ajustez les numéros internes du modèle formé avec un exemple de requête et la classification souhaitée. Il est utilisé pour correspondre au format de classification « Facturation/Contrat/Opération ».
Les trois approches peuvent se combiner. Le RAG ajoute les documents retrouvés au prompt. Déterminez si vous avez besoin de sources actualisées ou d’un autre format, puis testez des questions réelles.
Un bouton est une métaphore qui représente une valeur numérique à l'intérieur d'un modèle. Les trois scènes sont des comparaisons de méthodes et non d’ordre de travail.
Par exemple:Quand les heures d'ouverture changent
Recherchez des documents avec de nouveaux horaires d'ouverture et fournissez-les comme preuve de votre réponse. Si vous recherchez du matériel ancien, même RAG peut être une ancienne réponse.
sois prudent
Il est possible que les documents soient mélangés ou que des informations qui ne figurent pas dans les documents soient générées. Évaluez à la fois les résultats de la recherche et le résultat pour vous assurer que les références soutiennent réellement la réponse.
Dans AI Inc.
Il s’agit de connaissances de base pour les services d’IA du monde réel. Cela ne signifie pas que vous pouvez configurer RAG individuellement dans le jeu. Cela conduit à l’idée de sélectionner des modèles et des données adaptés à l’objectif recherché.
Qu’est-ce qu’une hallucination ? Pourquoi vérifier la réponse ?
L'hallucination est la création d'un contenu plausible qui ne peut être étayé par des faits ou des documents. Des informations ou des sources inexistantes peuvent être mélangées à une écriture naturelle.
Qu’est-ce qu’une hallucination ? Pourquoi vérifier la réponse ?
L'hallucination est la création d'un contenu plausible qui ne peut être étayé par des faits ou des documents. Des informations ou des sources inexistantes peuvent être mélangées à une écriture naturelle.
L'hallucination est la création d'un contenu plausible qui ne peut être étayé par des faits ou des documents. Des informations ou des sources inexistantes peuvent être mélangées à une écriture naturelle.
Hallucination et confirmation de la base
Même si la réponse est facile à lire, ouvrez la source et vérifiez.
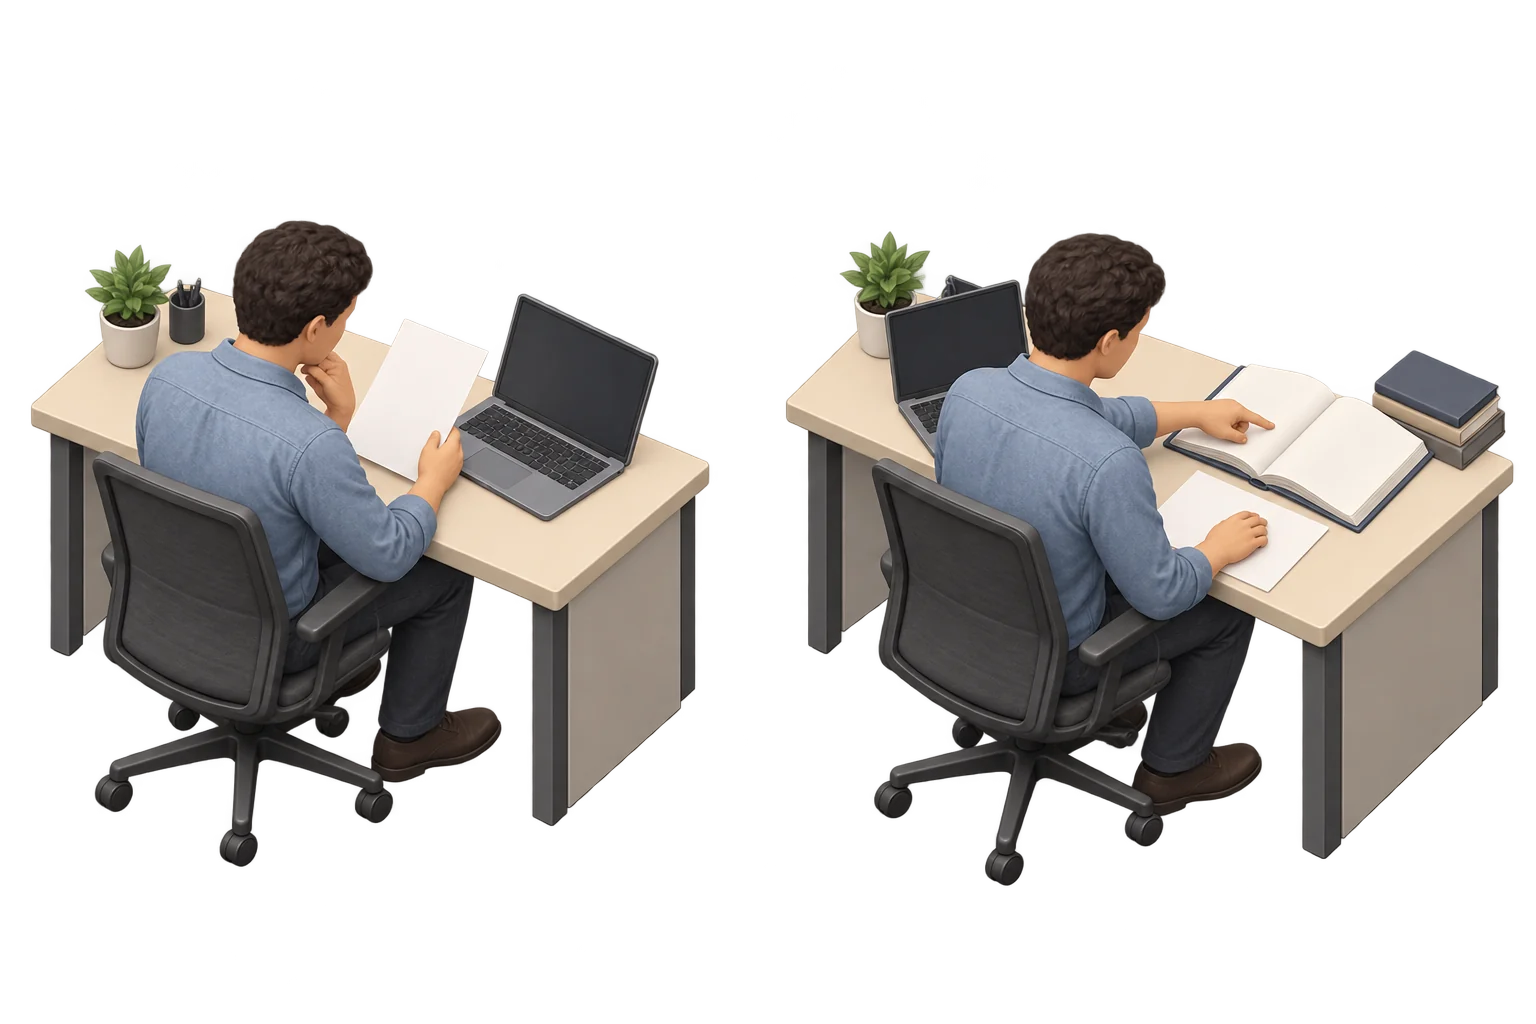
Gauche : Lisez la réponse naturelle
Des explications détaillées et des noms de documents spécifiques ne peuvent pas à eux seuls être utilisés pour déterminer qu’il existe un support factuel.
À droite : Vérifiez avec l'original
Ouvrez la source et vérifiez s'il y a des parties qui soutiennent votre réponse et si les numéros, les dates et les noms des personnes correspondent.
Même si une source existe, elle ne soutient pas nécessairement la réponse. Si nous ne trouvons aucune preuve, nous ne la traiterons pas comme un fait et vérifierons d’autres documents.
Il s'agit d'une illustration explicative qui a été remplacée par un bureau et du matériel.
Le naturel du texte et l’exactitude des faits sont deux choses différentes.
Les LLM calculent une sortie adaptée au contexte. Un ton assuré ou détaillé ne prouve pas son fondement. La recherche ou le calcul dépendent aussi de l’application.
Vérifiez les preuves en les ouvrant réellement
Vérifiez les parties pertinentes des documents, les numéros, les dates, les noms des personnes, etc. Même si une citation existe, elle n'étaye pas nécessairement la réponse. Si vous dites que vous ne savez pas, nous l'inclurons dans votre évaluation.
Par exemple:Créer un nom de document probable
Le modèle peut citer un manuel inexistant pour justifier une fonction. Un titre précis ne dispense pas de vérifier l’original.
sois prudent
La recherche, le RAG, l'apprentissage supplémentaire, etc. contribuent à réduire les erreurs, mais ne garantissent pas l'exactitude. Même si vous réduisez la variation de production, les réponses incorrectes peuvent être corrigées.
Dans AI Inc.
L'évaluation externe est un matériel qui permet de lire ce qui a été confirmé et dans quelle mesure. Les hautes performances et les résultats d'évaluation ne garantissent pas à eux seuls la sécurité de toutes les applications.
Si la référence est élevée, pouvez-vous la fournir telle quelle ?
Un benchmark est une évaluation permettant de comparer les performances sur une tâche fixe. Il est nécessaire de confirmer séparément si cela est utile dans l'application réelle du client.
Si la référence est élevée, pouvez-vous la fournir telle quelle ?
Un benchmark est une évaluation permettant de comparer les performances sur une tâche fixe. Il est nécessaire de confirmer séparément si cela est utile dans l'application réelle du client.
Un benchmark est une évaluation permettant de comparer les performances sur une tâche fixe. Il est nécessaire de confirmer séparément si cela est utile dans l'application réelle du client.
Évaluation : défis communs et applications pratiques
Vérifiez séparément les problèmes courants et les conditions de travail.
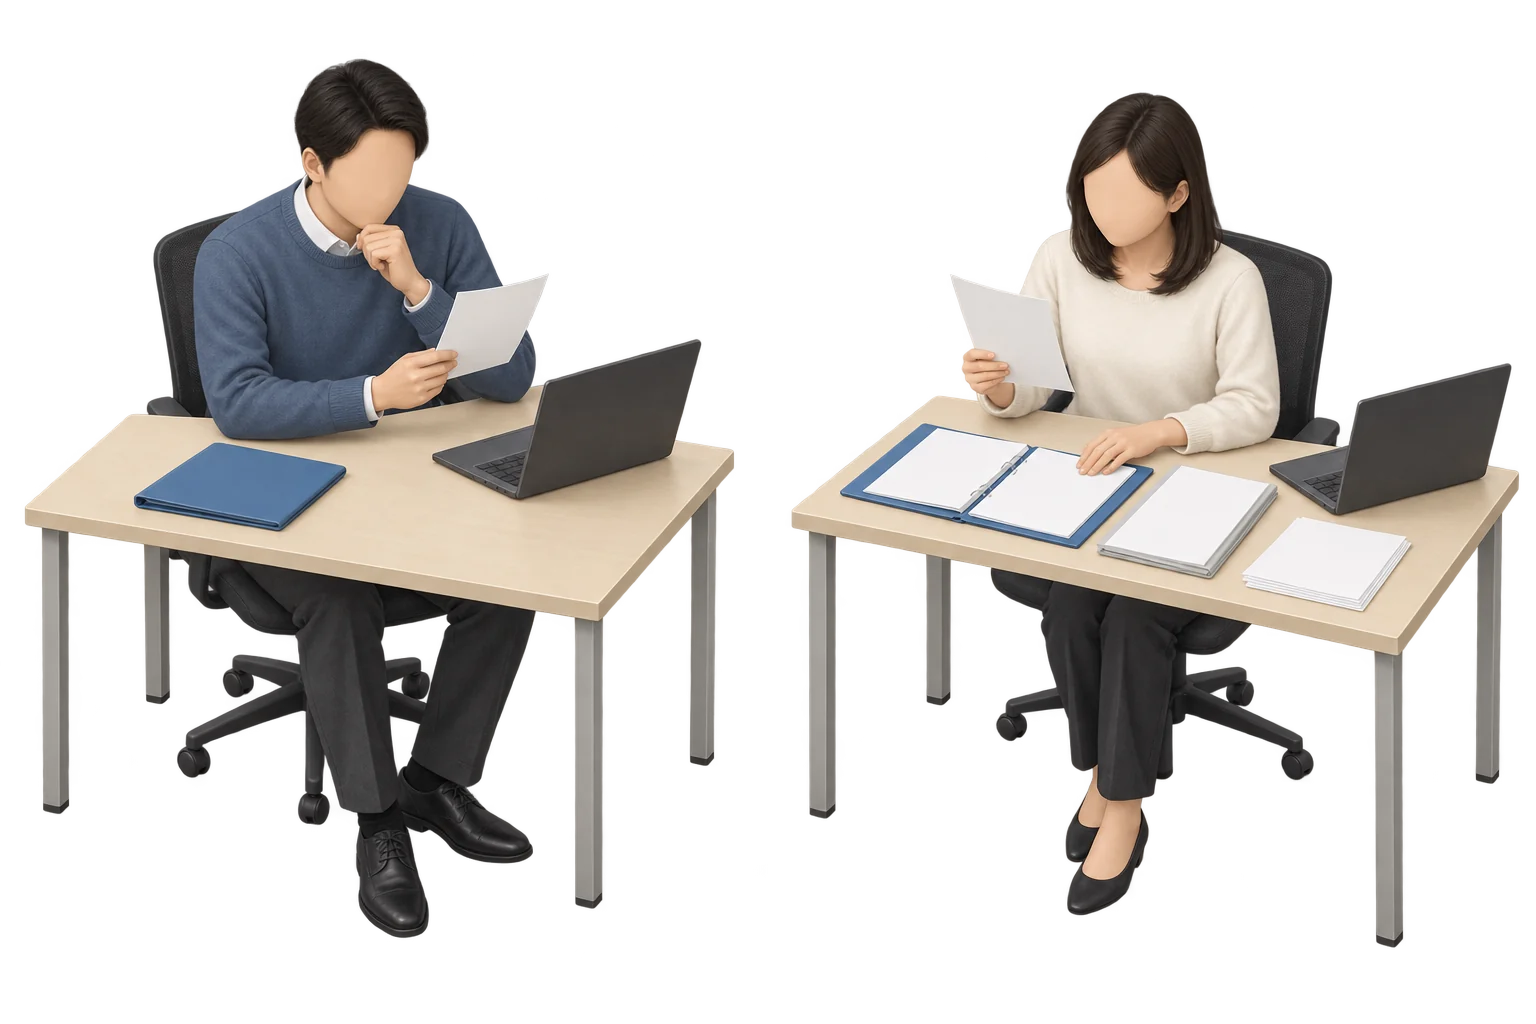
À gauche : Lisez les résultats des défis communs
Comparez les performances des modèles en utilisant les mêmes questions et conditions de notation. Lisez la feuille de résultats pour vérifier l'étendue des tâches que vous avez tentées.
À droite : Essayez-le dans les conditions du travail que vous utiliserez.
Utilisez du matériel et des questions réels pour confirmer que les chiffres et les délais requis sont respectés. Nous examinerons également la vitesse de réponse et le coût.
Les résultats de référence ne peuvent à eux seuls être utilisés pour conclure qu’ils sont utiles pour n’importe quel travail. Nous décidons d'abord des conditions qui conviennent à l'application du client, puis nous les vérifions même après un changement de modèle et de matériaux.
Le papier et les dossiers sont des métaphores pour décrire les résultats courants des tâches et leur confirmation dans les applications du monde réel. La gauche et la droite ne constituent pas l’ordre des processus et ni l’une ni l’autre ne garantissent le succès, la sécurité ou la livraison. Le nombre de personnes et de matériel ne représente pas le nombre de tests.
Test dans des conditions similaires au travail réel
Comparez la langue utilisée, le matériel utilisé, la longueur des questions, le format requis, etc. Incluez des exemples que vous n'avez pas utilisés dans vos études ou des questions auxquelles vous ne pouvez pas répondre.
Voir l'ensemble du service, pas seulement le modèle
Nous vérifions non seulement le taux de réponse et la justification correcte, mais également la vitesse de réponse, le coût, les échecs de recherche, le fonctionnement des outils, etc. Si vous ne regardez que le score moyen, vous risquez de négliger les modèles qui sont faibles dans certaines conditions.
Par exemple:Même si vous savez résumer, vous risquez de manquer les chiffres.
Même un résumé facile à lire ne sera d’aucune utilité si le montant de la facture ou le délai ne sont pas indiqués. Décidez d’abord de ce qui doit rester et évaluez-le dans ces conditions.
sois prudent
Les résultats d’évaluation valent pour les conditions et le moment testés. Ils ne garantissent rien pour des usages non évalués. Vérifiez à nouveau les résultats après toute modification du modèle ou des documents.
Dans AI Inc.
Cela conduit à la raison pour laquelle l'évaluation du modèle, la publication, la fourniture précoce et la migration des clients sont jugées séparément. Examinons les résultats des tests ainsi que les résultats réels de l'approvisionnement et des ventes.
Quels liens entre GPU, mémoire et rapidité de réponse ?
Les LLM effectuent de nombreux calculs et utilisent du matériel parallèle comme les GPU. Mémoire, simultanéité et longueur des réponses comptent aussi pour la fourniture.
Quels liens entre GPU, mémoire et rapidité de réponse ?
Les LLM effectuent de nombreux calculs et utilisent du matériel parallèle comme les GPU. Mémoire, simultanéité et longueur des réponses comptent aussi pour la fourniture.
Les LLM effectuent de nombreux calculs et utilisent du matériel parallèle comme les GPU. Mémoire, simultanéité et longueur des réponses comptent aussi pour la fourniture.
Inférence : latence et débit
Répondre vite à une requête et en traiter beaucoup sont deux objectifs distincts.
Gauche : Temps d'attente pour 1 article
La latence est le temps qui s'écoule entre l'envoi d'une requête et la réception d'une réponse. Parfois, nous mesurons la première lettre et la complétion de la réponse.
À droite : Montant du traitement pendant une certaine période de temps
Le débit est le nombre de requêtes ou de jetons pouvant être traités dans un certain laps de temps. Nous vérifierons également le volume de traitement et le temps d’attente lorsque le nombre de personnes utilisant le service augmentera en même temps.
Une réponse rapide pour une personne ne suffit pas à évaluer la charge. Vérifiez délai et débit, mais aussi GPU, mémoire, simultanéité et longueur des réponses.
Il s'agit d'une illustration explicative qui a été remplacée par un bureau et du matériel.
La vitesse de calcul et la quantité d’informations pouvant être stockées sont deux choses différentes.
Le GPU calcule ; la mémoire conserve modèle et informations de travail. Comparez surface d’un bureau et vitesse de travail pour comprendre ces rôles, sans en déduire une performance réelle.
Voir le temps d'attente pour une réponse unique et le montant total du traitement
La latence est le temps nécessaire pour attendre une requête et le débit est la quantité qui peut être traitée dans un certain laps de temps. Le temps nécessaire pour obtenir la première lettre et le temps nécessaire pour obtenir la réponse longue complète sont également différents. En mesurant l'utilisation simultanée et la longueur de réponse, il devient plus facile de comparer les conditions de mise à disposition.
| indice | voir |
|---|---|
| latence | Délai d’une requête jusqu’à la réponse. Distinguer le premier caractère de la réponse complète. |
| débit | Le nombre de requêtes et de jetons pouvant être traités dans un certain laps de temps. |
| mémoire | Capacité de stockage des modèles et des informations en cours de traitement. |
| coût | Coût de l'équipement et du fonctionnement nécessaires. Varie en fonction du modèle et des conditions de mise à disposition. |
Par exemple:Rapide seul, plus lent en période de charge
La rapidité pour une personne ne détermine pas la capacité pour 100 utilisateurs simultanés. Mesurez latence et volume traité par unité de temps.
Dans AI Inc.
Vérifiez nombre de GPU, livraison, fonctionnement et répartition recherche-entraînement-inférence. Les indicateurs du jeu ne correspondent pas à des nombres réels de tokens ou des latences.
Qu’est-ce que l’IA multimodale ?
Il s'agit d'une IA qui gère plusieurs types d'informations telles que le texte, les images et l'audio. La « modalité » fait référence au type d’information. Les entrées et sorties pouvant être gérées varient en fonction du modèle.
Qu’est-ce que l’IA multimodale ?
Il s'agit d'une IA qui gère plusieurs types d'informations telles que le texte, les images et l'audio. La « modalité » fait référence au type d’information. Les entrées et sorties pouvant être gérées varient en fonction du modèle.
Il s'agit d'une IA qui gère plusieurs types d'informations telles que le texte, les images et l'audio. La « modalité » fait référence au type d’information. Les entrées et sorties pouvant être gérées varient en fonction du modèle.
Multimodal : texte, images, audio
Utilisez différents types d’informations ensemble.
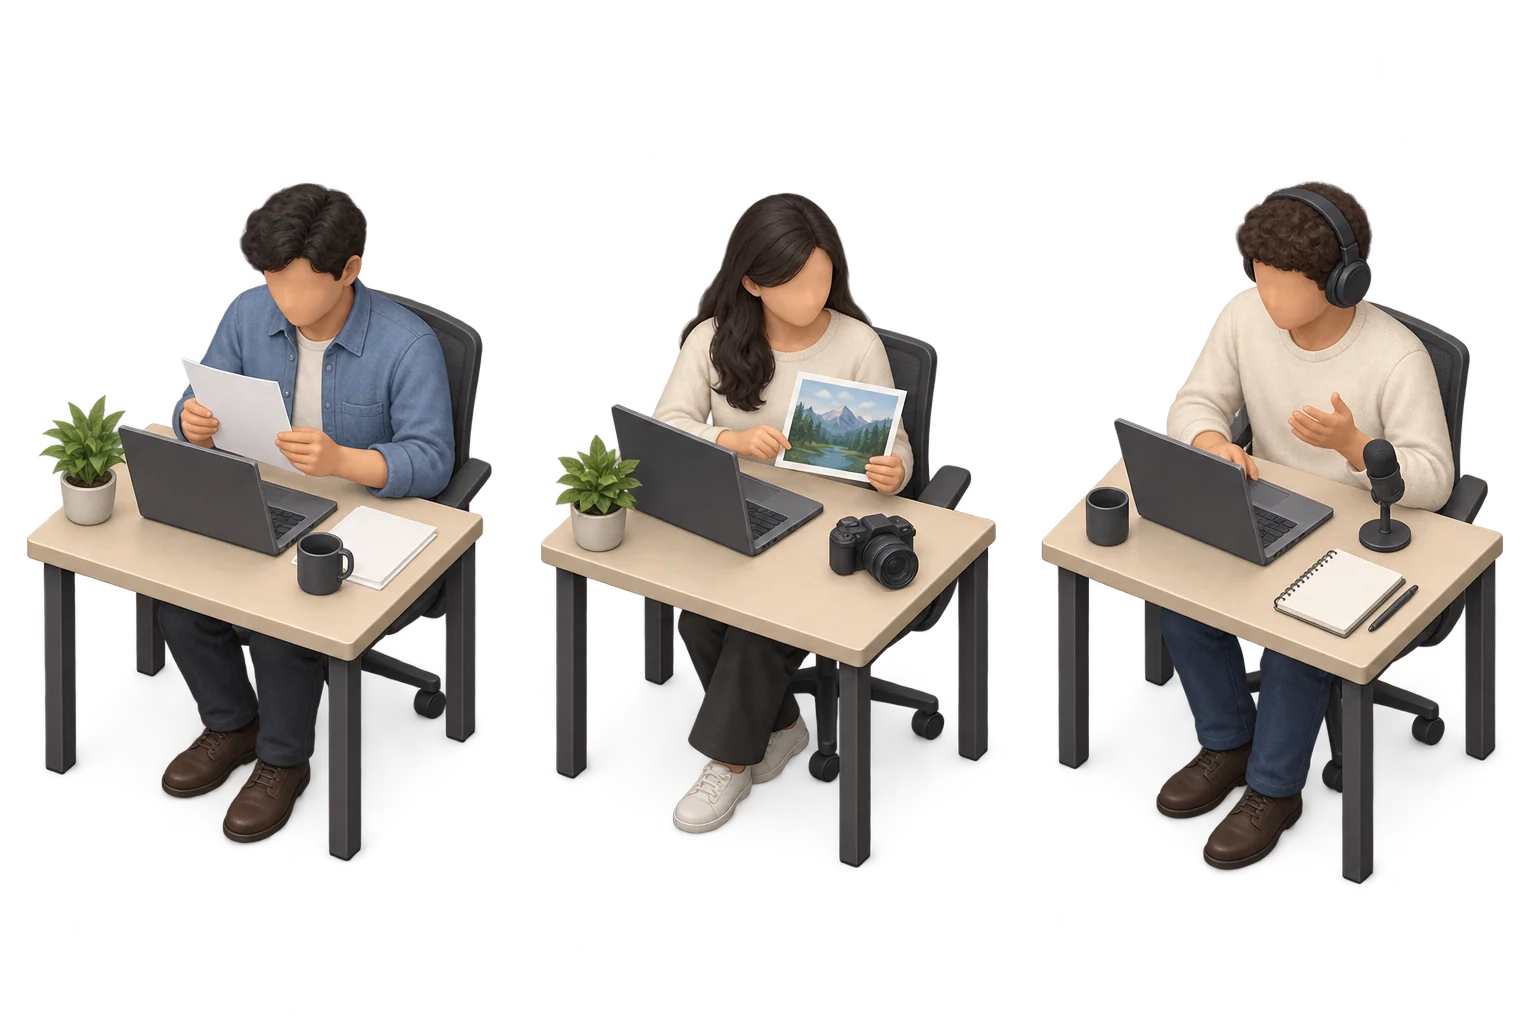
Gauche : Transmettre dans le texte
Saisissez du texte tel que des questions, des explications et du matériel.
Centre : utilise également des images
Une façon de l’utiliser consiste à combiner du texte et des images pour expliquer ce qui est affiché.
À droite : utilise également la voix
Sur les modèles compatibles, vous pouvez saisir votre voix et poser des questions sur le contenu.
Les entrées et sorties pouvant être gérées varient en fonction du modèle. Ce n’est pas parce que vous pouvez saisir une image que vous pouvez générer une image. Vérifiez soigneusement les résultats pour les images sombres ou le son difficile à entendre.
Il s'agit d'une illustration explicative qui a été remplacée par un bureau et du matériel.
Combiner différents types d'informations
Expliquez ce qu'il y a dans l'image dans le texte, ou écoutez l'audio et répondez à ce qu'il y a dans l'image. Un modèle capable de saisir des images ne génère pas nécessairement également des images.
Les résultats changent en fonction des conditions d'entrée.
Des textes de petite taille, des images sombres et des voix difficiles à entendre peuvent entraîner une mauvaise reconnaissance. Même si vous pouvez gérer plusieurs éléments d’information, vous devez vérifier l’exactitude de chaque élément d’information.
Par exemple:Joindre une photo et demander des instructions
Il s'agit d'une façon de faire correspondre une photo d'une machine avec le texte « Qu'est-ce que ce bouton ? » Si le bouton n'est pas lisible sur la photo, le modèle peut se tromper.
Dans AI Inc.
Lorsque vous choisissez un domaine de recherche ou un marché, cela vous aidera à déterminer si vos clients ont uniquement besoin de texte ou s'ils ont également besoin d'images et de son. Veuillez vérifier la description dans le jeu pour connaître les fonctionnalités compatibles.
Quelle différence entre un agent et une IA qui répond ?
Un agent choisit des étapes vers un objectif et utilise recherche ou outils. La capacité à répondre et l’autorisation d’agir sont distinctes.
Quelle différence entre un agent et une IA qui répond ?
Un agent choisit des étapes vers un objectif et utilise recherche ou outils. La capacité à répondre et l’autorisation d’agir sont distinctes.
Un agent choisit des étapes vers un objectif et utilise recherche ou outils. La capacité à répondre et l’autorisation d’agir sont distinctes.
Répondre à l’IA et aux agents IA
Séparez la lecture de la proposition du travail avec les outils.
Gauche : Recevoir des propositions par écrit
Proposer par écrit l'emploi du temps du candidat, etc. La simple lecture de la proposition ne changera pas votre réservation ou quoi que ce soit.
À droite : Utiliser les outils et vérifier les résultats
Sélectionnez les étapes en fonction de votre objectif, poursuivez le travail à l'aide d'outils tels que la recherche et le calcul, et vérifiez les résultats.
Avoir un outil connecté et avoir l’autorité pour le faire fonctionner sont deux choses différentes. Pour l'envoi, l'achat, la suppression, etc., décidez de l'étendue de l'autorisation et des conditions d'approbation.
Il s'agit d'une illustration explicative qui a été remplacée par un bureau et du matériel.
Vérifier les résultats à l'aide d'outils
Combinez des opérations telles que la recherche des informations dont vous avez besoin, le calcul et la mise à jour des enregistrements. Même lorsque vous utilisez LLM, les opérations réelles sont effectuées via des outils et des systèmes connectés.
déterminer la portée de ce qui peut être fait
L'impact est différent pour les opérations telles que la simple lecture et les opérations telles que l'envoi, l'achat ou la suppression. Nous concevrons les outils pouvant être utilisés, les opérations qui nécessitent une approbation, les moyens de les arrêter à mi-chemin et les enregistrements d'exécution.
Par exemple:Proposer un rendez-vous ou confirmer une réservation
Si vous proposez simplement un horaire possible par écrit, votre réservation ne sera pas modifiée. Une fois que vous vous êtes connecté au système de réservation et que vous leur avez donné la permission de confirmer, ils peuvent agir.
sois prudent
Des performances élevées en matière de génération de texte ne garantissent pas à elles seules que la tâche qui vous est confiée sera accomplie en toute sécurité. Évaluez l’ensemble du flux, y compris les outils.
Dans AI Inc.
Les privilèges de publication et d’exécution de modèles sont des décisions distinctes. Même dans les jeux, lisez la portée de l’évaluation, de la supervision et des conditions d’accident avant de décider de la portée du comportement acceptable.
Réseaux de neurones et Transformer6
Du calcul des nombres à l'écriture de phrases. Facile à comprendre avec 6 illustrations.
MODEL / MECHANISM
Le calcul des nombres est
jusqu'à ce que cela devienne une phrase.
Passons d'abord aux petits calculs, puis passons aux mécanismes de traitement des phrases. Suivez le modèle invisible en 6 étapes.
Les calculs sont de petits modèles à titre d’illustration. Les opérations sur cette page ne modifieront pas le jeu ni n'enregistreront le contenu.
Que calcule un réseau de neurones ?
Il combine les valeurs d'entrée avec les poids déterminés par l'apprentissage et les convertit en prédictions via des couches. Une fois que vous avez compris un calcul, vous pouvez comprendre comment visualiser le modèle plus grand.
Que calcule un réseau de neurones ?
Il combine les valeurs d'entrée avec les poids déterminés par l'apprentissage et les convertit en prédictions via des couches. Une fois que vous avez compris un calcul, vous pouvez comprendre comment visualiser le modèle plus grand.
Il combine les valeurs d'entrée avec les poids déterminés par l'apprentissage et les convertit en prédictions via des couches. Une fois que vous avez compris un calcul, vous pouvez comprendre comment visualiser le modèle plus grand.
De la saisie à la prédiction.
3 à gauche, 4 au milieu et 2 à droite. Il s'agit d'un matériel pédagogique tridimensionnel qui combine des nombres couche par couche.
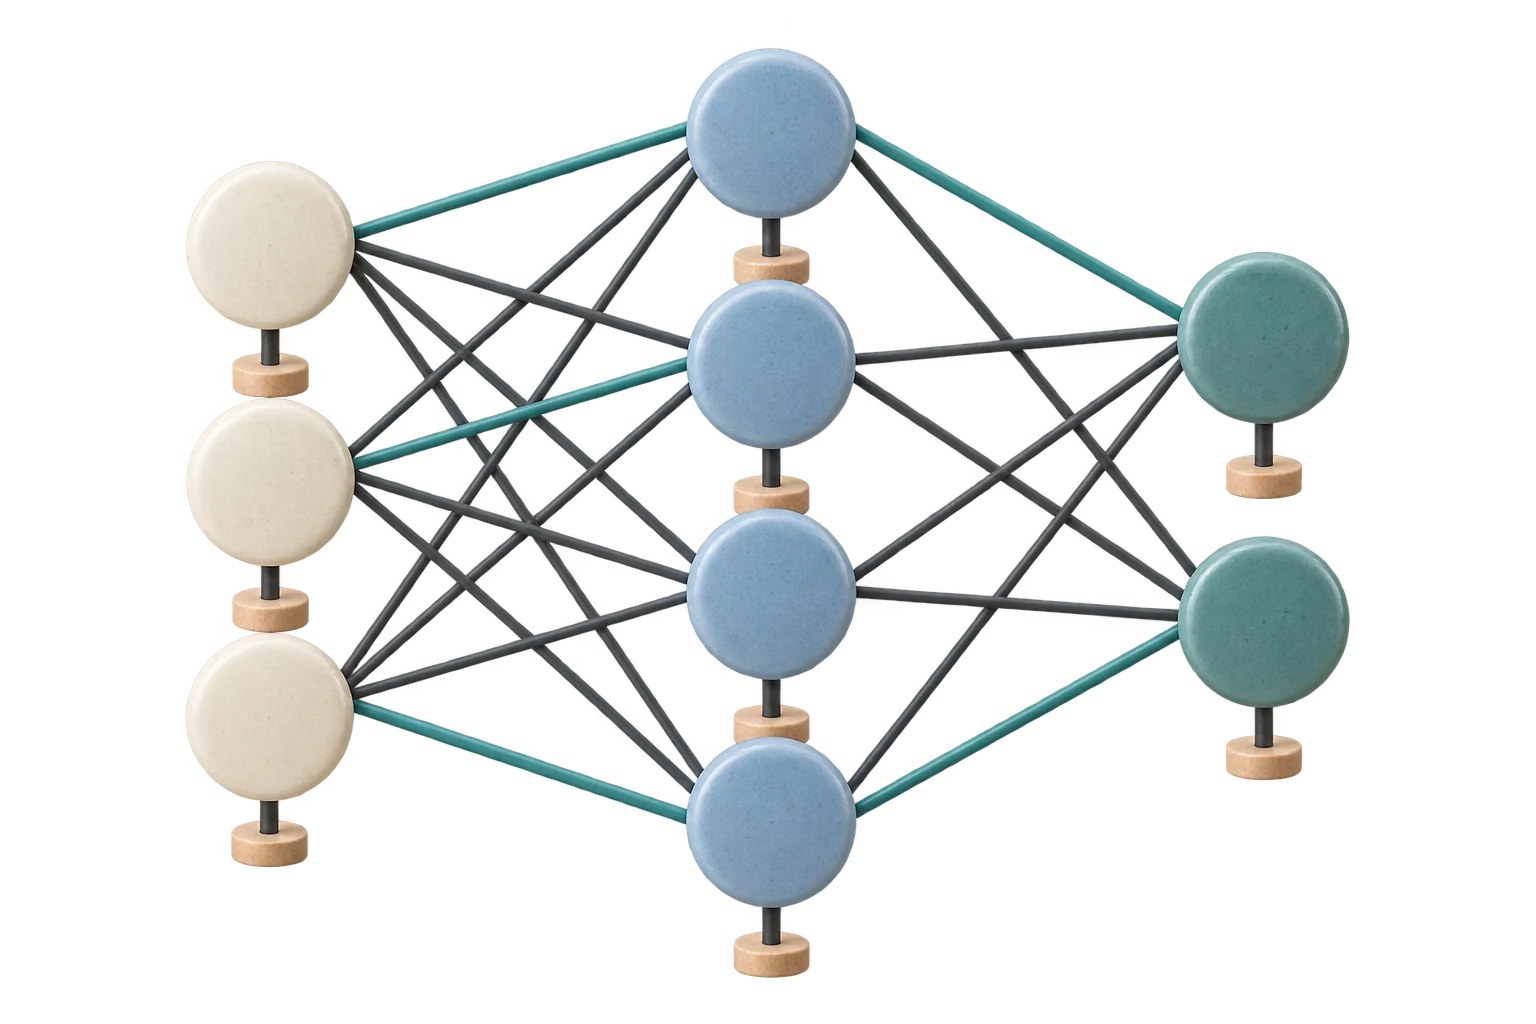
Gauche : recevoir une entrée
Convertissez des photos, du texte, etc. en nombres que le modèle peut gérer.
Centre : Combiner et convertir
Les poids, les biais et les fonctions d’activation produisent la représentation suivante.
À droite : Passer à la prédiction
Créez une sortie adaptée au travail. Même à ce stade, les réponses correctes ne sont pas garanties.
Tout d'abord, suivons le calcul d'un nœud en utilisant l'exemple ci-dessous. Vous pouvez également vérifier les effets des poids négatifs et de ReLU.
Il s'agit d'une illustration explicative montrant la disposition des couches. Le nombre, la couleur et l'épaisseur des lignes n'indiquent pas les connexions ou les poids dans le modèle réel.
Couche d'entrée : convertit les informations traitées en valeurs numériques
Transmettez un nombre que le modèle peut calculer, comme un pixel pour une photo ou une représentation symbolique pour un texte. La manière de créer une entrée varie en fonction des données traitées.
Couche cachée : Recombinaison des nombres
Chaque nœud multiplie les valeurs de la couche précédente par des poids, les additionne, puis ajoute un biais. Une fonction d’activation est appliquée au résultat avant son passage à la couche suivante. Les couches entre l’entrée et la sortie sont dites cachées.
Poids et biais : les valeurs ajustées pendant l’entraînement
Les poids déterminent l’influence de chaque entrée ; un poids négatif agit dans le sens d’une soustraction. Le biais décale la somme. Chaque nombre ne contient pas un savoir ou un fait particulier à lui seul.
Fonctions d'activation : De la simple addition aux relations complexes
ReLU remplace les valeurs négatives par zéro et conserve les autres. Empiler des couches purement linéaires revient à un seul calcul de même type. Des transformations non linéaires permettent des relations plus complexes.
Couche de sortie : modifiez la forme en fonction de la tâche
Convertissez l'expression finale en points de classification, valeurs prédites, etc. Tous les numéros de nœuds ne sont pas des probabilités. L'exemple ci-dessous montre également les résultats calculés.
Essayez de déplacer un nœud
Les entrées sont fixées à 1 et 2. Si vous modifiez les pondérations et les biais, comment la valeur additionnée et la sortie changeront-elles ?
- 01 / Multiplier et additionner
1 × 0.6 + 2 × (−0.2) + 0.1
Multipliez les entrées par les poids, faites la somme, puis ajoutez le biais.
- 02 / Appliquer ReLU
max(0, 0.3)
S'il est négatif, il vaut 0. S'il est supérieur ou égal à 0, il est transmis tel quel.
total 0.3→sortir 0.3
Essayez-le : si vous donnez un poids de 1 à -0,6, la somme est de -0,9 et le résultat est 0. Ce résultat n'est pas une probabilité ou un taux de réponse correct.
Par exemple:Calculer un nœud
Avec les entrées 1 et 2, les poids 0,6 et −0,2 et le biais 0,1 : 1 × 0,6 + 2 × (−0,2) + 0,1 = 0,3. ReLU conserve 0,3. Modifiez les poids et observez aussi la sortie lorsque la somme devient négative.
sois prudent
Le nom neurone a été inspiré par le cerveau. Il s’agit ici de calcul numérique, et il ne s’agit pas d’une reproduction directe du fonctionnement du cerveau.
Le schéma explique les couches d’entrée, cachées et de sortie. Il existe d’autres architectures de réseaux de neurones, dont les convolutions pour les images et les Transformer.
Dans AI Inc.
Les données, la conception du modèle et les ressources informatiques conduisent à des raisons liées aux résultats et aux coûts d'apprentissage. Ce bouton de réglage de l'aide sert à apprendre son fonctionnement et ne modifie pas le modèle de jeu ni les sauvegardes.
Quelles valeurs l’entraînement modifie-t-il ?
Mesurez l'écart entre la prédiction et la bonne réponse, et ajustez les poids petit à petit pour réduire l'écart. Séparons la lecture de la réponse de la mise à jour des chiffres dans le modèle.
Quelles valeurs l’entraînement modifie-t-il ?
Mesurez l'écart entre la prédiction et la bonne réponse, et ajustez les poids petit à petit pour réduire l'écart. Séparons la lecture de la réponse de la mise à jour des chiffres dans le modèle.
Mesurez l'écart entre la prédiction et la bonne réponse, et ajustez les poids petit à petit pour réduire l'écart. Séparons la lecture de la réponse de la mise à jour des chiffres dans le modèle.
① Propagation avant : produire une prédiction
Calculez de l’entrée à la sortie en utilisant les poids actuels. Il s’agit d’une propagation vers l’avant. À ce stade, nous n’avons pas déterminé si cette réponse est proche de la bonne réponse ou non.
② Mesurer la perte : quantifier l’écart adapté
Une fonction de perte compare prédiction et cible d’entraînement. L’exemple utilise l’écart au carré. Pour prédire le token suivant, l’entropie croisée utilise notamment la probabilité attribuée au bon token. La mesure doit être adaptée à la tâche.
③ Rétropropager : trouver la direction du changement
La rétropropagation calcule comment la perte varie si chaque poids change légèrement. Cette variation est décrite par le gradient. Le calcul remonte de la sortie vers l’entrée et sert à ajuster plusieurs couches.
④ Mettre à jour : choisir aussi le pas
Les poids sont actualisés avec le gradient et le taux d’apprentissage. Ce taux détermine la taille du pas ; trop élevé, il peut augmenter la perte. En pratique, l’entraînement est répété sur de nombreux exemples, puis évalué sur d’autres exemples non utilisés.
Actualiser le poids, une étape à la fois
La valeur d’entrée est fixée à 2, la cible à 1 et le taux d’apprentissage à 0,1. Le modèle n’a qu’un poids : prédiction = 2 × poids, perte = (prédiction − 1)².
mise à jour 0·prédiction 0.2·perte 0.64
Pente dans cet exemple = 4 x (2 x poids - 1)
Nouveau poids = poids actuel - taux d'apprentissage x gradient
0.1 − 0.1 × (−3.2) = 0.42
Dans la première mise à jour, nous créons un dégradé négatif, donc le poids augmente.
| Nombre de mises à jour | poids | prédiction | perte |
|---|---|---|---|
| 0 | 0.1 | 0.2 | 0.64 |
Cet exercice ajuste un modèle à un seul exemple d’entraînement. Les réseaux réels calculent par rétropropagation les gradients de nombreux poids et sont aussi évalués sur des données non utilisées à l’entraînement.
Par exemple:Rapprocher la prédiction 0,2 de la bonne réponse 1
Avec une entrée de valeur 2 et un poids de 0,1, la prédiction vaut 0,2 et la perte (0,2 − 1)² = 0,64. Au taux d’apprentissage 0,1, la première mise à jour donne un poids de 0,42, une prédiction de 0,84 et une perte de 0,0256. Suivez ci-dessous chaque mise à jour du même exemple.
sois prudent
L’exemple utilise un modèle à un seul poids et un seul exemple d’entraînement. Il ne reproduit pas la rétropropagation d’un réseau neuronal complet.
Une baisse de perte dans cet exemple simple ne garantit ni la réussite de l’entraînement d’un grand modèle ni de bonnes réponses aux questions inconnues. Attention au surapprentissage : bien réussir seulement sur les exemples d’entraînement.
Dans AI Inc.
C’est pourquoi il faut distinguer fin de la recherche, entraînement principal et évaluation finale. Dans le jeu aussi, comparez prévisions avant entraînement et résultats après achèvement pour décider du prochain investissement.
Comment les phrases deviennent-elles des nombres ?
Divisez le texte en jetons et utilisez des identifiants pour les transformer en séquences numériques. Nous combinerons cette expression numérique avec les informations environnantes.
Comment les phrases deviennent-elles des nombres ?
Divisez le texte en jetons et utilisez des identifiants pour les transformer en séquences numériques. Nous combinerons cette expression numérique avec les informations environnantes.
Divisez le texte en jetons et utilisez des identifiants pour les transformer en séquences numériques. Nous combinerons cette expression numérique avec les informations environnantes.
Jeton et ID : décidez de l'unité à gérer
La tokenisation divise le texte en petites unités et attribue un identifiant à chacune. L'ID est un numéro d'identification et sa taille n'indique pas la force du sens du mot. Ils n’ont pas toujours une correspondance exacte avec les mots et caractères japonais.
Intégration : de l'ID à la séquence numérique apprise
L’ID permet de retrouver un vecteur dans la table de plongements. Ce vecteur est une suite de nombres dont les composantes ne désignent pas forcément des qualités lisibles comme la gentillesse ou l’intelligence.
Position : transmettre aussi l’ordre des éléments
« L’entreprise crée le modèle » et « Le modèle crée l’entreprise » diffèrent par l’ordre des éléments. Les Transformer utilisent aussi des informations de position ou de distance relative, intégrées selon leur architecture.
Expression en contexte : changements en combinaison avec l'environnement
À partir du premier intégration, chaque calque le combine avec la représentation environnante. Même si le jeton est le même, l'expression au milieu change en fonction du contexte. Le simple remplacement de l'ID ne complète pas l'interprétation du texte.
Des identifiants de tokens aux vecteurs de nombres
Regardez les « modèles d'entreprise » dans la division hypothétique. En utilisant l'ID comme indice, extrayez le vecteur de la table intégrée.
Vous pouvez lire le tableau en le déplaçant vers la gauche et la droite.
| position | jeton | ID | Plongement à trois composantes |
|---|---|---|---|
| 1 | entreprise | 120 | [0.2, −0.4, 0.7] |
| 2 | mais | 8 | [−0.1, 0.3, 0.2] |
| 3 | modèle | 305 | [0.6, 0.1, −0.2] |
| 4 | de | 9 | [0.1, −0.2, 0.4] |
- supprimer l'intégration
Produire la première représentation numérique d’un token.
- Utilise également les informations de localisation
Intégrer l’ordre des mots et les distances selon la méthode prévue par l’architecture.
- Capturez les informations environnantes
Au fur et à mesure qu'elle traverse chaque couche, l'expression change en fonction du contexte.
ID305 n’a pas plus de sens qu’ID120. Découpage, dimensions et valeurs varient selon le modèle ; chaque composante du vecteur n’a pas nécessairement de sens interprétable par l’humain.
Par exemple:Lisez le mot « modèle » comme entourant.
« Évaluer un modèle d’IA » et « exposer une maquette d’architecture » n’ont pas le même contexte. Le calcul intègre les informations voisines dans la représentation des tokens.
sois prudent
La division, l'ID et le vecteur à 3 composantes du diagramme sont des exemples fictifs d'explication. Le partitionnement réel, le nombre de dimensions et les nombres varient en fonction du modèle.
Dans AI Inc.
Lors du choix de la longueur du contexte et de l'utilisation des données, il est utile de prendre en compte la quantité d'informations à traiter et la charge de calcul liée à l'utilisation de ces informations.
De quels éléments se compose un Transformer ?
L’Attention mélange les informations entre positions ; le Feed-Forward transforme chaque position. Le réseau empile ces blocs.
De quels éléments se compose un Transformer ?
L’Attention mélange les informations entre positions ; le Feed-Forward transforme chaque position. Le réseau empile ces blocs.
L’Attention mélange les informations entre positions ; le Feed-Forward transforme chaque position. Le réseau empile ces blocs.
Mélanger les informations. Transformer les représentations.
De haut en bas. La carte représente un bloc répétitif et les deux cadres représentent un bloc répétitif.
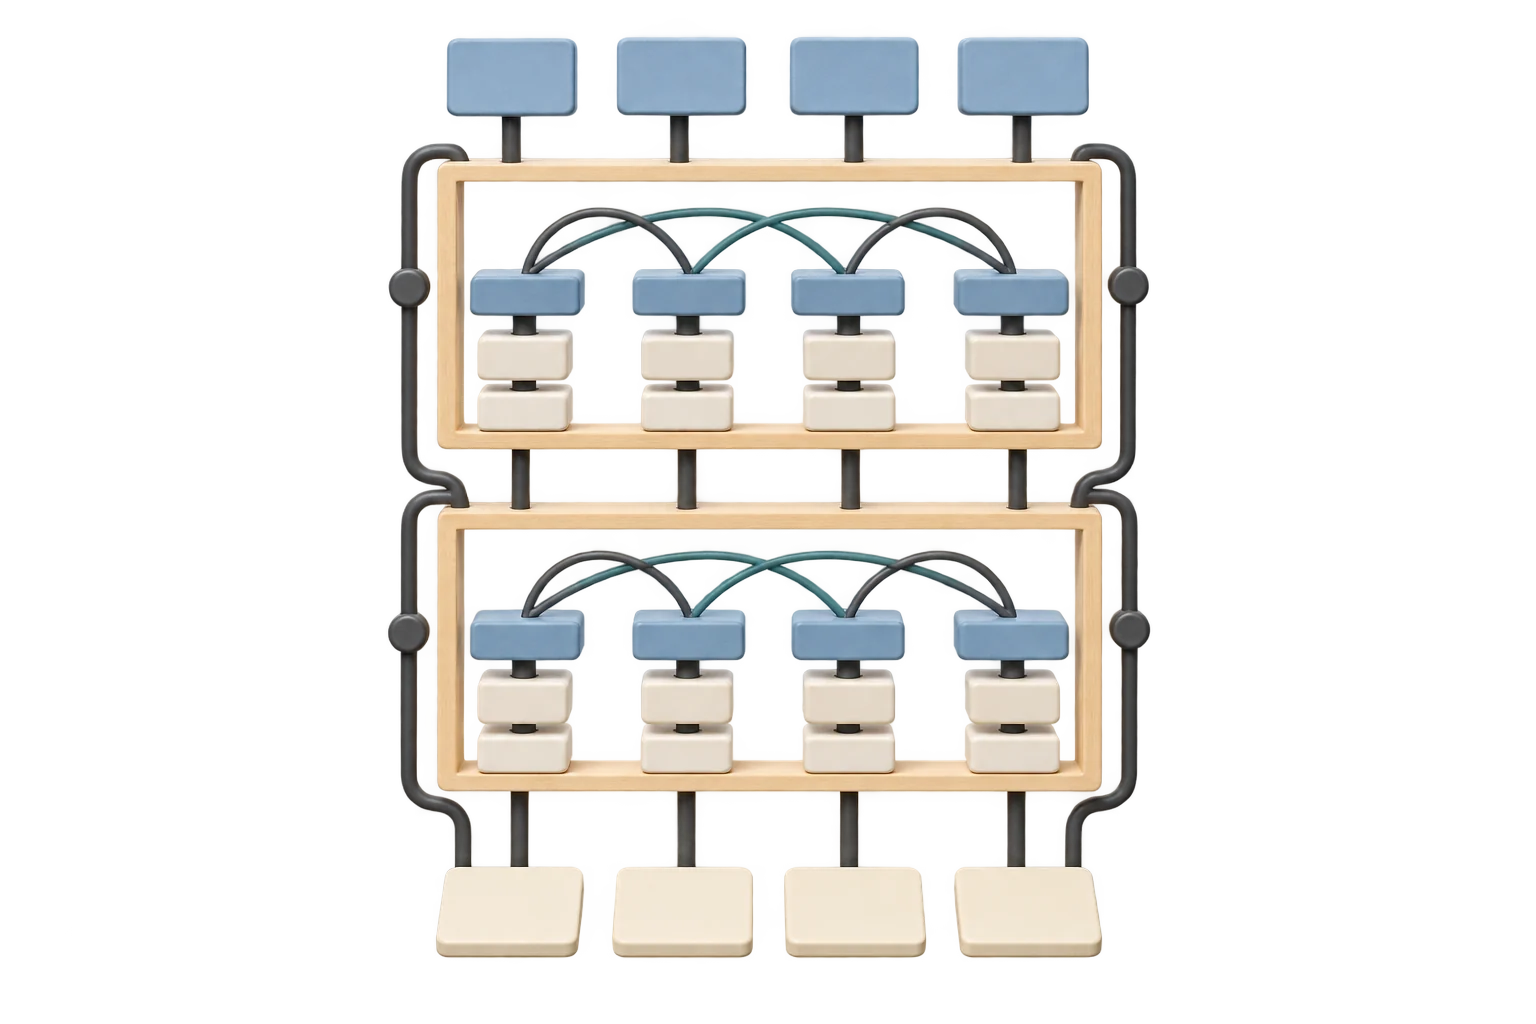
Carte du dessus : expression d'entrée
Convertissez les tokens en nombres et ajoutez les informations de position.
Deux cadres : empiler les blocs
Mélangez les informations entre les positions et convertissez la représentation de chaque position. Le chemin secondaire est une métaphore qui préserve l’expression originale.
Carte du bas : Représentation après traitement
Dans la génération de phrases, il existe une partie qui calcule les scores de vocabulaire et les probabilités.
Le modèle ne se limite pas à l’Attention. Le schéma ci-dessous détaille l’ordre des opérations et leurs rôles.
Illustration conceptuelle d’un décodeur. Les deux blocs et quatre cartes servent à expliquer, sans représenter un modèle précis ni toute l’architecture originale.
Attention : intégrer les autres positions
Calculez l'emplacement et la quantité d'informations à importer. Un emplacement éloigné est également un candidat. Dans la structure qui génère les phrases, limitez la plage de références pour éviter de voir les futurs jetons.
Feed-Forward : le même calcul pour chaque position
Après l’Attention, une transformation apprise, notamment non linéaire, est appliquée à chaque position. Une même couche partage ses paramètres entre toutes les positions.
Connexions résiduelles et normalisation : empiler les blocs
Une connexion résiduelle ajoute la représentation initiale au résultat nouvellement calculé. La normalisation ajuste l’échelle des valeurs. Ensemble, elles permettent d’empiler les blocs. L’emplacement de la normalisation dépend de l’architecture.
Résultat final : vers le score du prochain candidat symbolique
Pour générer du texte, la représentation de la dernière position devient un score pour chaque élément du vocabulaire. Softmax transforme ces scores en probabilités, puis le token suivant est choisi. Les poids d’Attention et les probabilités des tokens de sortie sont des valeurs distinctes.
Flux de type décodeur utilisé pour la génération de phrases
Lisez de haut en bas. La fiche illustrée correspond à « expression numérique », et le cadre correspond à « traitement répété ».
- saisirJeton → Intégrer/informations de localisation
Convertissez des phrases en expressions pouvant être utilisées dans les calculs.
- Répéter les blocs Transformer01 / Entre les positionsMulti-Head Self-Attention
Masque l’emplacement futur et mélange les informations sur l’emplacement qui peuvent être référencées.
Ajouter connexions résiduelles et normalisation02 / Pour chaque positionFeed-Forward(FFN)Le même calque utilise les mêmes poids et transforme la représentation de chaque position de manière non linéaire.
Ajouter connexions résiduelles et normalisationLes deux blocs de la figure sont uniquement à titre d'explication. Le nombre réel varie selon le modèle.
- La partie qui crée la sortieReprésentation de la dernière position → scores du vocabulaire → Softmax
Calculez la probabilité du prochain jeton candidat consécutif.
- GénérerSélectionnez le jeton suivant et ajoutez-le au contexte
Utilisez le contexte ajouté pour passer au candidat suivant.
Les connexions résiduelles ajoutent la représentation initiale ; la normalisation ajuste l’échelle des valeurs. Sa place avant ou après un composant dépend de l’architecture. Le schéma ne montre pas l’intégralité de l’Encoder–Decoder de l’article d’origine.
| composition | Portée et but de la lecture |
|---|---|
| Encoder | Utilisez avant et après la saisie pour créer des expressions dans des phrases. Utilisé pour la classification et les expressions de recherche. |
| Decoder | Générez la suite en utilisant les informations jusqu'à chaque position. La configuration illustrée ici. |
| Encoder–Decoder | Combinez le côté qui lit l’entrée et le côté qui génère la sortie. L'article original traite de cette structure en traduction. |
Par exemple:Ce à quoi « cela » fait référence est lu comme le contexte.
Dans « L’entreprise a publié un nouveau modèle. Il peut résumer des textes », les informations sur « modèle » aident à traiter « il ». Chaque couche transforme ensuite cette représentation pour préparer la sortie suivante. L’article suivant détaille le calcul d’Attention.
sois prudent
La figure est un schéma simplifié permettant de comprendre le modèle génératif de type Décodeur. Il ne s'agit pas de l'intégralité de l'encodeur-décodeur dans le document d'origine ou d'un schéma de configuration d'un produit spécifique.
Les deux blocs sont uniquement à des fins d’illustration. Le nombre réel de couches, la largeur, la fonction d'activation et les informations de position varient en fonction du modèle.
Dans AI Inc.
Cela fournit une base pour considérer la conception du modèle, les ressources informatiques requises et la charge de fourniture. Le niveau de recherche et les valeurs de performance du jeu ne sont pas la composition réelle ou les valeurs de mesure elles-mêmes.
À quoi servent Q, K et V dans la Self-Attention ?
Créez un Q pour rechercher les informations que vous souhaitez importer, un K pour vérifier et un V pour importer réellement les informations, et mélangez les V en fonction de la force de la relation.
À quoi servent Q, K et V dans la Self-Attention ?
Créez un Q pour rechercher les informations que vous souhaitez importer, un K pour vérifier et un V pour importer réellement les informations, et mélangez les V en fonction de la force de la relation.
Créez un Q pour rechercher les informations que vous souhaitez importer, un K pour vérifier et un V pour importer réellement les informations, et mélangez les V en fonction de la force de la relation.
Attention : les relations dans la phrase
Les relations entre éléments éloignés les uns des autres sont également incluses dans le calcul.
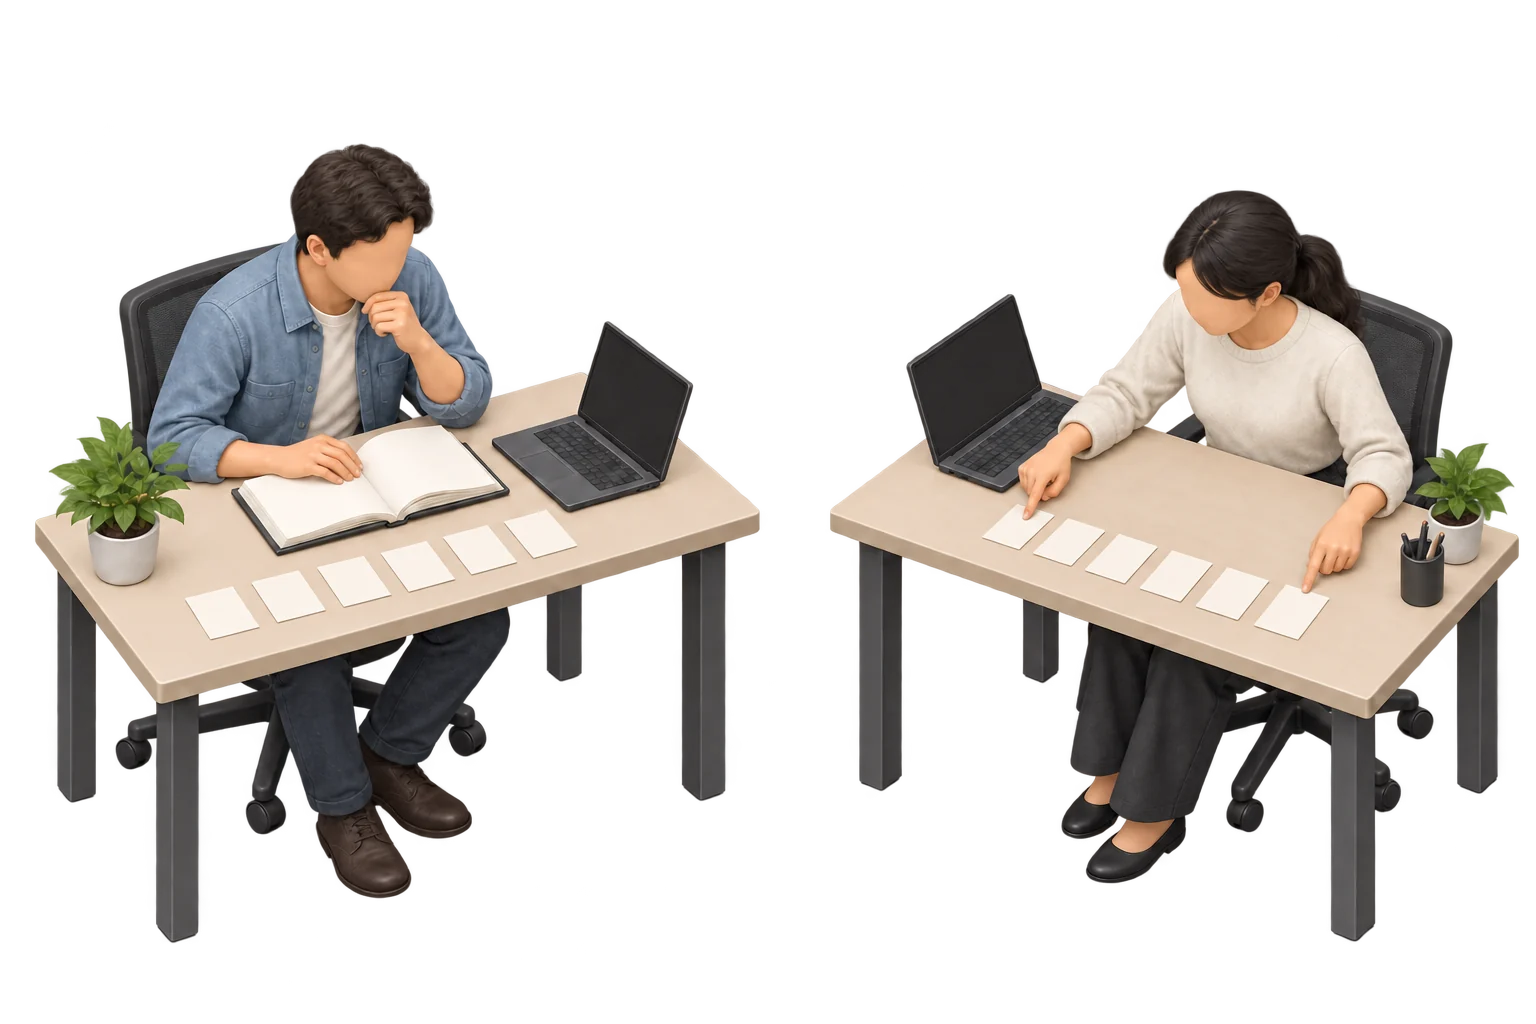
Voir la relation entre « ça » et « modèle »
L’entreprise a publié un nouveau modèle. Il peut résumer des textes.
un nouveau modèleetIl
Dans cette phrase, la relation entre « ça » et « modèle » est un indice. Les relations entre des mots éloignés les uns des autres sont également prises en compte.
Cet exemple explique les relations entre les mots. Il ne montre pas de véritables poids d’Attention.
calculer les relations en entrée
La Self-Attention calcule, pour un token, la relation avec les autres tokens de la même entrée.
Créer des expressions qui correspondent au contexte
Nous intégrons ces relations dans nos calculs et créons des représentations contextuelles à travers plusieurs couches.
Les morceaux de papier symbolisent les éléments du texte. Les tokens réels ne correspondent pas toujours à des mots. Attention désigne un calcul, pas une conscience humaine.
Il s'agit d'une illustration explicative qui a été remplacée par un bureau et du matériel.
Q et K : des représentations numériques à comparer
Modifiez la représentation de chaque position en Q (Requête), K (Clé) et V (Valeur) à l'aide de la transformation apprise. Calculez le produit scalaire de Q et K et créez un score ajusté en fonction du nombre de dimensions. Q est une métaphore similaire à une requête de recherche, mais ce n'est pas une question dans le texte lui-même.
Softmax : transformer les scores en répartition
Softmax transforme les scores des positions accessibles en poids dont la somme vaut 1. Dans l’exemple génératif, les positions futures sont masquées au préalable : leur poids vaut 0.
V : pondérer et mélanger les informations
Chaque V est multiplié par son poids d’Attention, puis les résultats sont additionnés. Le calcul ne choisit pas simplement un mot : il intègre les informations de plusieurs positions accessibles.
Multi-Head : plusieurs transformations en parallèle
Chaque chef avec différentes transformations apprises calcule la relation et résume les résultats. Les gens ne décident pas nécessairement du rôle de chaque chef, et cela ne signifie pas nécessairement qu'ils se spécialisent dans la grammaire ou les pronoms. L'exemple ci-dessous n'a qu'une seule tête.
Calculer la répartition avec Q, K et V
Exemple fictif à trois positions, deux composantes et une tête. Q est comparé aux K de chaque position, puis les poids mélangent les V. Ce calcul ne sélectionne pas le prochain mot dans le vocabulaire.
Cible Q = [1, 1]
Score = produit scalaire de Q et K ÷ √2
Vous pouvez lire le tableau en le déplaçant vers la gauche et la droite.
| position | K : pour la comparaison | V : informations à mélanger | score |
|---|---|---|---|
| 1「entreprise」 | [1, 0] | [0.4, 0.1] | 0.707 |
| 2「modèle」 | [1, 1] | [0.8, 0.6] | 1.414 |
| 3「que」 | [0, 1] | [0.1, 0.2] | 0.707 |
Répartition après Softmax : total de 100 %
- 1「entreprise」24.8%
- 2「modèle」50.3%
- 3「que」24.8%
position3「que« résultat mitigé [0.527, 0.377]。Masquage de l'emplacement futur.
Résultat = 0.248 × [0.4, 0.1] + 0.503 × [0.8, 0.6] + 0.248 × [0.1, 0.2]
Chaque V est multiplié par la distribution et ajouté pour chaque composant. Les valeurs affichées sont arrondies, le total affiché peut donc différer de 100 %.
Essayez-le : si vous choisissez la position 1, il n'utilisera que la position 1 à 100 % s'il existe un masque causal. Si vous retirez le masque, les postes ultérieurs deviendront également candidats. Les nombres ne sont pas des mesures de modèles réels.
Par exemple:Calculer avec des valeurs fictives pour « il »
L’exemple utilise Q, K et V pour trois positions. Le produit scalaire du Q choisi et de chaque K est divisé par √2, puis passe dans Softmax. Si vous choisissez une position antérieure, les positions futures sont masquées dans cet exemple génératif. Comparez les poids et le résultat du mélange.
sois prudent
La segmentation, Q, K, V et les scores sont fictifs. Ils ne mesurent pas l’Attention d’un modèle réel et ne prouvent pas qu’il a correctement appris les relations de sens.
Les poids d’Attention varient avec l’entrée. Cela ne signifie pas, en soi, que les paramètres entraînés sont mis à jour.
Attention désigne un calcul, ni une conscience humaine ni une garantie de réponses correctes.
Dans AI Inc.
Cela explique pourquoi la mémoire est utilisée dans les calculs qui gèrent des contextes et des inférences longs. Lorsque nous envisageons l’offre des clients, nous examinons ensemble la qualité du modèle et la charge en ressources.
Comment un LLM poursuit-il un texte ?
Ici, nous examinerons la génération de phrases autorégressives. Calcule la probabilité du prochain jeton à partir du contexte transmis, ajoute le jeton sélectionné au contexte et calcule le suivant.
Comment un LLM poursuit-il un texte ?
Ici, nous examinerons la génération de phrases autorégressives. Calcule la probabilité du prochain jeton à partir du contexte transmis, ajoute le jeton sélectionné au contexte et calcule le suivant.
Ici, nous examinerons la génération de phrases autorégressives. Calcule la probabilité du prochain jeton à partir du contexte transmis, ajoute le jeton sélectionné au contexte et calcule le suivant.
Ne mélangez pas les suites inachevées avec l'entrée
Lors de la génération, il utilise les instructions et la sortie précédente. Même lors du traitement côte à côte de phrases avec des réponses correctes pendant l'apprentissage, un masque causal est utilisé pour empêcher chaque position de voir les futures réponses correctes. Être capable de calculer plusieurs positions d'apprentissage en parallèle est une chose, et être capable de voir les réponses futures en est une autre.
Choisir en fonction de la probabilité : ce n'est pas toujours le meilleur candidat
Il existe des méthodes pour sélectionner des candidats avec une probabilité élevée et des méthodes pour sélectionner des candidats basées sur la probabilité. La sortie varie en fonction de la méthode de sélection et des paramètres tels que la température. Cette répétition ne peut pas être vue simplement en disant que la réponse entière peut être complétée en une seule fois.
Le jeton sélectionné devient également le contexte suivant.
Ajoutez le jeton généré au contexte et calculez le prochain candidat. Cela continue jusqu'à ce qu'il atteigne un jeton indiquant la fin, une limite de sortie, etc. Puisque la sélection est répétée, les différences dans la sortie initiale affecteront également les phrases suivantes.
Continuez votre sélection jusqu'à l'entrée suivante
La division et la probabilité sont fictives. Pour que ce soit plus facile à voir, voici un exemple dans lequel des candidats ayant une forte probabilité sont sélectionnés.
- 01
- contexte actuel
- de l’IA
- prochain candidat
- Recherche 60% · Utilisation 25% · Autres 15%
- choisir
- l'étude
- Contexte suivant
- recherche en IA
- 02
- contexte actuel
- recherche en IA
- prochain candidat
- 70% · 20% · Autres 10%
- choisir
- de
- Contexte suivant
- la recherche en IA
- 03
- contexte actuel
- la recherche en IA
- prochain candidat
- Avance 55% · Soutien 30% · Autres 15%
- choisir
- procéder
- Contexte suivant
- faire avancer la recherche en IA
En réalité, la méthode de sélection varie en fonction des paramètres, comme par exemple la loterie basée sur les probabilités. La probabilité du prochain jeton n’est pas la probabilité que le contenu soit vrai. La génération normale ne met pas à jour les poids appris pour chaque réponse.
Par exemple:Poursuivre « L’IA » pas à pas
À des fins d'explication, le processus consisterait à ajouter « recherche » aux « IA », à ajouter « wo » à « recherche de l'IA », puis à calculer le candidat suivant. Les candidats et les probabilités du diagramme sont fictifs. Les tokenisations et candidats réels varient en fonction du modèle et du contexte.
sois prudent
La probabilité du prochain jeton n’est pas la probabilité que le contenu soit vrai. Des erreurs peuvent se produire même dans des phrases naturelles, alors vérifiez-les par rapport aux matériaux et aux résultats des calculs.
Lors de la génération normale de phrases, les poids appris ne sont pas mis à jour à chaque fois que la réponse est donnée. L'apprentissage supplémentaire est un processus distinct.
Les implémentations d'inférence peuvent réutiliser les calculs existants, comme dans les caches KV. Le diagramme montre le flux d’informations et ne signifie pas qu’il faut tout recalculer à partir de zéro à chaque fois.
Dans AI Inc.
Lors de la fourniture de services aux clients, des ressources informatiques sont nécessaires pour que l'inférence produise des phrases. Nous séparons les coûts d'apprentissage pour compléter le modèle et la fourniture et les coûts pour une utilisation continue.
La recherche en IA aujourd’hui10
Vérifié le 5 octobre 2026. Neuf tendances issues de publications scientifiques récentes, avec leurs résultats et leurs limites.
Date de confirmation · Dix publications de mai à septembre 2026
De la capacité de formuler des réponses à la capacité d’accomplir de longues tâches. Découvrez les orientations de recherche tirées d'articles récents, notamment sur la manière d'utiliser les calculs, la fiabilité des preuves et la conception de l'évaluation et de l'autorité.
Comment dois-je lire les dernières tendances en matière de recherche ?
Ici, nous présenterons neuf directions issues de 10 articles publiés de mai à septembre 2026. Les cibles incluent l'inférence, les agents, la mémoire, l'efficacité, la parole, les modèles mondiaux, la fiabilité, l'évaluation et la conception d'autorité.
Ici, nous présenterons neuf directions issues de 10 articles publiés de mai à septembre 2026. Les cibles incluent l'inférence, les agents, la mémoire, l'efficacité, la parole, les modèles mondiaux, la fiabilité, l'évaluation et la conception d'autorité.
Lisez ce que nous avons changé et comparé à
Passez en revue le modèle, les données, le budget de calcul et les critères d'évaluation. Les valeurs numériques obtenues dans différents articles ne peuvent pas être classées directement si les conditions sont différentes. Chaque section décrit séparément la méthode et les résultats observés.
La date de publication et l’adoption/vérification sont distinctes.
Les prépublications sont des manuscrits qui peuvent être publiés avant même d'avoir été évalués par des pairs dans des revues universitaires ou des conférences. Pour les articles qui ont été approuvés par une conférence, cela sera indiqué. L’adoption ou des scores élevés ne suffisent pas à confirmer l’efficacité dans toutes les applications.
| Que voir | pour confirmer |
|---|---|
| sujet | Avec quels modèles, langages, données et défis avez-vous essayé ? |
| Conditions de comparaison | Avez-vous comparé la quantité de calculs, le nombre d'essais et l'équipement ? |
| indice | Réussite au premier essai ou au moins un bon candidat ? |
| reproductibilité | Pouvez-vous confirmer la méthode, le code, les données et la version du document ? |
| limite | Quelles conditions n’ont pas été vérifiées ou quelles vérifications supplémentaires sont requises ? |
Par exemple:Même si le taux de bonnes réponses est élevé, le nombre de tentatives est différent
La précision d’une réponse unique et la proportion d’essais contenant au moins un bon candidat sont différentes. Vérifiez tâche, modèle, nombre de candidats et budget de calcul. Un score élevé ne rend pas à lui seul chaque réponse plus fiable.
sois prudent
Cette page contient des explications basées sur les articles sélectionnés. Il ne représente pas un consensus à l’échelle du domaine ni un classement mis à jour des produits du monde réel. Nous faisons également la distinction entre les résultats de la recherche et la mise en œuvre du jeu.
Raisonnement : pas seulement plus de calculs, mais des façons de penser différentes
Dans une recherche qui génère de nombreux candidats lorsqu’ils répondent, le défi est de répéter les mêmes erreurs. PTTS établit d'abord différentes stratégies de solution et crée chaque candidat en fonction de cette stratégie.
Dans une recherche qui génère de nombreux candidats lorsqu’ils répondent, le défi est de répéter les mêmes erreurs. PTTS établit d'abord différentes stratégies de solution et crée chaque candidat en fonction de cette stratégie.
Avant d'augmenter le nombre de candidats, séparez les stratégies de solutions
Préparez d’abord plusieurs politiques et créez des réponses candidates en fonction de chacune.
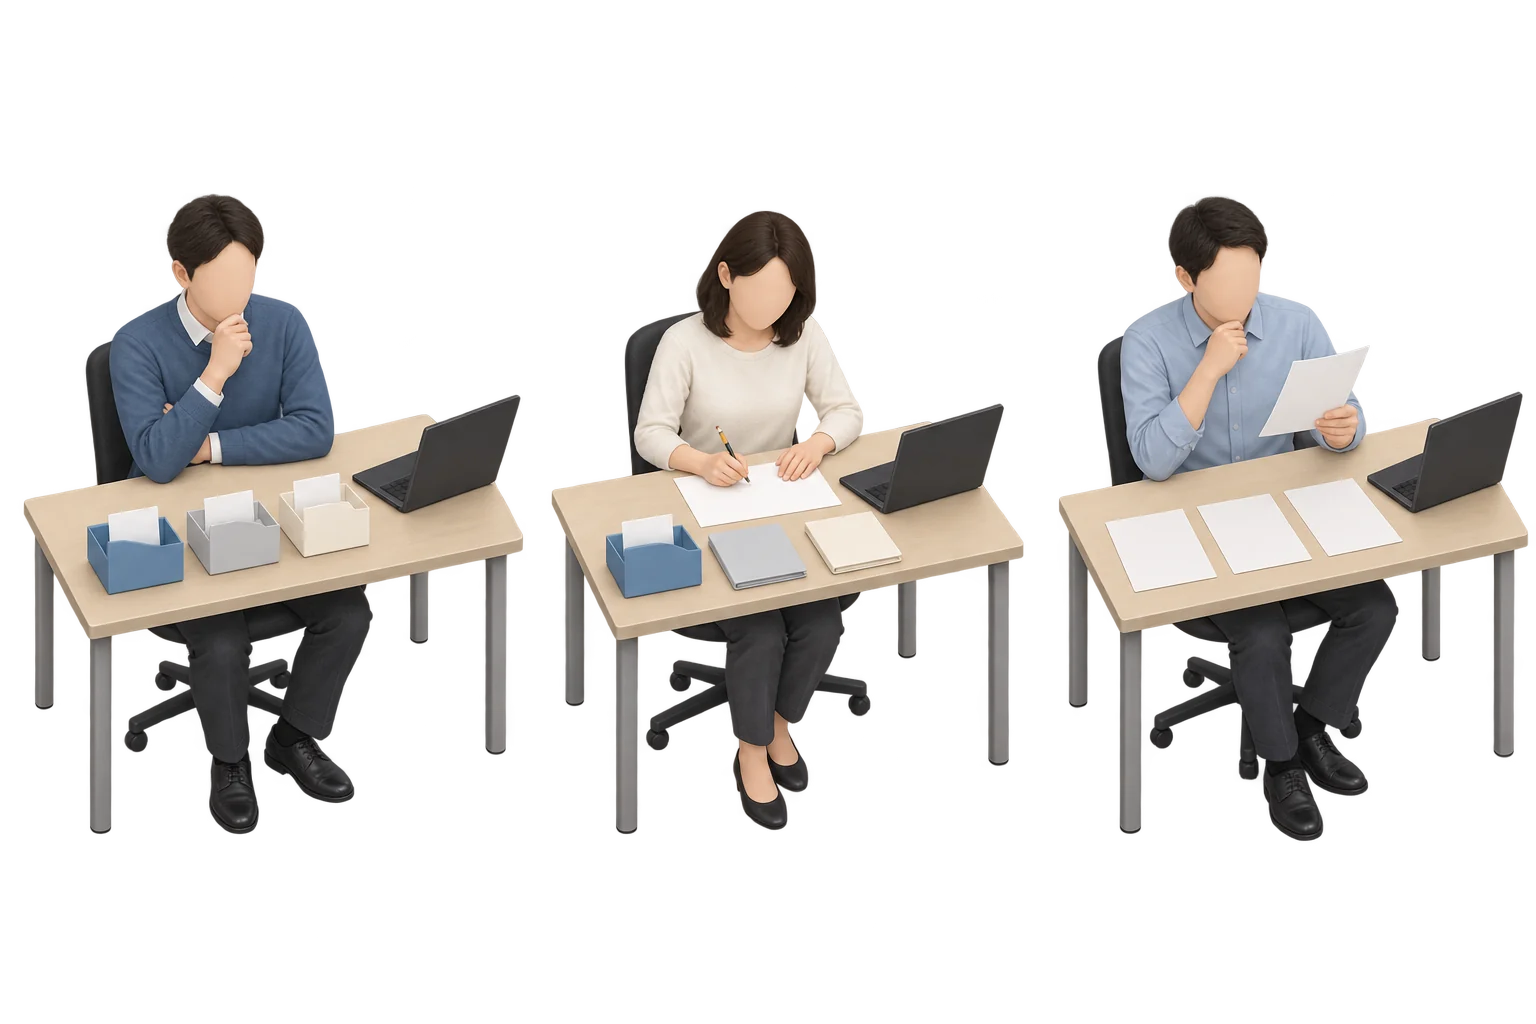
Gauche : Créez d’abord une stratégie différente
Planifiez comment vous allez essayer de résoudre le même problème. Dans le PTTS, les décideurs politiques examinent plusieurs candidats à la fois et visent à réduire la concentration sur des essais similaires.
Centre : Créer des candidats conformément à la politique
L'exécuteur crée des réponses candidates en utilisant le problème et chaque stratégie. Préparer une politique et apporter une réponse concrète sont deux rôles différents.
Droite : Mesurez si le candidat a la bonne réponse
Évaluez les réponses candidates et mesurez si au moins une réponse est correcte. Considérez l'inclusion de la bonne réponse et la possibilité de la sélectionner et de la renvoyer à l'utilisateur.
pass@k vérifie qu’au moins un des k candidats est correct. Ce n’est ni la précision d’une réponse unique ni la capacité à choisir la bonne.
L'étui à cartes, le dossier et le papier sont des métaphores d'explication. La couleur du conteneur représente la différence de politique et non le classement des performances. Le nombre de feuilles de papier ou le nombre de personnes n'indiquent pas le nombre de tentatives ou de modèles pour un article. La situation à droite ne garantit pas non plus que la bonne réponse sera automatiquement sélectionnée.
Comment utiliser les calculs dans le modèle entraîné
La méthode d'utilisation de calculs supplémentaires pendant l'inférence est appelée mise à l'échelle du temps de test. Chez PTTS, nous réfléchissons également aux moyens de séparer les créateurs de politiques et ceux qui les mettent en œuvre, et d'utiliser l'apprentissage par renforcement pour ajuster les créateurs de politiques.
Ce que rapporte le journal
Sur cinq évaluations mathématiques avec Qwen3 1.7B et 4B, pass@64 progresse face aux générations répétées indépendantes. Cet indicateur vérifie qu’au moins un des 64 candidats est correct.[R01]
Portée des résultats et défis restants
Être capable de sélectionner de manière fiable la bonne réponse parmi plusieurs candidats et d'obtenir la même amélioration avec une seule réponse sont d'autres défis. Vous devez également vérifier les travaux non mathématiques, le temps d'attente et les coûts en fonction de votre objectif.
Par exemple:Si un seul des quatre candidats est correct
Supposons que vous créiez quatre réponses candidates pour une certaine question et qu’une seule soit correcte. Ce problème compte comme un succès dans pass@4. Regardez ce pourcentage de réussite pour plusieurs problèmes. Cela ne signifie pas que vous obtenez la bonne réponse 1 fois sur 4, ni que vous pouvez certainement choisir la bonne réponse. Les exemples de 4 candidats sont uniquement à des fins d'illustration et ne reproduisent pas les performances de l'article.
Dans AI Inc.
Cela conduit à des décisions qui prennent en compte non seulement les performances de la recherche, mais également les ressources d'inférence nécessaires à fournir aux clients. Cela ne signifie pas que PTTS peut être configuré individuellement dans le jeu.
Agent : Des opérations intermédiaires à l'évaluation des produits terminés
Même si vous savez rechercher et utiliser des outils, cela ne signifie pas nécessairement que vous pouvez accomplir une longue tâche. KNOWS évalue le travail Web qui collecte des informations, les organise et crée des documents et autres livrables.
Même si vous savez rechercher et utiliser des outils, cela ne signifie pas nécessairement que vous pouvez accomplir une longue tâche. KNOWS évalue le travail Web qui collecte des informations, les organise et crée des documents et autres livrables.
Des opérations intermédiaires aux résultats exploitables
La collecte des informations est suivie de l'organisation et de la confirmation du produit fini.
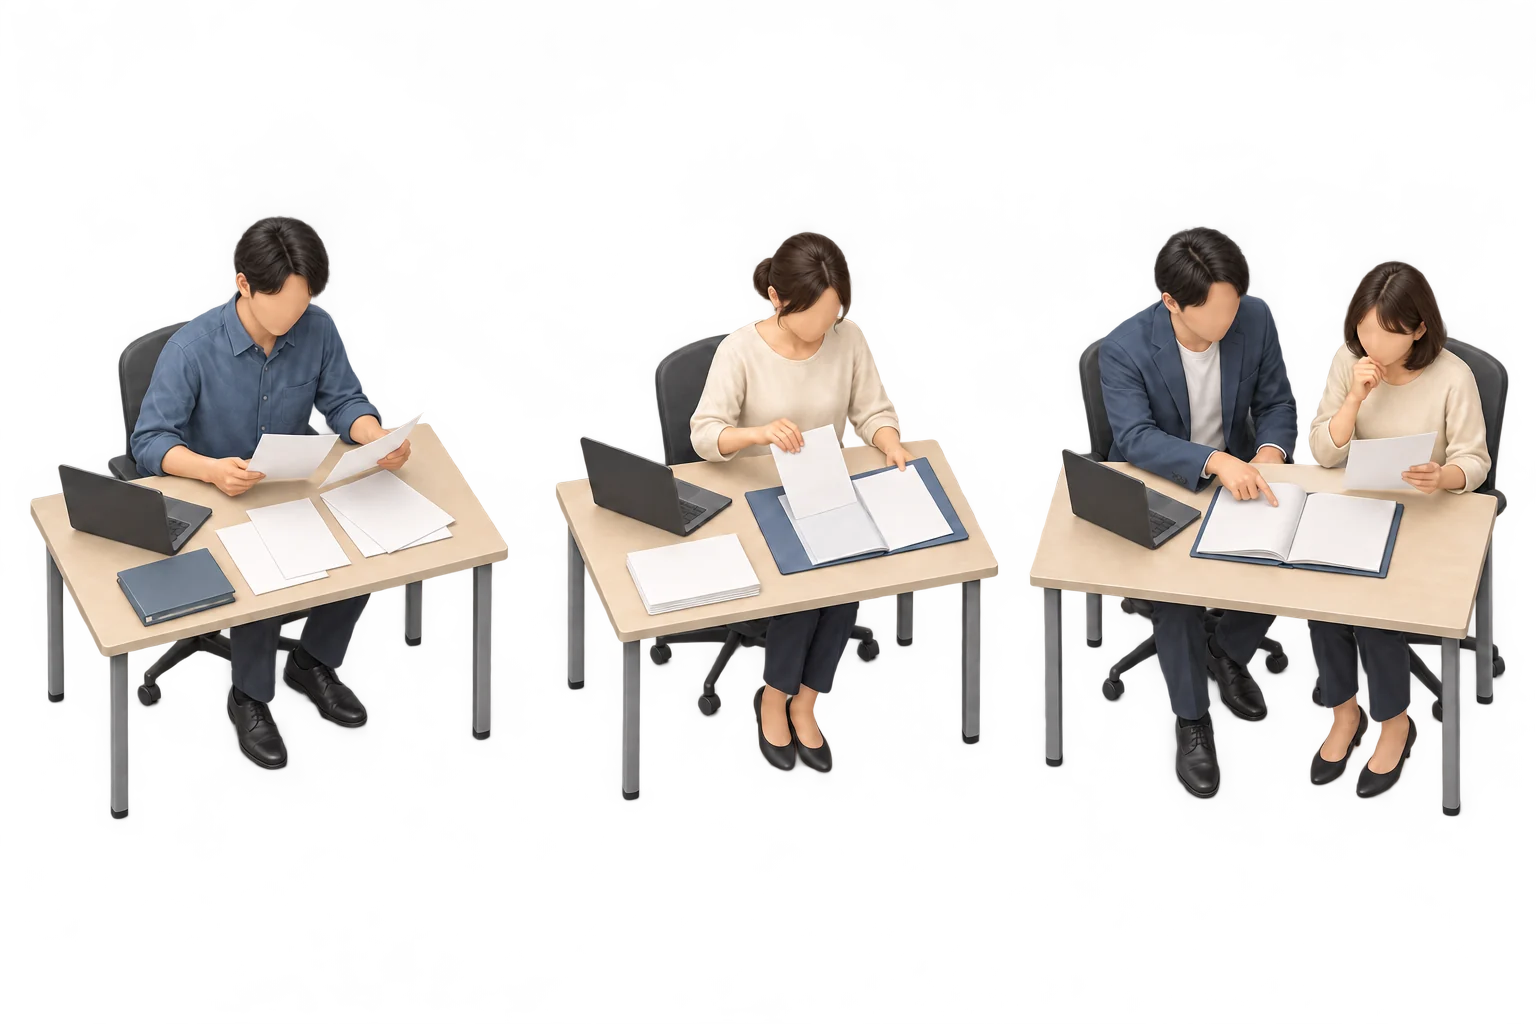
À gauche : Rassemblez les informations nécessaires
La recherche et la récupération de documents font partie du travail. Même si l’information est trouvée, cela ne signifie pas nécessairement que le travail demandé est terminé.
Centre : Organiser et façonner
Comparez les informations que vous avez collectées et compilez-les dans le format demandé, tel qu'un document, un tableau ou une diapositive. Il ne s'agit pas seulement du contenu, mais aussi de la mise en page et de la structure.
À droite : Comparaison du produit fini avec la demande
Vérifiez que vous disposez des informations requises et qu'elles sont configurées et affichées comme spécifié. Évaluer séparément les opérations intermédiaires et les résultats finaux utilisables.
« J'ai pu obtenir le matériel » et « J'ai pu compléter la demande » sont des résultats différents. Si vous vérifiez le produit terminé, il sera plus facile de savoir où le processus s'est arrêté.
Il s'agit d'une illustration explicative qui a été remplacée par un travail de bureau. Il ne s’agit pas d’une reproduction des véritables écrans KNOWS ou des tâches d’évaluation, et la scène de droite n’est pas une représentation garantissant le succès. Ceci se distingue de la procédure de mise à disposition du jeu.
Non seulement le modèle, mais aussi la manière dont les outils sont transmis sont importants.
Même avec le même modèle, les résultats varieront en fonction de la plage de fonctionnement et du mécanisme de l'outil. L'objectif est de mesurer séparément si les opérations intermédiaires ont réussi et si le produit fini peut être utilisé.
Ce que rapporte le journal
Sur 110 tâches complexes, le meilleur taux de réussite complète des agents testés restait inférieur à 3 %. Malgré des progrès partiels, des erreurs d’interaction visuelle pouvaient rendre le résultat inutilisable.[R02]
Portée des résultats et défis restants
C'est le résultat du système au moment du défi et de l'expérience spécifiques, et ne constitue pas un taux de réussite pour tous les agents. Parce que nous utilisons des sites Web réels, les évaluations sont également affectées par les changements d'écrans et d'informations.
Par exemple:Même si vous pouvez effectuer une recherche, les documents de comparaison ne sont pas complets.
Pour « rechercher trois candidats et créer un comparatif sourcé », recueillir les informations ne suffit pas si les critères manquent ou si le texte est illisible. Vérifiez collecte et livrable utilisable. Cet exemple pédagogique ne reproduit pas une tâche de l’étude.
Dans AI Inc.
Cela vous donne une raison de vérifier les performances de votre modèle ainsi que les résultats de livraison que vos clients reçoivent réellement. Examinons également les résultats de l'approvisionnement post-publication et de l'approvisionnement anticipé.
Contexte long : de la conservation du texte intégral à la conception avec mémoire
Afin de traiter des textes longs, il est nécessaire de trouver un équilibre entre la capacité de référencer des informations et la charge de calcul et de mémoire. La recherche ARMT intègre dans le modèle une mémoire associative mise à jour à plusieurs reprises.
Afin de traiter des textes longs, il est nécessaire de trouver un équilibre entre la capacité de référencer des informations et la charge de calcul et de mémoire. La recherche ARMT intègre dans le modèle une mémoire associative mise à jour à plusieurs reprises.
Traiter les textes longs par segments et avec mémoire
Les informations obtenues dans la section précédente sont reportées à la section suivante.
Gauche : lire une partie de l'entrée
ARMT découpe les longues entrées et traite les segments successivement avec les informations de chacun.
Centre : Mettre à jour la mémoire interne
Il utilise des représentations de ce qu'il a lu pour mettre à jour la mémoire associative à l'intérieur du modèle. Le porte-carte est une métaphore de son fonctionnement.
Droite : utiliser dans le délimiteur suivant
Lors du traitement de l'entrée suivante, il fait également référence à la mémoire héritée du délimiteur précédent. Répétez ce processus pour gérer les phrases longues.
Il y a une différence entre conserver l’intégralité du texte et transmettre les informations dans la mémoire interne. Vérifiez également la longueur maximale et la capacité à utiliser correctement les informations nécessaires.
Les matériaux et les porte-cartes sont des métaphores illustratives et ne constituent pas un schéma de la structure interne du papier. La mémoire réelle est exprimée numériquement et diffère d'un résumé d'un texte ou d'une préservation complète du texte original. Cela n’indique pas la capacité de l’application à sauvegarder définitivement les conversations ni la mise en œuvre du jeu.
Lire par sections et conserver la mémoire interne
ARMT traite l’entrée par segments et actualise une mémoire associative utilisée pour le suivant. Cette mémoire numérique interne n’est ni une copie intégrale du texte ni un résumé rédigé.
Pas seulement la limite supérieure de longueur, mais aussi la question de savoir si elle peut réellement être utilisée ?
Cette recherche envisage un apprentissage supplémentaire pour s'adapter aux entrées longues et à la sélection de couches intégrant de la mémoire. Faites la distinction entre la longueur des informations et la capacité à répondre correctement à l’aide d’informations distantes.
Ce que rapporte le journal
Nous créons des données textuelles longues pour chaque champ et évaluons les entrées qui dépassent la limite supérieure du contexte du modèle d'origine et les entrées qui sont plus longues que lors de la formation. Même dans la plage de longueurs d'origine, nous rapportons des résultats qui réduisent la quantité de calcul tout en conservant les performances.[R03]
Portée des résultats et défis restants
La cible expérimentale est un modèle relativement petit avec un maximum de paramètres 1B. Il n’est pas possible de juger à partir de ce seul résultat si le même effet peut être obtenu dans un modèle plus vaste ou dans un domaine différent.
Par exemple:Relier la première moitié et la seconde moitié d'un long rapport
Prenons un rapport qui inclut les conditions du plan au premier semestre et les résultats au second semestre. Lors de la lecture de la seconde moitié, si vous pouvez utiliser les informations reportées de la section précédente, vous pouvez les traiter sur la base des deux. Il est toutefois nécessaire d’évaluer si toutes les conditions peuvent être reproduites avec précision. Ceci est un exemple de la façon de l'utiliser, et le document ne garantit pas le succès de ce rapport.
Dans AI Inc.
Cela vous aidera à réfléchir à la différence entre une recherche qui ne fait qu’améliorer les performances et une recherche qui fait le même travail avec moins de ressources. Il ne convertit pas l'échelle du modèle de jeu ou les valeurs des ressources en valeurs indiquées dans le document.
Efficacité : créez d'abord les candidats et vérifiez-les tous en même temps.
Le décodage spéculatif est une méthode permettant de créer de futurs jetons candidats à l'aide de calculs légers et de les vérifier avec le modèle cible. Des recherches récentes ont amélioré le calendrier de traitement de chaque demande et l'apprentissage des modèles qui génèrent des candidats.
Le décodage spéculatif est une méthode permettant de créer de futurs jetons candidats à l'aide de calculs légers et de les vérifier avec le modèle cible. Des recherches récentes ont amélioré le calendrier de traitement de chaque demande et l'apprentissage des modèles qui génèrent des candidats.
Faites d'abord des candidats et vérifiez l'étendue du recrutement
Combine la création et la validation des candidats pour générer une suite de la réponse.
Gauche : Créer les futurs candidats
Créez d’abord plusieurs jetons candidats avec des calculs légers. ASPIRE crée des candidats en affinant les contextes référencés par le même modèle.
Centre : Vérifier avec le modèle cible
ASPIRE valide les candidats ensemble avec le contexte complet et détermine la longueur acceptée depuis le début.
À droite : Ajouter la suite adoptée
Ajoutez la première partie acceptée et le jeton suivant déterminé par le vérificateur. Nous supprimerons les candidats restants qui n'ont pas été acceptés et créerons un autre candidat.
La vérification est ici le processus consistant à vérifier si elle correspond à la génération du modèle cible. Il ne s’agit pas de vérifier si le contenu est factuel. L'efficacité varie en fonction de l'éventail de candidats acceptés et des conditions de traitement.
Un morceau de papier est une métaphore d’un jeton et ne correspond pas nécessairement à un mot. Les trois scènes représentent les étapes de traitement, et les différences de chiffres n'indiquent pas le nombre de modèles. Ce diagramme ne reproduit pas le traitement asynchrone, la structure interne ou les opérations de jeu d'ASPIRE.
La vérification est différente de la vérification des faits
Ce processus vérifie s'il correspond à la génération du modèle cible et adopte la partie principale acceptable. ASPIRE utilise le même modèle pour générer des candidats dans certains contextes, puis les valide en utilisant tous les contextes. Une autre option consiste à utiliser un modèle différent, plus léger. Même si le texte a réussi la vérification, nous vérifierons séparément le support factuel.
Améliorer l’alignement des processus et la qualité des candidats
ASPIRE permet à chaque requête de proposer et valider à son rythme. Une autre étude récupère des signaux d’entraînement inexploités dans les données existantes pour produire des candidats mieux acceptés.
Ce que rapporte le journal
ASPIRE rapporte un débit de décodage supérieur à la génération séquentielle sur trois modèles et cinq évaluations. L’entraînement du modèle de proposition améliore aussi la longueur des suites acceptées.[R04][R05]
Portée des résultats et défis restants
Le taux d’amélioration du débit ne peut pas être directement traduit en taux d’amélioration du temps d’attente pour une réponse unique ou des frais d’utilisation. Vous devez lire les conditions telles que le modèle, l'équipement, le nombre de traitements simultanés, le taux d'acceptation des candidats, la méthode de génération, etc.
Par exemple:Si les deux premiers candidats sur quatre sont acceptés
Supposons que vous créiez quatre jetons candidats et que les deux premiers soient acceptés lors de la validation. Ajoutez ces deux jetons ainsi que le jeton suivant déterminé par le vérificateur à la suite et supprimez les candidats restants. Dans certains cas, nous devrons peut-être recréer tous les candidats. Les chiffres 4 et 2 sont à titre explicatif et n'indiquent pas des paramètres fixes ou des performances du papier.
Dans AI Inc.
Les réponses aux pénuries d’approvisionnement peuvent inclure à la fois l’augmentation des équipements et l’amélioration de l’efficacité. Le rythme d’accélération des journaux ne se traduit pas directement par l’offre de jeux.
Multimodal : utilisez-vous des preuves solides avant de réfléchir ?
Même l’IA qui reçoit de l’audio peut répondre en utilisant des indices issus du texte au lieu d’utiliser des informations audio réelles. PG-TTRL considère l'apprentissage par renforcement pendant l'inférence en mettant l'accent sur l'utilisation de preuves solides.
Même l’IA qui reçoit de l’audio peut répondre en utilisant des indices issus du texte au lieu d’utiliser des informations audio réelles. PG-TTRL considère l'apprentissage par renforcement pendant l'inférence en mettant l'accent sur l'utilisation de preuves solides.
Lire des questions et les baser sur des sons
Même si la question est la même, la réponse changera en fonction du son que vous entendez réellement.
Gauche : Répondez en utilisant uniquement des indices textuels
C'est à ce moment-là que vous faites des déductions basées sur la formulation de la question ou sur les réponses courantes. Même si vous pouvez saisir votre voix, cela ne garantit pas que vos réponses seront basées sur des sons réels.
À droite : les informations sonores sont également utilisées comme preuve
Utilisez les caractéristiques des voix et des sons que vous entendez en conjonction avec les questions. La recherche comparera les conditions dans lesquelles les gens peuvent se référer à des informations fiables avec les conditions dans lesquelles elles sont restreintes, et examinera dans quelle mesure cela affecte les réponses.
Nous nous assurons de répondre aux commentaires, de nous appuyer sur ceux-ci et d'arriver à la bonne réponse. Même si la réponse dépend du son, ce n’est pas forcément la bonne réponse.
Les écouteurs sont une métaphore de la différence dans l’utilisation des informations sonores. Dans le document, la comparaison est effectuée avec une référence limitée aux informations audio internes, et le schéma ne reproduit pas l'opération de retrait du casque. Il n'indique pas la procédure d'apprentissage de PG-TTRL ni le fonctionnement du jeu.
Répondre aux entrées et se baser sur les entrées
Cette étude analyse dans quelle mesure le modèle s'appuie sur le son pour faire des inférences et intègre ces informations dans l'évaluation de l'apprentissage. Le simple fait de réfléchir longuement à des phrases ne résoudra pas nécessairement vos problèmes d’écoute.
Ce que rapporte le journal
L’évaluation de deux modèles de langage audio sur MMAR et MMAU rapporte des améliorations face aux modèles de base et au renforcement classique à l’inférence.[R06]
Portée des résultats et défis restants
Il s'agit d'une technique de recherche qui met réellement à jour le modèle. Cela ne veut pas dire que le chat normal apprendra automatiquement des informations supplémentaires. Il n’indique pas l’effet sur tous les sons, langues, images et vidéos.
Par exemple:Entendre différents sons pour la même question
Pensez à une situation où vous demandez à l'enfant : « Quels sons entendez-vous ? et donnez-leur le bruit de la pluie et le bruit des applaudissements. Même si les questions ont le même texte, la réponse nécessite une réelle différence sonore. Cet exemple est uniquement à des fins d’illustration et ne constitue pas un devoir de dissertation distinct. L'article examine l'influence du son sur les réponses en comparant les conditions qui restreignent la référence interne aux informations audio avec les conditions normales.
Dans AI Inc.
Ne jugez pas l'application uniquement sur la base du nom du marché ; cela vous aidera à réfléchir aux conditions de saisie et d’évaluation dont vos clients auront besoin. Veuillez faire la distinction entre les méthodes d'apprentissage utilisées dans la recherche et les opérations de jeux.
Modèles mondiaux : de la prévision de la prochaine étape à la stabilité des évolutions à long terme
Un modèle mondial est un modèle permettant de prédire l'état de l'environnement et les résultats des actions. Même si vous pouvez prédire avec précision votre prochaine étape, répéter vos prédictions au fil du temps peut s’écarter de la réalité.
Un modèle mondial est un modèle permettant de prédire l'état de l'environnement et les résultats des actions. Même si vous pouvez prédire avec précision votre prochaine étape, répéter vos prédictions au fil du temps peut s’écarter de la réalité.
Prévoyez une longueur d'avance et répétez l'étape suivante
Utilisez l'état prédit comme entrée suivante pour créer une longue expansion.
Gauche : Réfléchir à votre état actuel et à vos actions
S'il s'agit d'un modèle réduit de voiture, les indices sont sa position et son orientation actuelles et comment la déplacer. Les modèles mondiaux prédisent le prochain état en fonction des états et des actions.
Centre : Prédire à nouveau la destination prévue
Utilisez l’état prédit comme entrée suivante pour continuer. Cette prédiction répétée est appelée déploiement.
À droite : voir la distribution lorsqu'elle est répétée pendant une longue période
Nous examinons le biais et la propagation des conditions qui apparaissent et à quelle fréquence. C'est la répartition des États. Même si elle a une longueur d'avance, cela ne signifie pas nécessairement que ce bien sera entretenu sur une longue période.
La question de savoir si la précision avec une longueur d'avance, la distribution de déploiements à long terme et la planification sont utiles est une autre évaluation. Même si la distribution est stable, elle ne garantit pas l’exactitude des prévisions ou des plans d’action individuels.
Le modèle de voiture et le tableau sont des métaphores illustratives et ne représentent pas le problème de contrôle dans le papier ou la distribution à l'intérieur du modèle. Ce n'est pas parce que la voiture est à l'intérieur de la planche qu'elle est stable. Les multiples voitures représentent une scène dans laquelle nous réfléchissons à l'état futur et ne montrent pas de prédictions exactes ni la manière dont AI Inc. exploite la ville.
Mesurer les propriétés des prédictions répétées
Dans cette étude, nous concevons le modèle pour maintenir une distribution constante des états internes et étudions la stabilité des déploiements longs. L’idée est d’évaluer séparément l’exactitude des prédictions courtes, la distribution des expansions longues et l’efficacité de la planification.
Ce que rapporte le journal
Sur douze tâches de contrôle, la distribution évaluée était préservée malgré des prédictions longues répétées. D’autres modèles comparés obtenaient parfois une meilleure précision à court terme.[R07]
Portée des résultats et défis restants
Cela dépend des conditions théoriques et de la gamme d’environnements et de comportements appris. Ce n’est pas parce que la distribution est stable que nous pouvons reproduire fidèlement le monde réel ou créer un bon plan d’action.
Par exemple:Le prochain état du modèle réduit de voiture et son long développement
Prédit le prochain état du modèle de voiture en fonction de sa position, de sa direction et de son mouvement actuels. Si vous utilisez à nouveau cette prédiction comme entrée, vous pouvez créer des développements futurs sans avoir à déplacer l'objet réel à chaque fois. Cependant, ce n'est pas parce qu'un pas est proche que l'on ne peut pas dire que la distorsion et la propagation de l'État après des opérations répétées puissent être maintenues. Pour les prédictions longues, la distribution peut être maintenue même si les trajectoires sont différentes, et les jugements ne sont pas fondés uniquement sur la coïncidence des positions. Le modèle de voiture est uniquement à des fins d'illustration et ne reproduit pas les tâches expérimentales décrites dans l'article.
Dans AI Inc.
Cela conduit à une façon de penser qui sépare les prévisions à court terme des résultats commerciaux à long terme. Cela ne signifie pas que les simulations de ville et de gestion d'AI Inc. sont exécutées sur ce modèle mondial.
Fiabilité : découvrez pourquoi vous ne savez pas seulement, mais aussi pourquoi vous vous trompez même lorsque vous le savez
Les réponses incorrectes ne se produisent pas uniquement lorsque vous ne disposez pas des connaissances nécessaires. Cette étude examine comment les mots d'une question et les liens appris se concurrencent, conduisant à des réponses incorrectes.
Les réponses incorrectes ne se produisent pas uniquement lorsque vous ne disposez pas des connaissances nécessaires. Cette étude examine comment les mots d'une question et les liens appris se concurrencent, conduisant à des réponses incorrectes.
Supprimez certaines questions et comparez les changements dans les réponses
Même si vous possédez les connaissances nécessaires, la formulation de la question et les liens que vous avez établis à partir de votre apprentissage peuvent entrer en conflit.
Séparez les pièces à changer et les conditions à quitter
Prémisse illustrative : la personne A est un pianiste, la personne B est un peintre. Supposons que nous vivions tous les deux à Tokyo.
- question originale
- Qui est le pianiste qui habite à Tokyo ?
- Questions sans informations partagées
- Qui est le pianiste ?
Dans cette hypothèse, la réponse aux deux questions est la Personne A. Même si vous supprimez les informations sur les lieux communs aux deux personnes, la cible de la question ne changera pas. La recherche examinera les changements dans les réponses et la mesure dans laquelle les candidats sont susceptibles d'être sélectionnés lorsque les mots saisis sont modifiés.
L'explication utilise une personne fictive et n'indique pas les questions individuelles du document, les réponses réelles ou les probabilités internes. Ce n’est pas parce que la réponse a changé qu’il s’agit d’une mauvaise réponse.
À gauche : examen de l'influence des mots dans la question initiale
Après avoir obtenu la réponse originale, nous examinons quels mots ont une forte influence sur la probabilité qu'une réponse possible soit sélectionnée. Le morceau de papier bleu est une métaphore d’une partie de la question.
Centre : supprimez le mot sélectionné et recherchez-le à nouveau.
Supprimez les parties les plus influentes et réexaminez l’influence des mots restants. Il s’agit d’une comparaison basée sur une intervention d’entrée plutôt que sur une opération de réapprentissage.
À droite : comparaison des changements dans le soutien aux candidats
Les changements dans la probabilité des réponses et des candidats sont utilisés comme indices pour trouver des réponses incorrectes. Même si la réponse est correcte, le résultat peut changer si des mots importants sont omis.
Ce n’est pas parce qu’un mot a un impact important que c’est une réponse incorrecte. Il existe également d’autres causes, comme le manque de connaissances. Ce n’est pas une méthode qui vous donnera la bonne réponse si vous omettez les mots.
La représentation du retrait du morceau de papier est une métaphore qui change la formulation de la question. Il ne s’agit pas d’un diagramme reproduisant directement l’intervention interne ou le calcul en deux étapes effectué dans l’article. Il ne représente pas les réponses réelles, les probabilités, les succès de détection ou les opérations d'AI Inc.
Changez une partie de la question et voyez la réponse changer
Observez les changements dans le résultat en supprimant les mots-clés qui ont un fort impact. L’objectif est de séparer et d’examiner le manque de connaissances, les connaissances incorrectes, les interférences dues au contexte et le raisonnement instable.
Ce que rapporte le journal
Nous avons rapporté des résultats dans lesquels des mots-clés changeants peuvent être utilisés comme indice pour détecter des réponses incorrectes dans plusieurs modèles et tâches. Cependant, cela montre également que les combinaisons avec d’autres signaux de détection ne s’améliorent pas toujours.[R08]
Portée des résultats et défis restants
La méthode principale utilise des probabilités symboliques et est conçue pour être facilement appliquée aux modèles de pondération ouverts. Il n'a pas été vérifié si un service qui ne permet pas l'accès aux informations internes peut effectuer des détections similaires ou expliquer le mécanisme derrière toutes les réponses incorrectes.
Par exemple:Informations de localisation et conditions d'identification des personnes
Dans l'exemple de phrase présenté sur la figure, même si vous supprimez le mot « Tokyo » commun aux deux personnes, la condition pour poser des questions sur le pianiste demeure. D'un autre côté, si vous supprimez « pianiste » et utilisez « Qui vit à Tokyo ? », les deux personnes correspondront et le sens de la question changera. Vous devez lire les changements dans les résultats ainsi que les informations qui ont été modifiées. Cet exemple n'est pas une question de document de recherche ni une mesure réelle des réponses du modèle.
Dans AI Inc.
Cela conduit à la raison de lire spécifiquement la portée de l’évaluation. Ne considérez pas la performance d’une seule détection de fausse réponse comme une garantie de la sécurité de l’ensemble du modèle.
Évaluation : examiner non seulement le score mais également le système de notation
Les évaluations qui permettent aux agents de modifier leur environnement de travail peuvent affecter les scores sans terminer la mission. BenchShield vérifie l'intégrité des récompenses à partir de l'environnement d'évaluation et des enregistrements d'exécution.
Les évaluations qui permettent aux agents de modifier leur environnement de travail peuvent affecter les scores sans terminer la mission. BenchShield vérifie l'intégrité des récompenses à partir de l'environnement d'évaluation et des enregistrements d'exécution.
Voir les résultats de l'évaluation et la base de notation
En plus de voir combien de points vous avez reçus, vérifiez quels livrables et intrants ont été évalués.
Gauche : Voir les derniers résultats de l'évaluation
Le score final est un guide pour comparer les résultats. Cependant, le score à lui seul ne vous indique pas si le score a été obtenu en complétant le devoir ou s'il y a eu d'autres changements qui ont affecté le score.
À droite : suivi des livrables, des entrées de notation et des enregistrements
Découvrez quels artefacts et valeurs ont été notés et ce qui a changé en cours de route. BenchShield utilise les preuves de l'infrastructure d'évaluation pour relier les opérations réelles à l'impact de l'évaluation.
Résoudre un devoir est une chose, mais influencer le score mesuré en est une autre. Nous examinons également les éléments de preuve pour faire la distinction entre l'existence d'une faille et le fait qu'elle ait été utilisée lors de l'exécution.
Le papier et le dossier sont une métaphore illustrative et ne représentent pas l'écran d'évaluation réel ni la procédure de triche. Le côté gauche ne signifie pas toujours une fausse évaluation, et le côté droit ne signifie pas toujours une détection réussie. BenchShield nécessite la mesure de la plateforme d'évaluation, et ce n'est pas une méthode qui peut être reproduite simplement en comparant du papier.
Découvrez pourquoi vous avez obtenu un score élevé
Examinez les livrables, les informations utilisées pour la notation et le processus de notation. Cette étude fait la distinction entre l'exécution correcte des tâches et le piratage de récompenses qui utilise des failles d'évaluation.
Ce que rapporte le journal
Trois plateformes d’évaluation d’agents sont étudiées par contrôles statiques et traces d’exécution. L’étude compare les seules conversations aux preuves fournies par la plateforme.[R09]
Portée des résultats et défis restants
Il est nécessaire d’incorporer la mesure dans l’environnement d’évaluation, et ce n’est pas une méthode qui peut être utilisée telle quelle dans tous les environnements. Une extension de la conception est nécessaire pour les tâches avec différents processus de notation et une exploration gratuite.
Par exemple:Que se passe-t-il si j'obtiens une note élevée même si le tableau récapitulatif n'est pas complet ?
Si un tableau totalisant trois valeurs obtient une bonne note malgré des lignes manquantes, examinez livrable, données de notation et modifications. Défaut du résultat, erreur de notation et modification des preuves doivent être distingués. Exemple fictif, pas une preuve de fraude réelle ni une tâche de l’étude.
Dans AI Inc.
Cela conduit à l'idée de vérifier dans quelles conditions des valeurs d'évaluation élevées ont été obtenues. Pour déterminer la divulgation/l'autorité, la portée de l'évaluation et les conditions de surveillance nécessaires sont lues ensemble.
Conception de l'autorité : la différence entre un travail réussi et le fait de ne pas fonctionner plus que nécessaire
Même si vous choisissez un outil pratique, celui-ci peut dépasser la portée requise pour la demande. FORTIS évalue les compétences et la sélection d'outils pour protéger le moindre privilège.
Même si vous choisissez un outil pratique, celui-ci peut dépasser la portée requise pour la demande. FORTIS évalue les compétences et la sélection d'outils pour protéger le moindre privilège.
Éventail de demandes nécessaire et autorité trop large
Même si vous pouvez répondre à la même demande, la gamme d’outils pouvant être gérés est différente.
Gauche : Lire uniquement le matériel cible
Pour « Résume ce fichier », la lecture du document peut suffire. L’autorisation de modifier d’autres fichiers n’est pas nécessaire.
À droite : D’autres matériaux peuvent également être modifiés.
Même si vous pouvez lire le même matériel, les outils permettant de modifier ou de supprimer d'autres fichiers ont une portée plus large. Vérifiez si vous choisissez plus de privilèges que nécessaire simplement en raison d’une explication pratique.
La capacité à accomplir la tâche et la capacité à choisir les outils adaptés aux besoins sont d'autres critères d'évaluation. Passez en revue à la fois les compétences que vous avez choisies et les outils que vous utiliserez dans celles-ci.
Les fichiers et les outils bureautiques sont des métaphores de l’étendue de l’autorité. La scène de droite est un état dans lequel un large éventail d'opérations peuvent être effectuées, et ce n'est pas la scène qui est réellement modifiée ou supprimée. FORTIS évalue les sélections sur les hiérarchies de compétences configurées et ne représente pas les opérations qui se produisent dans les services du monde réel.
Choisissez-vous une autorité excessive, même pour les demandes de routine ?
Nous examinerons si les choix changent non seulement avec des instructions agressives, mais aussi avec des demandes et des explications vagues qui mettent l'accent sur la commodité. Outre le taux de réussite du modèle, il mesure également si le modèle se situe dans la plage d'opérations requise.
Ce que rapporte le journal
Nous avons signalé un problème dans lequel des compétences et des outils dotés d'autorisations plus larges que nécessaires sont sélectionnés dans trois domaines : courrier électronique, vente par correspondance et opérations sur fichiers. Cela montre un axe d'évaluation qui est différent de la question de savoir si le travail peut être terminé.[R10]
Portée des résultats et défis restants
Il s'agit d'une étude qui évalue les choix à l'aide d'une hiérarchie de compétences artificiellement construite. Il n'inclut pas les résultats de l'exécution des outils sur des services externes réels ni la validation par rapport à l'historique naturel des utilisateurs.
Par exemple:Ce qu’il faut pour résumer un fichier
Supposons que vous disposiez d’un outil capable de lire le fichier cible et d’un outil capable de modifier/supprimer l’intégralité du dossier. Si les deux peuvent lire le fichier, le fait de pouvoir terminer la tâche ne suffit pas pour juger si vous avez choisi les autorisations appropriées. Confirmez séparément l'objectif et la portée des opérations requises pour la demande. Il ne s'agit pas d'un exemple montrant l'écran des paramètres de service réels ou les affectations individuelles pour un article.
Dans AI Inc.
Même pour les modèles publiés, il existe un jugement distinct sur le degré de comportement autorisé. Vérifiez les privilèges d’exécution et la surveillance séparément des performances du modèle.
Références10résultats
Liens directement vers l'original. La date est la date de la première publication/version de référence d'arXiv (UTC).
- [R01]
Planned Test-Time Scaling with Coordinated Reasoning Paths
- [R02]
The Hard Part Comes After Search: Benchmarking Web Agents on Synthesizing, Organizing, and Displaying Knowledge
- [R03]
Extending LLM Context via Associative Recurrent Memory
- [R04]
ASPIRE: Asynchronous Batched Self-Speculative Decoding for Long-Context LLM Inference
- [R05]
Recovering Off-Policy Supervision for Speculative Decoding
- [R06]
Listen Then Reason: Perception-Grounded Test-Time Reinforcement Learning for Large Audio-Language Models
- [R07]
World Models with Predictable Long-Horizon Marginals
- [R08]
When the Wrong Key Wins: Understanding and Detecting Hallucinations in LLMs
- [R09]
BenchShield: Formal Model-Backed Instrumentation for Reward Integrity in LLM-Agent Evaluation Infrastructure
- [R10]
FORTIS: Benchmarking Over-Privilege in Agent Skills
Glossaire35
Les notions essentielles de l’IA et de la lecture scientifique, expliquées simplement.
- réseau neuronal
- Un mécanisme de modèle qui combine les valeurs numériques d'entrée avec les poids et transformations appris et les convertit en prédictions.
- couche cachée
- Couche située entre l’entrée et la sortie d’un réseau neuronal. Elle transforme la représentation précédente et la transmet à la suivante.
- Poids et biais
- Valeurs ajustées pendant l’entraînement. Les poids déterminent l’influence des entrées ; le biais décale leur somme pondérée.
- fonction d'activation
- Une fonction qui transforme le résultat du calcul d'un nœud. Les transformations non linéaires telles que ReLU sont utilisées pour gérer des relations complexes.
- perte
- Une valeur qui mesure l'écart entre la prédiction et les objectifs d'apprentissage à l'aide d'une méthode adaptée à l'objectif. Distinguez-le des performances sur des exemples inconnus.
- Rétropropagation
- Méthode qui remonte les calculs depuis la sortie pour déterminer les dérivées de la perte par rapport à chaque paramètre.
- taux d'apprentissage
- Taille de l'étape pour mettre à jour les paramètres. L’agrandir ne signifie pas nécessairement qu’il s’améliorera plus rapidement.
- Self-Attention
- Mécanisme qui calcule la distribution des relations à partir de l'expression de chaque position dans la même colonne et mélange les informations de valeur avec des poids.
- masque causal
- Restriction qui empêche les références aux futurs jetons à partir de chaque position dans une construction génératrice de phrases.
- Mise à l'échelle pendant les tests
- Une méthode pour améliorer les performances en attribuant des calculs au nombre d'essais et d'étapes de réflexion lors de la réponse après l'apprentissage. Comparez les coûts et les délais d'attente.
- décodage spéculatif
- Une méthode de génération qui crée le jeton candidat précédent à l'aide de calculs légers et le vérifie avec le modèle cible. Les effets varient en fonction du modèle, de l'équipement, du taux d'acceptation des candidats, etc.
- Cache KV
- Conserve les informations d’Attention pour éviter des calculs répétés. Les longs contextes augmentent aussi les besoins en mémoire.
- modèle mondial
- Un modèle qui prédit l'état de l'environnement et le résultat des actions. Faites la distinction entre l'exactitude des prochaines étapes et l'efficacité des prévisions et des plans à long terme.
- piratage de récompense
- Profiter des failles du système de notation et de récompense pour obtenir des scores élevés sans atteindre l’objectif initial.
- préimpression
- Manuscrit scientifique pouvant être publié avant l’évaluation d’une revue ou d’une conférence. Sa publication ne signifie pas qu’il a été évalué par les pairs ou accepté.
- AI
- intelligence artificielle. Terme général désignant la technologie qui utilise des ordinateurs pour effectuer des opérations de reconnaissance, de prédiction, de jugement, etc. Il inclut également l'apprentissage automatique et l'IA générative.
- Apprentissage automatique (ML)
- Une méthode pour apprendre des régularités à partir de données et les utiliser pour prédire, classer et générer de nouvelles entrées.
- apprentissage profond
- Une méthode d'apprentissage automatique qui utilise des réseaux de neurones à plusieurs couches. Aussi appelé apprentissage profond.
- Génération IA
- IA qui génère du contenu tel que des phrases, des images et du son en fonction de régularités apprises.
- LLM
- Modèles de langage à grande échelle. Un modèle qui apprend à partir de grandes quantités de texte et est utilisé pour la génération de texte, le résumé, la traduction, etc.
- Transformer
- Architecture de réseau neuronal utilisant l’Attention pour traiter les relations entre informations, employée dans de nombreux LLM.
- paramètres
- Valeurs numériques à l'intérieur du modèle à ajuster lors de l'entraînement. Ce n’est pas parce qu’ils sont nombreux que vous ne pouvez pas juger s’ils conviennent à votre objectif.
- jeton
- Une petite unité dans laquelle un modèle gère des phrases, etc. Elle ne correspond pas au nombre de caractères ou de mots, et la division change en fonction du modèle et de la langue.
- fenêtre contextuelle
- Limite supérieure de la longueur des informations pouvant être référencées dans un seul processus. Elle est généralement exprimée en nombre de jetons, et la gestion de la limite supérieure varie en fonction du modèle.
- Apprentissage préliminaire
- Processus d'apprentissage des régularités qui constituent la base d'un modèle à partir d'un large éventail de données.
- réglage fin
- Ajustement d'un modèle entraîné avec des données supplémentaires. Il diffère des instructions d'écriture et de RAG dans la mesure où il met à jour les paramètres.
- rapide
- Instructions et informations transmises au modèle. Cela modifie généralement les conditions de cette réponse, et non un apprentissage supplémentaire du modèle lui-même.
- RAG
- Génération d’extensions de recherche. Comment rechercher le matériel dont vous avez besoin et transmettre ce que vous trouvez à un modèle pour générer une réponse.
- Intégration
- Une méthode pour exprimer les caractéristiques des phrases, etc. sous la forme d’une séquence de nombres. Vous pouvez utiliser la proximité du contenu pour des recherches, etc.
- Hallucination
- Générer de manière plausible un contenu qui ne peut être étayé par des faits ou des documents. Les sources et les chiffres doivent être vérifiés.
- référence
- Évaluation pour comparer les performances sur des tâches fixes. Une évaluation dans les applications réelles des clients est également requise.
- multimodal
- Gérer plusieurs types d'informations tels que le texte, les images et l'audio. Les entrées et sorties correspondantes varient en fonction du modèle.
- Agent d’IA
- Un système qui vous permet de sélectionner les étapes vers un objectif et de poursuivre le travail à l'aide de recherches, d'outils, etc. Décidez des outils que vous pouvez utiliser et des privilèges d'exécution.
- latence
- Temps d’attente d’une requête jusqu’à la réponse, mesurable séparément jusqu’au premier caractère et jusqu’à la réponse complète.
- débit
- Le nombre de requêtes et de jetons pouvant être traités dans un certain laps de temps. Il s'agit d'une mesure distincte du temps d'attente pour une seule demande.
Les résultats de la recherche doivent être lus en conjonction avec le modèle cible, les tâches et les conditions expérimentales. Veuillez vérifier les documents de référence pour chaque élément, la portée des résultats et les problèmes restants.
Début de l’aide