Aprenda sobre IA
Dos fundamentos de IA e LLM à pesquisa atual.
Categorias: 3 · Artigos: 30 · Termos: 35
Pesquise em “Aprenda sobre IA”. Separe as palavras com espaços para encontrar itens que contenham todas elas.
Comece pelo que te interessar
Todo o conteúdo de aprendizado
Artigos: 30 · Termos: 35
Fundamentos de IA e LLM14
Mesmo se você for novo na IA, poderá compreender o significado da pesquisa, do aprendizado e do fornecimento. Aprenda os fundamentos da IA do mundo real com exemplos familiares.
Esta categoria é o conhecimento básico da IA do mundo real. Desempenho, custo e número de dias de jogo são expressões para o gerenciamento do jogo. As operações relacionadas podem ser encontradas em "Leia também" para cada item.
Aprender com ilustrações
Qual a diferença entre IA, aprendizado de máquina e IA generativa?
IA é um termo amplo para tecnologia que usa computadores para realizar reconhecimento, previsão, julgamento, etc. Aprendizado de máquina refere-se a um método de aprendizagem de regularidades a partir de dados, e IA generativa refere-se à IA que cria frases, imagens, etc.
IA é um termo amplo para tecnologia que usa computadores para realizar reconhecimento, previsão, julgamento, etc. Aprendizado de máquina refere-se a um método de aprendizagem de regularidades a partir de dados, e IA generativa refere-se à IA que cria frases, imagens, etc.
IA, aprendizado de máquina e IA generativa
Mesmo para o mesmo email, as funções de categorização e criação de uma resposta são diferentes.
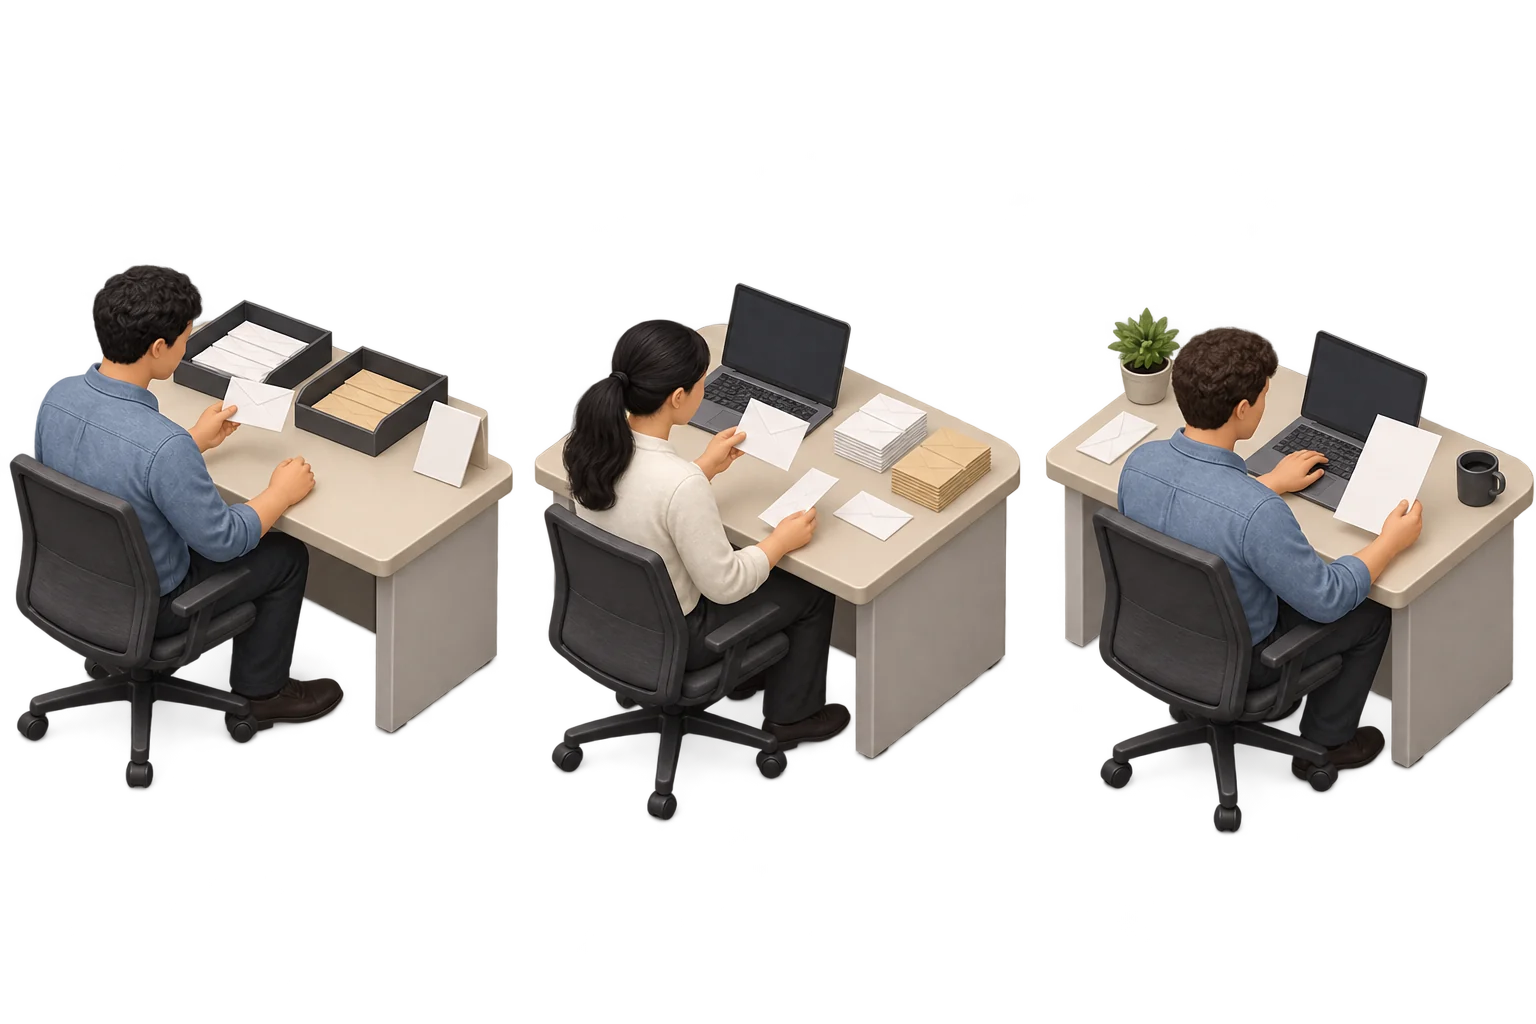
Esquerda: classificar com regras
Classifique os e-mails de acordo com condições pré-determinadas. A IA possui outros mecanismos além de aprender com os dados.
Centro: aprender a classificar com exemplos
Use e-mails classificados e muito mais para aprender regularidades e classificar novos e-mails. Este é um exemplo de aprendizado de máquina.
Direita: criar uma resposta nova
Use as regularidades aprendidas para gerar sentenças que correspondam às instruções. Este é um exemplo de IA generativa.
O aprendizado de máquina e a IA generativa estão incluídos na IA. O aprendizado de máquina é um método de aprendizagem, e IA generativa é o nome da IA que cria conteúdo. IA generativa como LLM é criada usando aprendizado de máquina.
Esta é uma ilustração explicativa que foi substituída por uma mesa e materiais.
O aprendizado profundo é um tipo de aprendizado de máquina
É um método que combina muitas camadas de um mecanismo de cálculo denominado rede neural. É a base para LLM, etc. Nem toda IA é feita com aprendizado profundo.
Você pode ler a tabela movendo-a para a esquerda e para a direita.
| Palavras | Significado | Exemplo |
|---|---|---|
| AI | Toda a arte de fazer trabalho intelectual. Inclui também mecanismos que funcionam de acordo com regras estabelecidas. | Adversários de jogos e reconhecimento de imagens |
| Aprendizado de máquina (ML) | Aprenda as regularidades de previsão e classificação usando dados de exemplo. | Classificação de e-mail de spam, previsão de vendas |
| IA generativa | Gere novos conteúdos usando regularidades aprendidas. | Rascunhe texto, gere imagens e áudio |
Por exemplo:Um mesmo e-mail pode ter funções distintas
“Determinar se é spam” é classificação e “criar um texto de resposta” é geração. As empresas de IA escolhem sua tecnologia com base nas tarefas de que seus clientes precisam.
Em AI Inc.
Ao escolher uma área de estudo, pense não apenas no nome da tecnologia, mas também no tipo de trabalho que você deseja que seu próximo modelo seja capaz de realizar.
O que é um LLM e como ele gera texto?
LLM significa “modelo de linguagem de grande porte”. Aprende padrões da linguagem a partir de grandes quantidades de texto e é usado para gerar, resumir e traduzir, entre outras tarefas.
O que é um LLM e como ele gera texto?
LLM significa “modelo de linguagem de grande porte”. Aprende padrões da linguagem a partir de grandes quantidades de texto e é usado para gerar, resumir e traduzir, entre outras tarefas.
LLM significa “modelo de linguagem de grande porte”. Aprende padrões da linguagem a partir de grandes quantidades de texto e é usado para gerar, resumir e traduzir, entre outras tarefas.
LLM: criar texto calculando sua continuação
Calcula o próximo candidato a partir do contexto e continua.
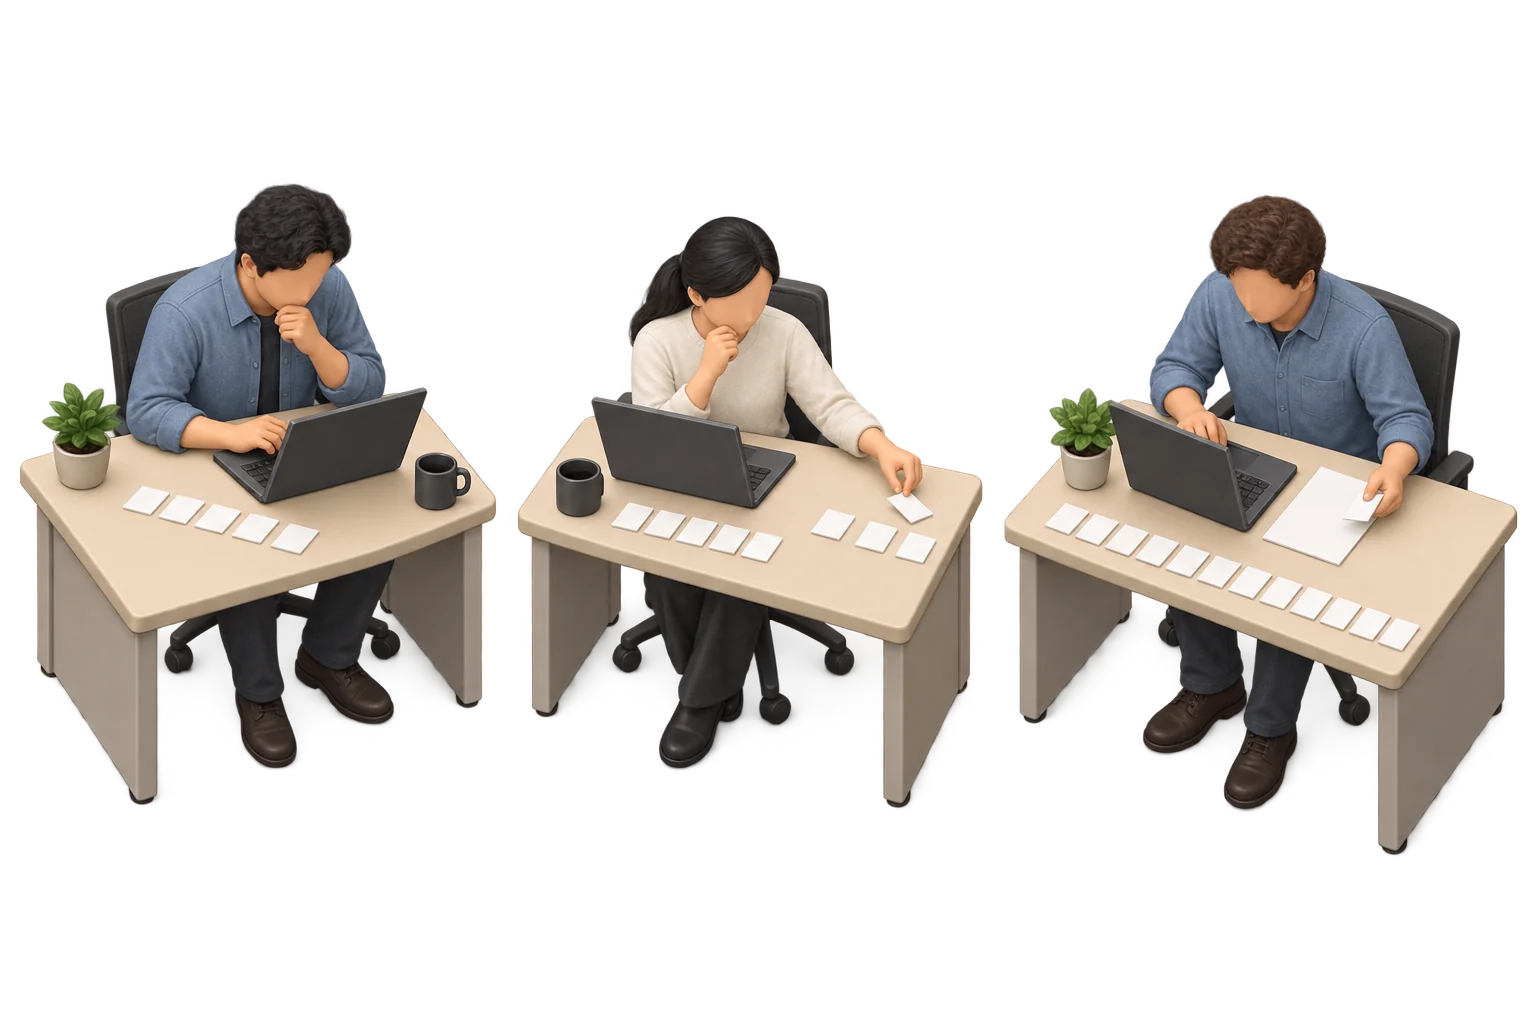
Receber o contexto
Use instruções, perguntas e conteúdo gerado anteriormente.
Calcular a próxima sugestão
Calcule o candidato e a probabilidade do próximo token.
Construir o texto acrescentando continuações
Repita o processo de cálculo do próximo token usando o conteúdo recém-gerado.
Um pedaço de papel é uma metáfora para um token. Tokens são pequenas unidades de texto que não correspondem necessariamente a palavras. Há uma diferença entre a naturalidade do texto e a veracidade dos fatos.
Esta é uma ilustração explicativa que foi substituída por uma mesa e materiais.
Calcular candidatos para a continuação
Ele divide o texto em pequenas unidades de tokens e calcula o próximo candidato a token e a probabilidade com base na entrada e no conteúdo gerado até o momento. Repita este processo para criar uma resposta.
Um modelo e um aplicativo de chat são distintos
O modelo é a parte que calcula a saída a partir da entrada. Os aplicativos de bate-papo usam modelos que combinam histórico de conversas, pesquisas, arquivos, ferramentas e muito mais. Quais recursos estão disponíveis também dependem do aplicativo.
Por exemplo:Continuar “Como está chovendo,”
Há sugestões que combinam com o contexto, como “trazer guarda-chuva” e “adiar a saída”. O LLM calcula essas continuações mesmo em frases mais longas. O processamento real não é necessariamente palavra por palavra.
Cuidados
Mesmo que você consiga escrever frases naturais, isso não significa necessariamente que o conteúdo esteja correto. Você precisa revisar o conhecimento aprendido, os materiais distribuídos e o escopo das informações pesquisadas.
Em AI Inc.
O modelo concluído e o produto API que fornecemos aos nossos clientes são etapas distintas. Depois de criar um modelo, surgirão motivos para ajustar o uso, o preço e o fornecimento.
O que são tokens e janela de contexto?
Um token é uma unidade pequena, como uma frase, que o modelo manipula. A janela de contexto representa o limite superior do comprimento das informações que podem ser visualizadas em um processo.
O que são tokens e janela de contexto?
Um token é uma unidade pequena, como uma frase, que o modelo manipula. A janela de contexto representa o limite superior do comprimento das informações que podem ser visualizadas em um processo.
Um token é uma unidade pequena, como uma frase, que o modelo manipula. A janela de contexto representa o limite superior do comprimento das informações que podem ser visualizadas em um processo.
Contexto: as informações desta vez
Separe os materiais da sua mesa daqueles guardados na prateleira.
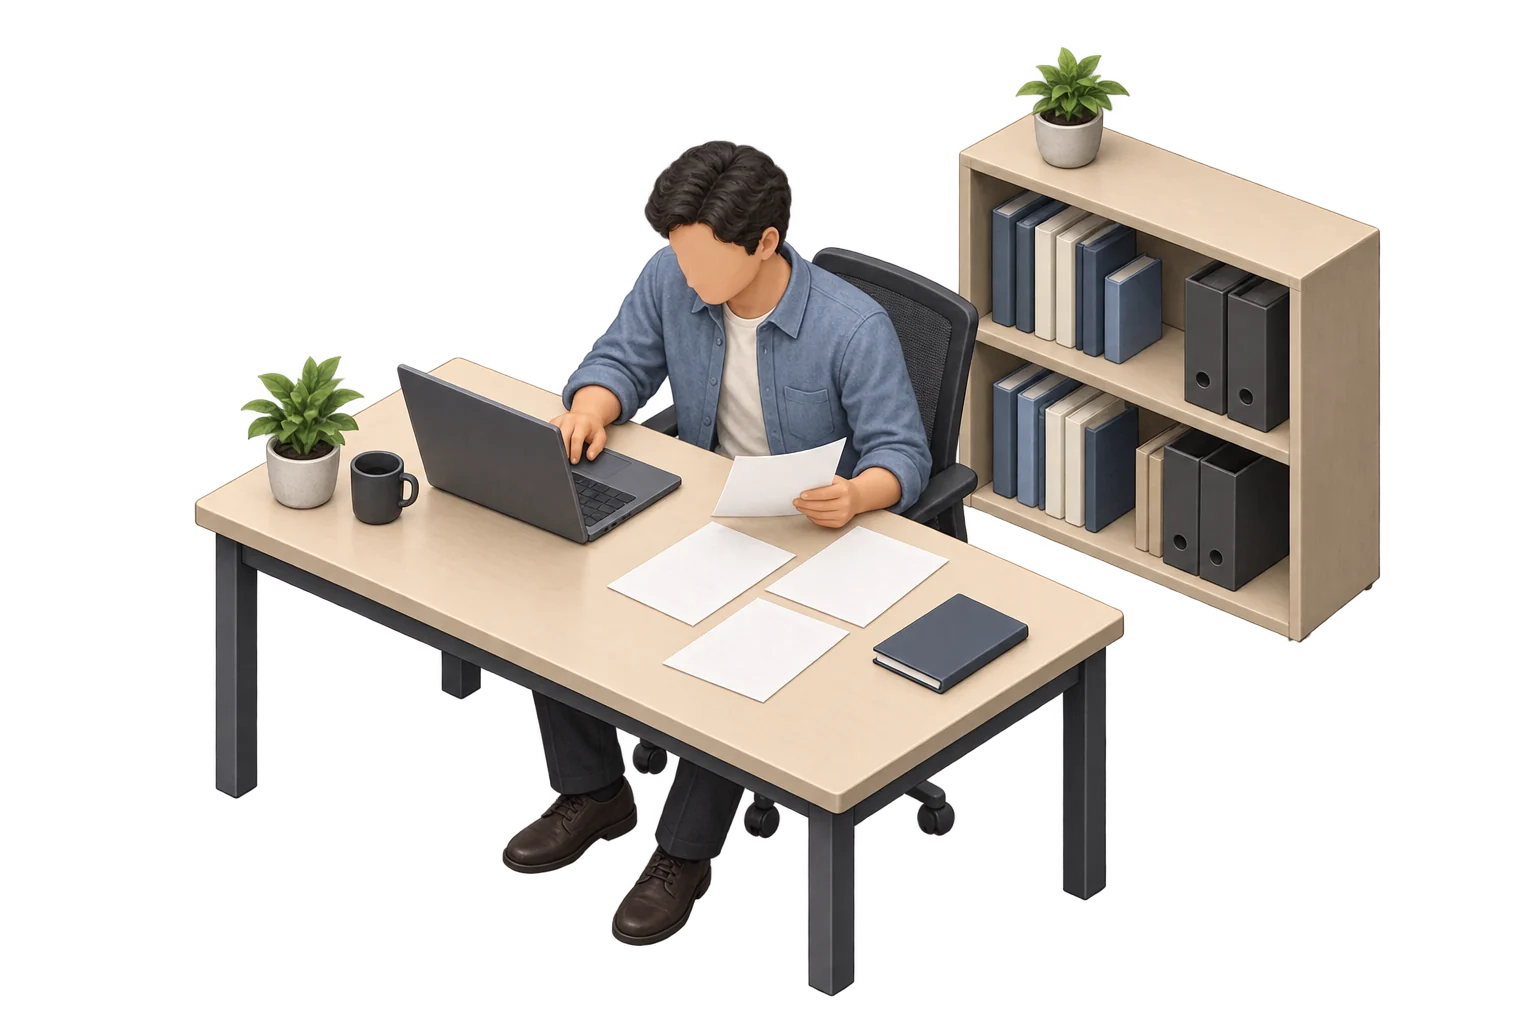
Na mesa: informações fornecidas desta vez
As instruções, dúvidas, histórico de conversas e materiais repassados pelo app para esse processo serão incluídos no contexto.
Dentro da estante: Materiais que ainda não foram entregues
Mesmo que você tenha salvo materiais ou conversas anteriores, talvez não consiga consultá-los, a menos que tenham sido entregues a você desta vez.
A janela de contexto é o comprimento máximo de informação que pode ser visualizada, geralmente expressa em tokens. A distribuição de materiais é separada do aprendizado adicional. Mesmo que você lhes dê materiais longos, isso não significa que eles possam usá-los corretamente.
Esta é uma ilustração explicativa que foi substituída por uma mesa e materiais.
Não corresponde ao número de caracteres/palavras
Os tokens podem ser palavras, partes de palavras, caracteres, etc. A divisão muda dependendo do modelo e do idioma, portanto, um caracter japonês nem sempre pode ser contado como um token.
Conversas e documentos também fornecem contexto
Instruções, histórico de conversas, materiais, etc. passados pelo aplicativo entram em contexto. Os limites de entrada e saída são tratados de forma diferente dependendo do modelo. Mesmo se você incluir material longo, não há garantia de que será capaz de usá-lo com precisão.
Por exemplo:Imagem de espalhar materiais sobre uma mesa
O contexto é semelhante aos materiais que você espalha em sua mesa para formular sua resposta. Ter os materiais na mesa é uma coisa, mas aprender mais sobre o modelo em si é outra.
Em AI Inc.
À medida que a quantidade de informação tratada aumenta, as cargas computacionais e de memória também mudarão nos serviços do mundo real. No jogo, verifique a inferência de demanda e oferta para fornecer aos seus clientes.
Mais parâmetros significam um modelo melhor?
Parâmetros são valores numéricos dentro do modelo que são ajustados durante o treinamento. Esta é uma pista para a escala do modelo, mas só porque há um grande número não significa que seja adequado para o propósito.
Mais parâmetros significam um modelo melhor?
Parâmetros são valores numéricos dentro do modelo que são ajustados durante o treinamento. Esta é uma pista para a escala do modelo, mas só porque há um grande número não significa que seja adequado para o propósito.
Parâmetros são valores numéricos dentro do modelo que são ajustados durante o treinamento. Esta é uma pista para a escala do modelo, mas só porque há um grande número não significa que seja adequado para o propósito.
Escolher modelo: tamanho, uso e custo
Compare não só a quantidade de produtos, mas também as condições de trabalho em que serão utilizados.
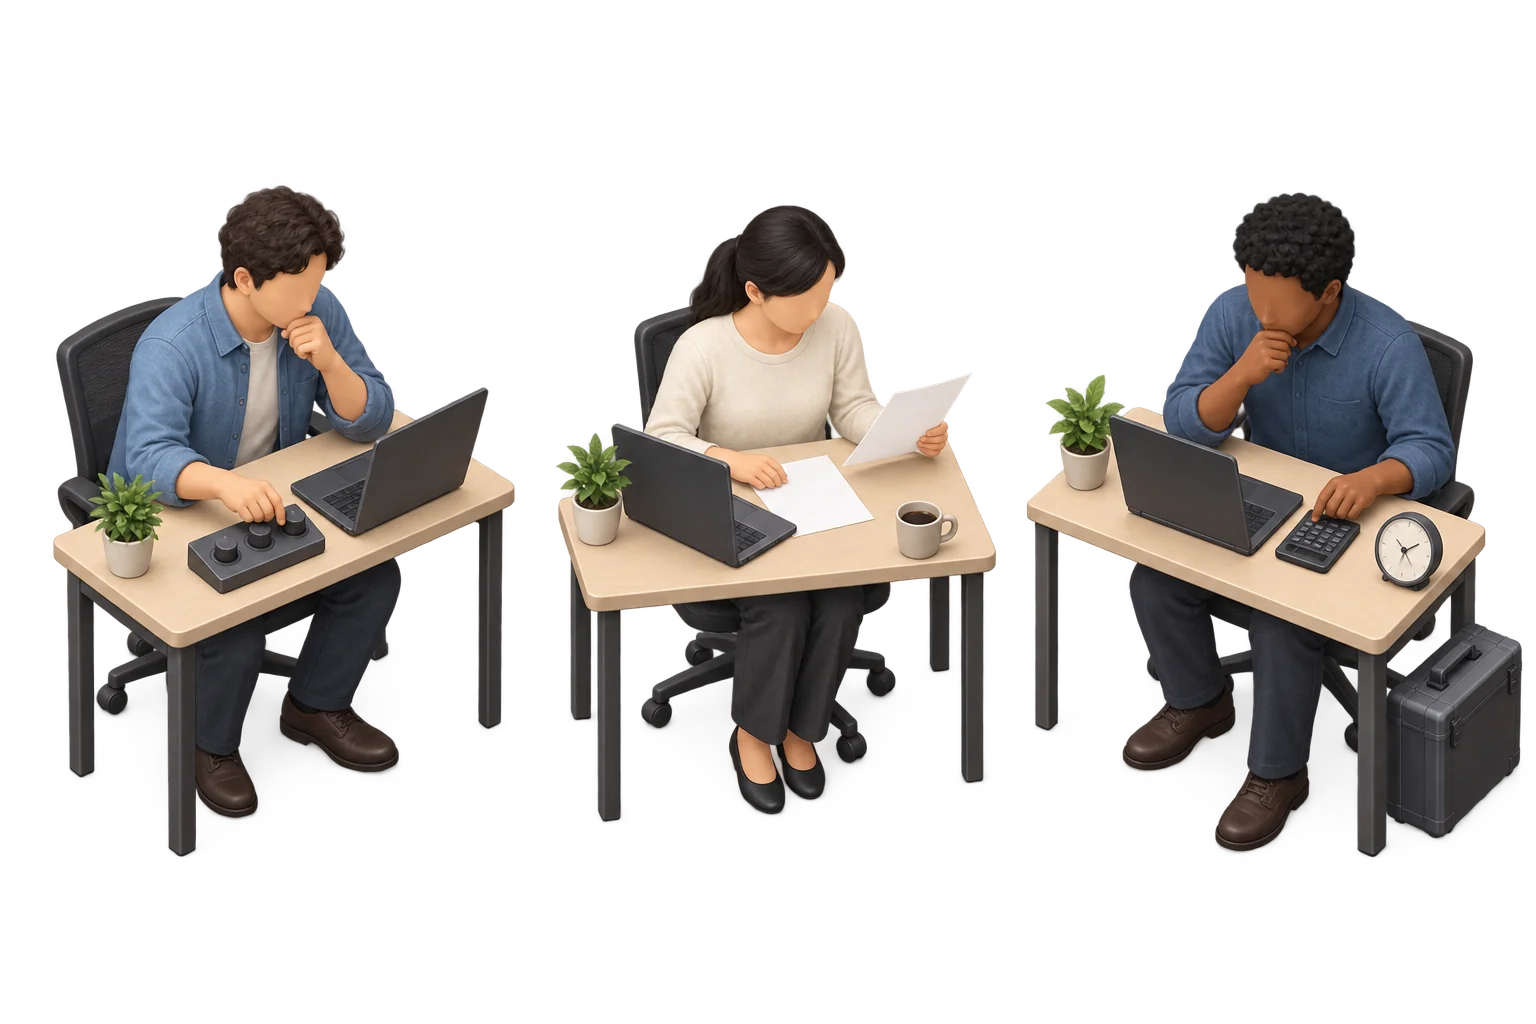
Esquerda: valores ajustados no treinamento
Os parâmetros são valores numéricos dentro do modelo. Só porque o número é grande não significa que seja adequado para a finalidade.
Centro: verificar na tarefa real
Teste-o com perguntas e materiais reais para ter certeza de que atende à qualidade que você precisa.
Direita: comparar também recursos e custos
Compare a velocidade, o custo, a carga computacional e de memória dos candidatos que atendem à qualidade exigida.
Um botão é uma metáfora para ajustar valores internos. O número de parâmetros não é o número de fatos conhecidos. Dados, design e métodos de aprendizagem também afetam os resultados.
Esta é uma ilustração explicativa que foi substituída por uma mesa e materiais.
Valores ajustados no treinamento
São valores como os pesos de uma rede neural. São ajustados a partir de muitos exemplos para produzir saídas adequadas ao objetivo. A quantidade de parâmetros não equivale à quantidade de fatos que o modelo conhece.
Considerar desempenho, recursos e uso juntos
Além da escala, a qualidade dos dados, o design e os métodos de aprendizagem afetam os resultados. Modelos grandes geralmente requerem mais recursos computacionais e memória, mas a configuração e a otimização também variam. Vamos comparar no uso real.
Por exemplo:Classificação breve e produção de textos complexos
Um modelo leve pode ser suficiente para classificar consultas curtas. Uma escrita mais complexa pode exigir um nível mais alto de habilidade. Compare a velocidade e o custo dos modelos que atendem à qualidade desejada.
Em AI Inc.
Ao projetar um modelo, observe não apenas o desempenho preditivo, mas também o custo de treinamento e a carga/velocidade de inferência. Combinaremos a decisão de aumentar a escala com a decisão de continuar como negócio.
Qual a diferença entre treinamento e inferência?
Aprendizagem é o processo de ajuste dos valores internos do modelo, e inferência é o processo de cálculo da resposta usando o modelo treinado. Recursos computacionais também são necessários para fornecer respostas aos usuários.
Qual a diferença entre treinamento e inferência?
Aprendizagem é o processo de ajuste dos valores internos do modelo, e inferência é o processo de cálculo da resposta usando o modelo treinado. Recursos computacionais também são necessários para fornecer respostas aos usuários.
Aprendizagem é o processo de ajuste dos valores internos do modelo, e inferência é o processo de cálculo da resposta usando o modelo treinado. Recursos computacionais também são necessários para fornecer respostas aos usuários.
Treinamento e inferência
Os cálculos são necessários ao criar e usar um modelo.
Treinamento: ajustar o modelo
Use dados de exemplo para ajustar os números dentro do modelo.
Inferência: usar um modelo treinado
Insira uma nova pergunta, etc., e calcule a resposta.
A inferência normal não atualiza os números dentro do modelo. Salvar conversas é uma coisa, aprender mais é outra.
Esta é uma ilustração explicativa que foi substituída por uma mesa e materiais.
Treinar: ajustar o modelo a partir de exemplos
Compare o resultado do exemplo com a meta de aprendizagem e ajuste os números internos. Se você separar o processo de criação de um modelo e o processo de utilização do modelo criado, será mais fácil entender a diferença entre recursos e custos.
Inferir: responder à solicitação atual
Calcula a saída da entrada usando números aprendidos. A inferência normal não é um processo de reaprender números internos cada vez que você responde. Referir-se a conversas e materiais como informações atuais é algo separado do aprendizado adicional.
Você pode ler a tabela movendo-a para a esquerda e para a direita.
| O que verificar | Treinamento | Inferência |
|---|---|---|
| Objetivo | Ajustar parâmetros a partir de exemplos | Calcular a saída para uma nova entrada |
| Exemplo de entrada | Textos de treinamento e exemplos de perguntas e respostas | Perguntas do usuário e documentos consultados |
| Valores internos | Atualizar por meio de treinamento | Não é atualizado durante a inferência habitual |
| Como usar recursos | Computação para criar e melhorar modelos | Cálculos para processamento de solicitações de clientes |
Por exemplo:Criar também implica custos de operação
Mesmo que você complete um modelo que responde a uma consulta, ainda precisará fazer inferências sempre que um usuário fizer uma pergunta. À medida que mais pessoas o utilizam ao mesmo tempo, a capacidade de entrega necessária também aumenta.
Cuidados
Salvar conversas e usar entradas para aprendizado futuro é uma política de serviço diferente da atualização de parâmetros durante a resposta atual.
Em AI Inc.
Os recursos computacionais para aprendizagem e inferência são funções separadas. Mesmo que a aprendizagem seja concluída, se a alocação para inferência for insuficiente, haverá escassez de oferta aos clientes.
O que são pré-treinamento e ajuste fino?
O pré-treinamento é o processo de aprendizagem de regularidades básicas a partir de uma ampla gama de dados, e o ajuste fino é o processo de ajuste do modelo treinado com dados adicionais.
O que são pré-treinamento e ajuste fino?
O pré-treinamento é o processo de aprendizagem de regularidades básicas a partir de uma ampla gama de dados, e o ajuste fino é o processo de ajuste do modelo treinado com dados adicionais.
O pré-treinamento é o processo de aprendizagem de regularidades básicas a partir de uma ampla gama de dados, e o ajuste fino é o processo de ajuste do modelo treinado com dados adicionais.
Pré-treinamento e treinamento adicional
Construa uma base e ajuste-a de acordo com o trabalho para o qual você a usará.
Esquerda: criar uma base com exemplos diversos
Aprenda regras básicas usando muitas frases. Este é o processo de ajuste dos valores numéricos dentro do modelo.
Direita: ajustar com exemplos do uso previsto
Use o modelo treinado como ponto de partida e aprenda adicionalmente com exemplos adequados ao seu trabalho e formato de saída. O ajuste fino atualiza os valores internos.
Dar instruções em um prompt ou fornecer documentos por RAG é diferente do treinamento adicional. Para verificar se o treinamento melhorou o modelo, são usados exemplos que não fizeram parte dele.
Esta é uma ilustração explicativa que foi substituída por uma mesa e materiais.
Criar uma base com pré-treinamento
Muitos modelos de linguagem aprendem as regularidades das palavras resolvendo um grande número de tarefas, como prever a continuação de uma frase. Ao usar uma base pré-treinada, não há necessidade de criar um modelo do zero a cada vez.
Adaptar ao uso com treinamento adicional
Exemplos de perguntas e respostas desejadas tornam as instruções mais fáceis de seguir ou adaptadas a tarefas e formatos de saída específicos. Aprender a responder às instruções e usar as avaliações das pessoas está incluído no pós-treinamento, após o pré-aprendizado.
Por exemplo:Padronizar o formato de classificação de consultas
Aprendizagem adicional pode ser considerada para facilitar a produção em um formato fixo usando frases de investigação e exemplos de classificação de “faturamento”, “contrato” e “operação”. Verifique se as melhorias foram feitas usando exemplos que não foram utilizados para aprendizagem.
Cuidados
O treinamento adicional é diferente de RAG, que busca documentos. Não deve ser escolhido automaticamente como forma de garantir que o modelo memorize fatos novos.
Em AI Inc.
O desenvolvimento derivado usando um modelo pai leva à ideia de aproveitar a base existente. Por favor, leia a tela de confirmação do alvo para saber as condições de desempenho e custo a serem transportadas no jogo.
Basta aumentar os dados de treinamento?
Os dados precisam não apenas de quantidade, mas também de precisão, variedade e proximidade de uso. Um estado em que o sistema é forte apenas com exemplos que viu durante o treinamento e fraco com novos exemplos é chamado de "overfitting".
Basta aumentar os dados de treinamento?
Os dados precisam não apenas de quantidade, mas também de precisão, variedade e proximidade de uso. Um estado em que o sistema é forte apenas com exemplos que viu durante o treinamento e fraco com novos exemplos é chamado de "overfitting".
Os dados precisam não apenas de quantidade, mas também de precisão, variedade e proximidade de uso. Um estado em que o sistema é forte apenas com exemplos que viu durante o treinamento e fraco com novos exemplos é chamado de "overfitting".
Dados de treinamento: quantidade, qualidade e verificação
Não apenas adicione mais exemplos, limpe-os e compare-os com outros exemplos.
Quantidade: Existem apenas exemplos semelhantes?
Aumentar a quantidade de exemplos não basta para cobrir as situações de uso se houver muitas duplicatas ou vieses.
Qualidade: prepare exemplos que correspondam à situação de uso
Revise erros e duplicações e prepare uma ampla variedade de exemplos que estejam próximos da pergunta, linguagem e público reais.
Avaliação: verificar com exemplos não usados no treinamento
Separe as partes para aprendizado, verificação para ajuste e teste final. Vamos verificar com um exemplo que não foi utilizado no estudo.
Overfitting é um estado em que o sistema é forte apenas com exemplos vistos durante o treinamento e fraco com novos exemplos. Observamos a quantidade, a qualidade e a proximidade dos dados com o uso pretendido.
Esta é uma ilustração explicativa que foi substituída por uma mesa e materiais.
Preparar exemplos próximos do uso real
Erros, duplicação e dados tendenciosos também podem afetar seus resultados. Decida que tipo de perguntas, linguagem e usuários você espera e prepare exemplos que representem o uso real.
Separar dados de treinamento e avaliação
Se você avaliar apenas os exemplos que memorizou durante o aprendizado, será difícil avaliar se você consegue lidar com novas informações. Também distinguimos entre os dados de verificação utilizados para ajuste e os dados de teste utilizados para confirmação final.
Por exemplo:Aprendendo apenas com perguntas curtas
Mesmo que você seja bom em frases curtas e fixas, poderá ser fraco em consultas longas ou em perguntas com frases diferentes. Verificaremos os dados não utilizados, incluindo exemplos realmente escritos pelos usuários.
Em AI Inc.
Licenciamento de dados, manutenção e seleção para aprendizagem são etapas separadas. Depois de entender o conceito de qualidade de dados na vida real, será mais fácil entender o propósito da manutenção em jogos.
Escrever um prompt é treinar?
Prompts são instruções ou informações que você passa para o seu modelo. Normalmente, as condições de resposta são alteradas, o que é diferente do aprendizado, que atualiza os parâmetros do modelo.
Escrever um prompt é treinar?
Prompts são instruções ou informações que você passa para o seu modelo. Normalmente, as condições de resposta são alteradas, o que é diferente do aprendizado, que atualiza os parâmetros do modelo.
Prompts são instruções ou informações que você passa para o seu modelo. Normalmente, as condições de resposta são alteradas, o que é diferente do aprendizado, que atualiza os parâmetros do modelo.
Prompt: objetivo, documentos e formato
Diga a eles o que você deseja que façam, o que usar e como responder.
Objetivo: Diga-nos o que você deseja
Anote a tarefa específica que você está solicitando, como “resumir as atas”.
Documentos: indicar o escopo de uso
Dê-lhes a ata que você gostaria que eles consultassem e indique o escopo da reunião, dizendo: “Só usarei este material”.
Formato: indicar a forma da resposta
Especifique o formato da saída, como "Decisões em três marcadores".
A passagem de instruções e materiais geralmente é separada do aprendizado adicional do modelo. Mesmo que as instruções sejam específicas, ainda ocorrerão erros, portanto, compare suas respostas com os materiais.
Esta é uma ilustração explicativa que foi substituída por uma mesa e materiais.
Transmita o propósito, os materiais e o formato de saída
Escreva detalhadamente o que você deseja que eles façam, que informações deseja que usem e como deseja que respondam. Se necessário, passe também um exemplo da saída desejada.
Continuar a conversa amplia as informações disponíveis
A razão pela qual você pode usar instruções anteriores é porque o aplicativo possui um mecanismo para passá-las ao modelo. Simplesmente ser capaz de usar novas informações durante uma conversa não significa que o modelo tenha aprendido permanentemente.
Por exemplo:Detalhar o pedido “Resuma”
Comunique o propósito, o escopo e o formato, como: ``Por favor, use apenas a ata a seguir e liste as decisões em três pontos. Por favor, não preencha nada que não esteja no documento.''
Cuidados
Instruções detalhadas podem ajudar, mas não garantem que estarão livres de erros. Vamos verificar o resultado em relação ao material real.
Em AI Inc.
Projetar um modelo e começar a aprender em um jogo é diferente de escrever instruções em um bate-papo da vida real. Simplesmente salvar o projeto não acarretará no custo e no progresso deste estudo.
O que são RAG e embeddings? Como se diferenciam do treinamento adicional?
RAG é um método que busca os materiais necessários para uma resposta e passa o conteúdo encontrado ao modelo para gerá-lo. Os materiais a serem pesquisados são gerenciados separadamente dos parâmetros do modelo.
O que são RAG e embeddings? Como se diferenciam do treinamento adicional?
RAG é um método que busca os materiais necessários para uma resposta e passa o conteúdo encontrado ao modelo para gerá-lo. Os materiais a serem pesquisados são gerenciados separadamente dos parâmetros do modelo.
RAG é um método que busca os materiais necessários para uma resposta e passa o conteúdo encontrado ao modelo para gerá-lo. Os materiais a serem pesquisados são gerenciados separadamente dos parâmetros do modelo.
RAG: buscar documentos antes de responder
Passe o material recuperado para a modelo responder.
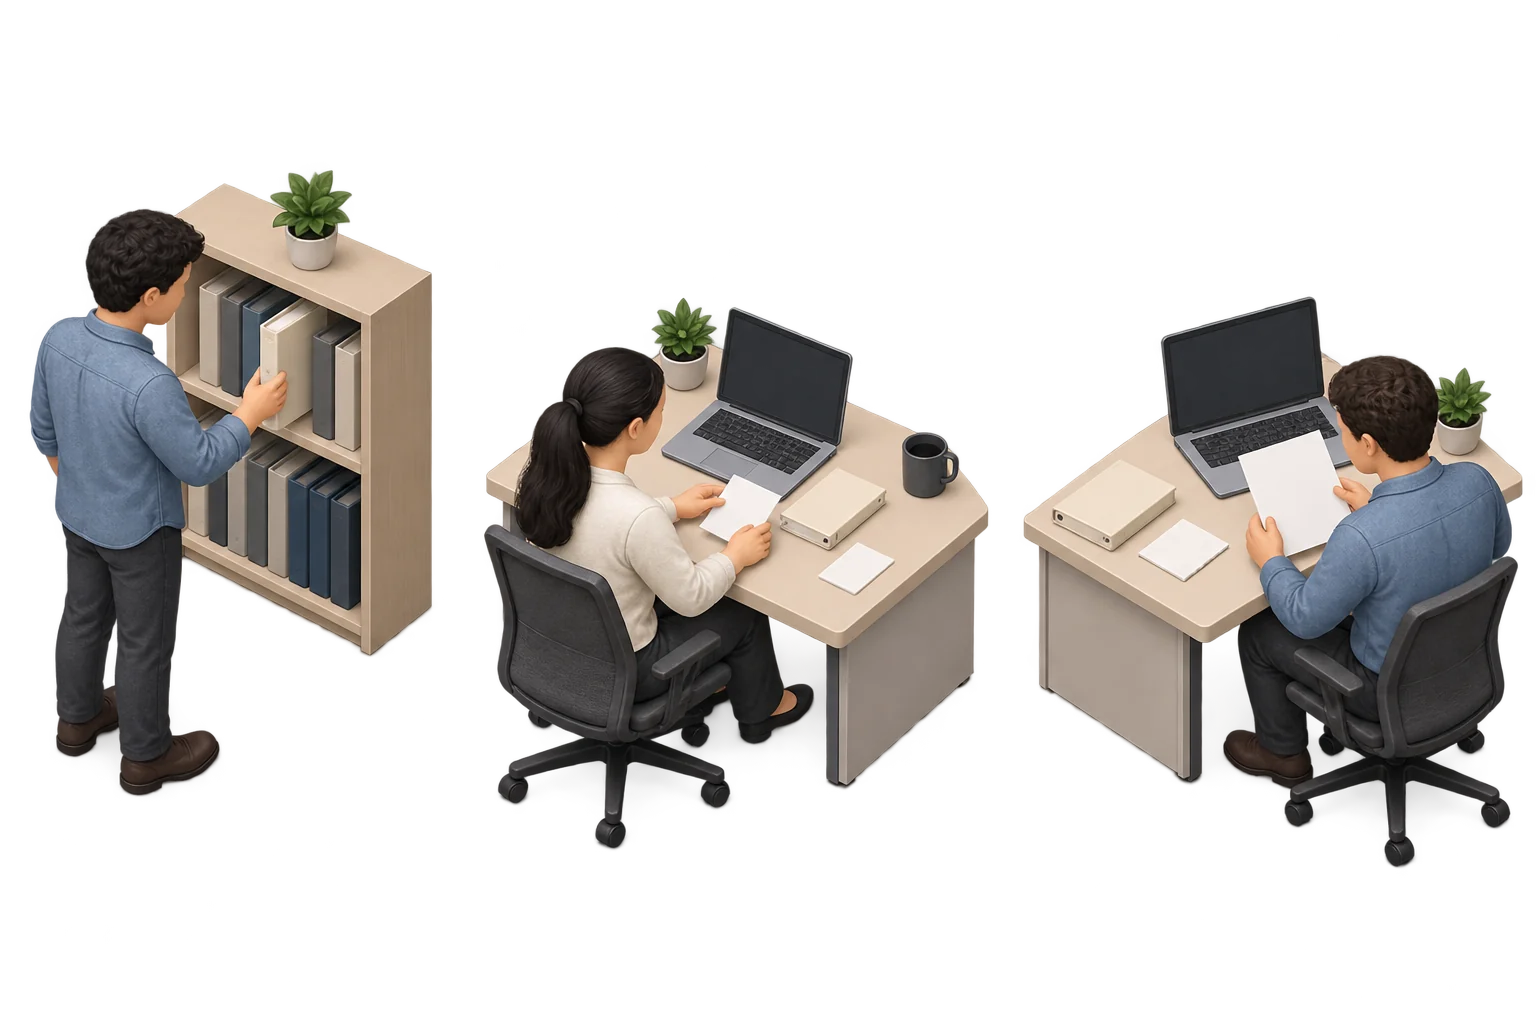
Pesquise materiais relacionados
Procure a peça que você precisa nos manuais que correspondem à sua pergunta.
Fornecer junto com a pergunta
Passe o material encontrado para o modelo como informação para referência na resposta.
Responda consultando os materiais
O modelo gera uma resposta. Verifique também se o material apoia sua resposta.
Fornecer documentos não equivale a treinar adicionalmente o modelo. Os documentos podem estar desatualizados e a resposta pode se afastar deles; por isso, RAG sozinho não garante a exatidão.
Esta é uma ilustração explicativa que foi substituída por uma mesa e materiais.
Buscar → fornecer documentos → responder
Pesquise manuais internos da empresa relacionados à sua dúvida e passe as partes relevantes junto com sua dúvida. Não há necessidade de treinar novamente todo o modelo para fazer referência à documentação atualizada.
Buscar conteúdo semelhante com embeddings
Um embedding representa características de um texto ou de outros dados por uma sequência de números. A proximidade entre essas representações pode ser usada na busca. RAG também pode usar buscas por palavras-chave ou combinar os dois métodos.
Diferentes formas de fornecer informações
Usando como exemplo a resposta à consulta, separaremos as informações a serem passadas desta vez e os números a serem ajustados durante o aprendizado.
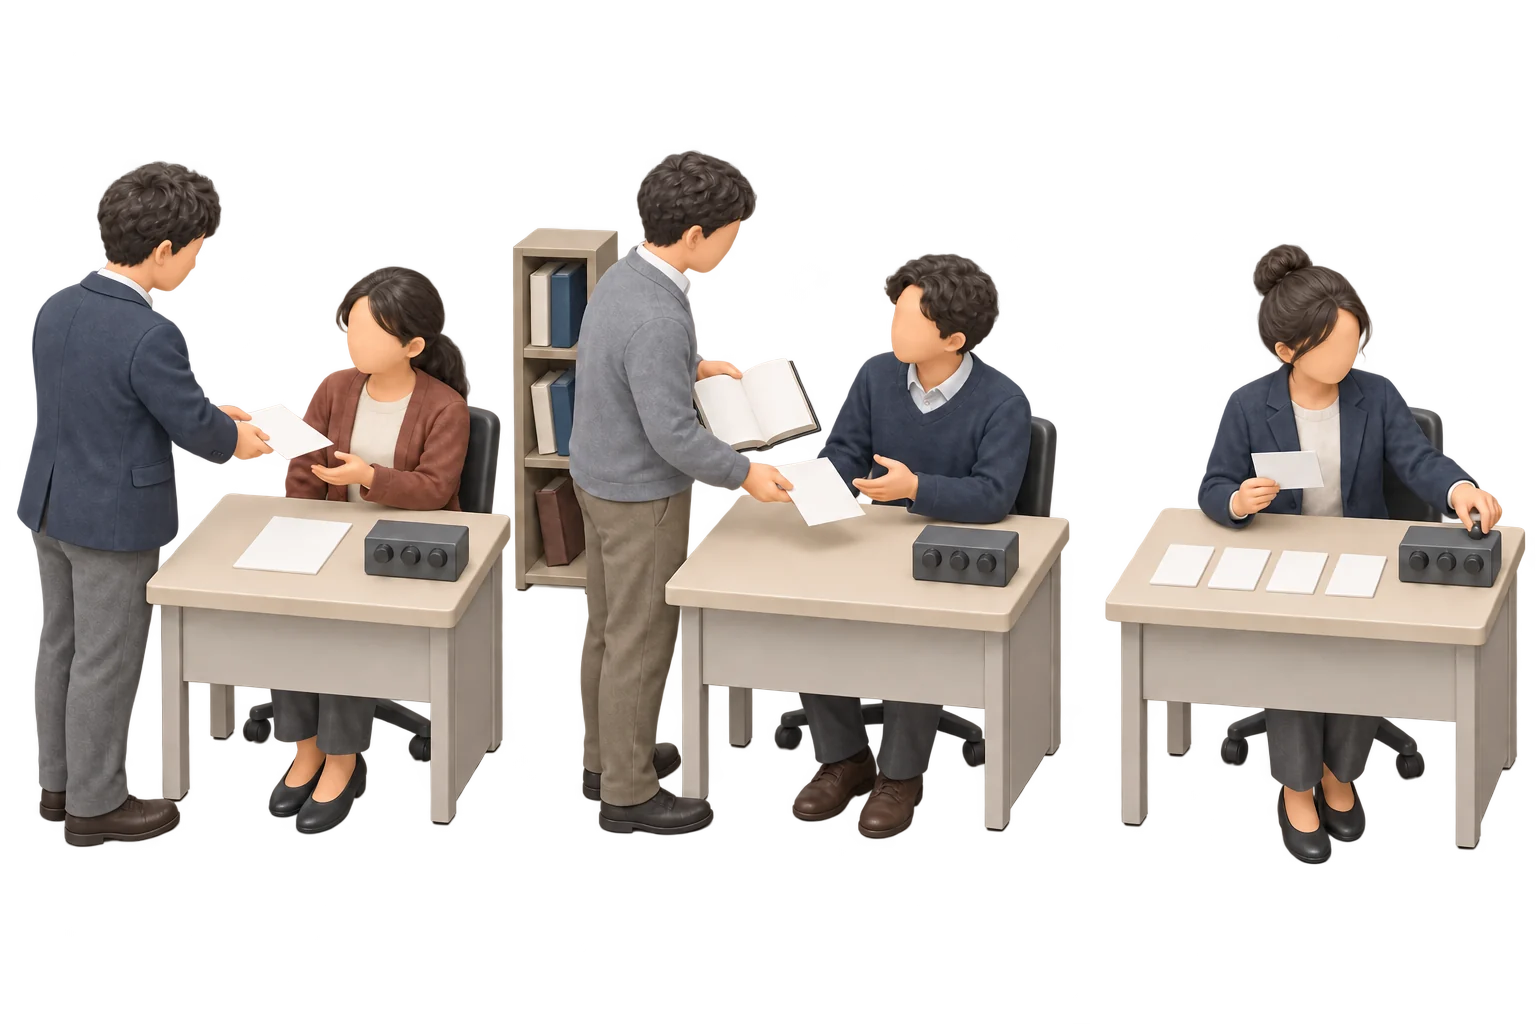
Esquerda: prompt
Dê-lhes instruções e materiais, como “Mantenha suas respostas em duas frases”. A resposta usual não atualiza os números dentro do modelo.
Centro: RAG
Encontre um manual que atenda à sua pergunta e repasse as partes necessárias junto com as instruções. O próprio processo de localização e passagem dos dados não atualiza os valores numéricos dentro do modelo.
Direita: ajuste fino
Ajuste os números internos do modelo treinado com um exemplo de consulta e classificação desejada. É utilizado para corresponder ao formato de classificação “Faturamento/Contrato/Operação”.
Os três métodos podem ser combinados. Em RAG, os documentos recuperados são incluídos no prompt. Pense se precisa usar documentos que são atualizados ou adaptar o formato da saída e verifique com perguntas reais.
Um botão é uma metáfora que representa um valor numérico dentro de um modelo. As três cenas são comparações de métodos, não de ordem de trabalho.
Por exemplo:Se o horário de atendimento mudar
Pesquise materiais com novos horários de funcionamento e forneça-os como prova de sua resposta. Se você procurar material antigo, até o RAG pode ser uma resposta antiga.
Cuidados
É possível que os materiais se misturem ou que sejam geradas informações que não estão nos materiais. Avalie os resultados da pesquisa e a saída para garantir que as referências realmente apoiam a resposta.
Em AI Inc.
Este é o conhecimento básico para serviços de IA do mundo real. Isso não significa que você pode configurar RAG individualmente no jogo. Isso leva à ideia de selecionar modelos e dados adequados à finalidade.
O que é alucinação? Por que verificar a resposta?
Alucinação é a criação de conteúdo plausível que não pode ser sustentado por fatos ou documentos. Informações ou fontes inexistentes podem ser misturadas na escrita natural.
O que é alucinação? Por que verificar a resposta?
Alucinação é a criação de conteúdo plausível que não pode ser sustentado por fatos ou documentos. Informações ou fontes inexistentes podem ser misturadas na escrita natural.
Alucinação é a criação de conteúdo plausível que não pode ser sustentado por fatos ou documentos. Informações ou fontes inexistentes podem ser misturadas na escrita natural.
Alucinações e verificação de fontes
Mesmo que a resposta seja fácil de ler, abra a fonte e verifique.
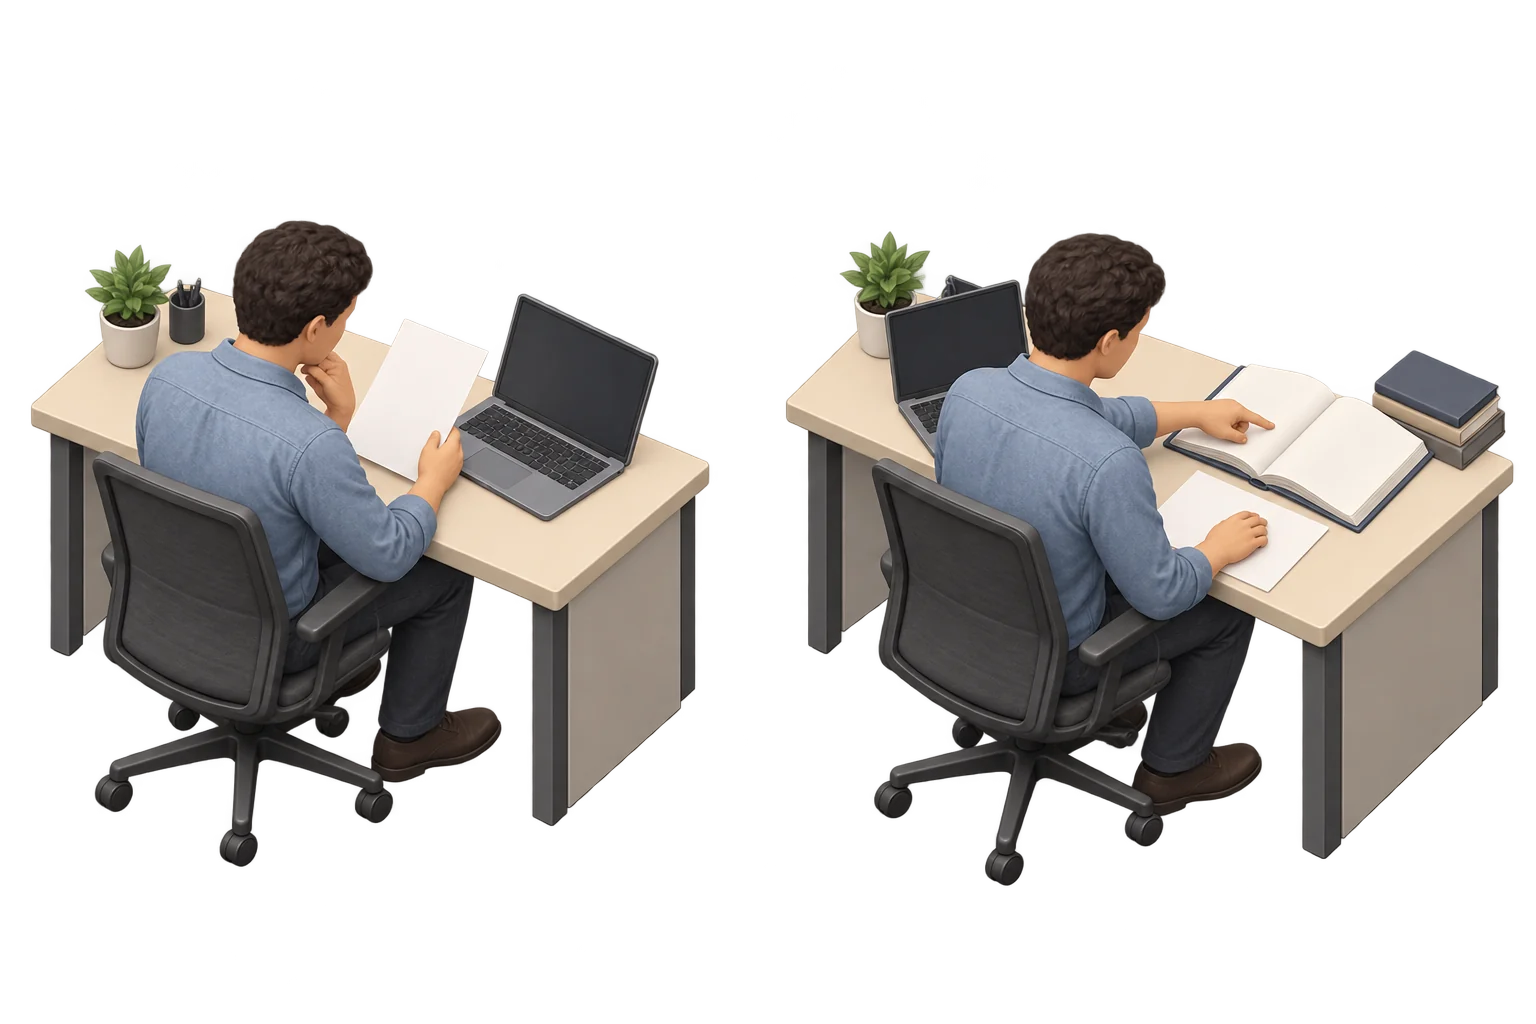
Esquerda: ler uma resposta natural
Explicações detalhadas e nomes de documentos específicos por si só não podem ser usados para determinar se há suporte factual.
Direita: conferir com o original
Abra a fonte e verifique se há partes que apoiam sua resposta e se os números, datas e nomes das pessoas coincidem.
Mesmo que exista uma fonte, ela não necessariamente apoia a resposta. Se não conseguirmos encontrar nenhuma prova, não a consideraremos como facto e verificaremos outros materiais.
Esta é uma ilustração explicativa que foi substituída por uma mesa e materiais.
A naturalidade do texto e a veracidade dos fatos são duas coisas diferentes.
Um LLM calcula uma saída adequada ao contexto. Um tom confiante ou uma explicação detalhada não bastam para demonstrar que há fundamento. O uso de buscas ou cálculos pelo modelo também depende de como o aplicativo funciona.
Verifique a evidência abrindo-a
Verifique partes relevantes de documentos, números, datas, nomes de pessoas, etc. Mesmo que exista uma citação, ela não necessariamente sustenta a resposta. Se você disser que não sabe, incluiremos isso em sua avaliação.
Por exemplo:Crie um nome de documento provável
Quando perguntado “Onde você conseguiu esse recurso?”, você poderá encontrar uma referência a um manual inexistente. Mesmo que o nome do documento seja específico, verifique se o original está disponível.
Cuidados
Pesquisa, RAG, aprendizado adicional, etc. ajudam a reduzir erros, mas não garantem a correção. Mesmo se você reduzir a variação na produção, respostas incorretas poderão ser corrigidas.
Em AI Inc.
A avaliação externa é um material que permite ler o que foi confirmado e em que medida. O alto desempenho e os resultados da avaliação por si só não garantem segurança para todas as aplicações.
Se o benchmark for alto, você pode fornecê-lo como está?
Um benchmark é uma avaliação para comparar o desempenho em uma tarefa fixa. É necessário confirmar separadamente se é útil na aplicação real do cliente.
Se o benchmark for alto, você pode fornecê-lo como está?
Um benchmark é uma avaliação para comparar o desempenho em uma tarefa fixa. É necessário confirmar separadamente se é útil na aplicação real do cliente.
Um benchmark é uma avaliação para comparar o desempenho em uma tarefa fixa. É necessário confirmar separadamente se é útil na aplicação real do cliente.
Avaliação: desafios comuns e aplicações práticas
Verifique os problemas comuns e as condições de trabalho separadamente.
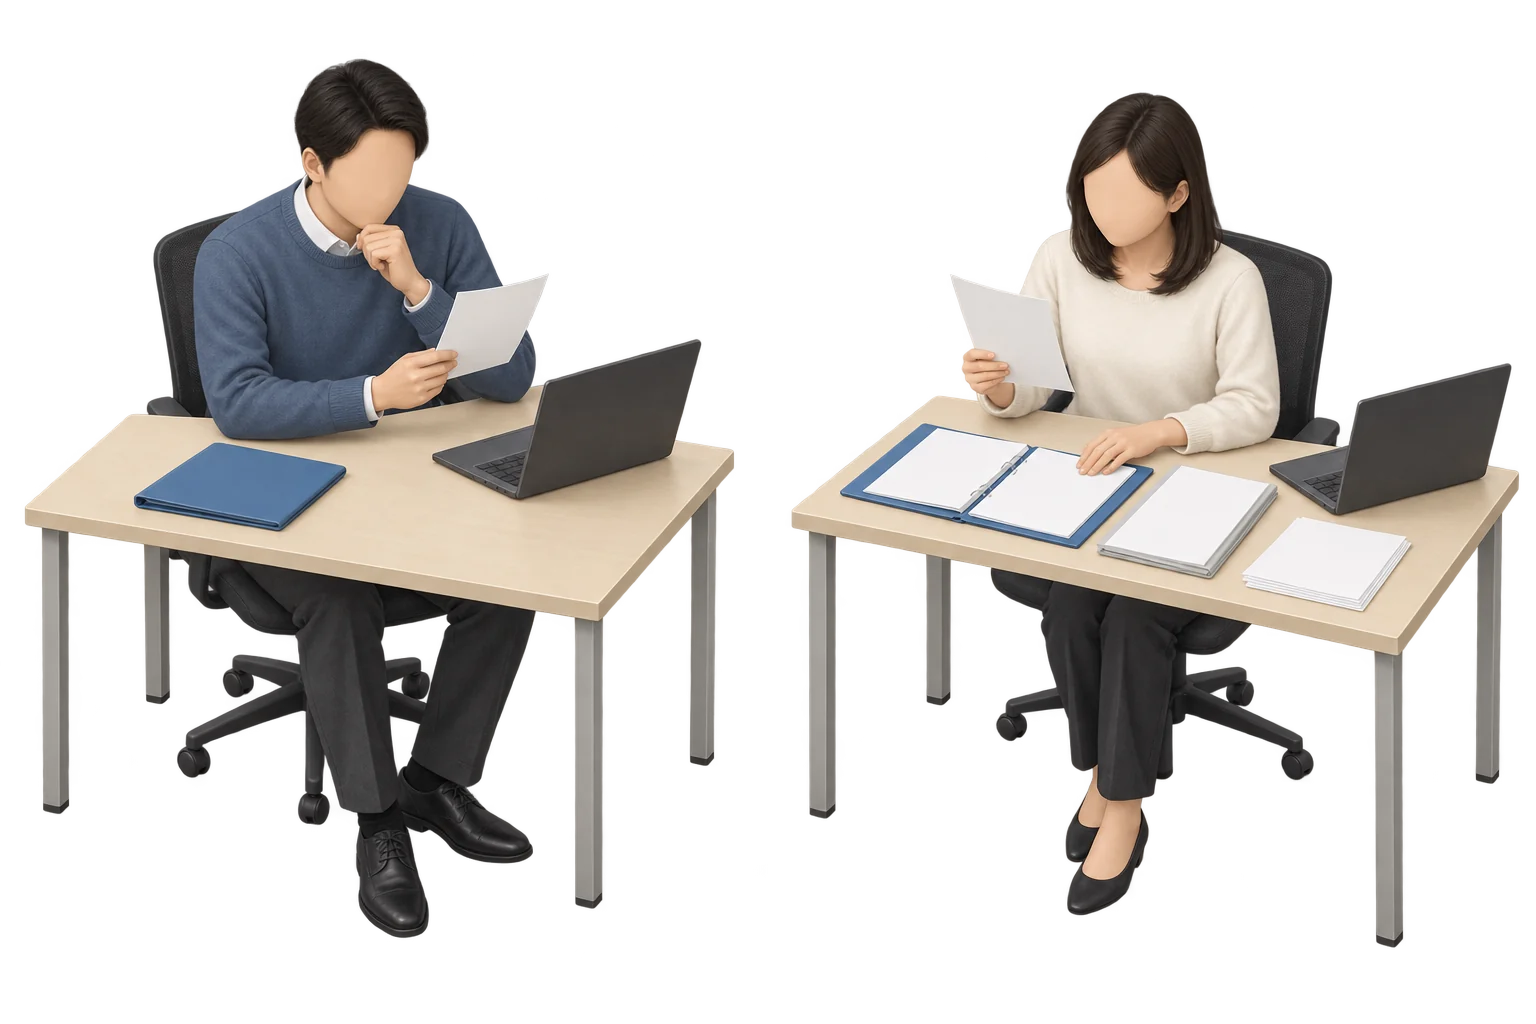
Esquerda: ler resultados de tarefas comuns
Compare o desempenho dos modelos usando as mesmas questões e condições de pontuação. Leia a folha de resultados para verificar o escopo das tarefas que você tentou.
Direita: testar nas condições de uso
Use materiais e perguntas reais para confirmar se os números e prazos exigidos permanecem. Também analisaremos a velocidade e o custo da resposta.
Os resultados do benchmark por si só não podem ser usados para concluir que são úteis para qualquer trabalho. Primeiro decidimos as condições que se adequam à aplicação do cliente e depois verificamos mesmo após alteração de modelos e materiais.
Papel e pastas são metáforas para descrever resultados de tarefas comuns e confirmação em aplicações do mundo real. Esquerda e direita não são a ordem dos processos e nenhuma delas garante sucesso, segurança ou entrega. A quantidade de pessoas e materiais não representa a quantidade de testes.
Testar em condições próximas do trabalho real
Compare a linguagem utilizada, os materiais utilizados, a extensão das perguntas, o formato exigido, etc. Inclua exemplos que você não usou em seus estudos ou perguntas que não consegue responder.
Avaliar todo o serviço, além do modelo
Verificamos não apenas a taxa de resposta correta e a justificativa, mas também a velocidade de resposta, custo, falhas de pesquisa, operação da ferramenta, etc. Se você olhar apenas para a pontuação média, poderá ignorar modelos que são fracos em determinadas condições.
Por exemplo:Mesmo que você seja bom em resumir, ainda poderá perder os números.
Mesmo um resumo de fácil leitura não terá utilidade se o valor ou o prazo da fatura estiver faltando. Decida primeiro o que precisa permanecer e avalie sob essas condições.
Cuidados
A avaliação reflete o que foi observado nas condições e no momento do teste. Não garante resultados para usos que não foram avaliados. Verifique novamente os resultados após alterar o modelo ou os documentos.
Em AI Inc.
Isto leva à razão pela qual a avaliação do modelo, a publicação, o fornecimento antecipado e a migração do cliente são julgados separadamente. Vejamos os resultados dos testes juntamente com os resultados reais de fornecimento e vendas.
Como a GPU, a memória e a velocidade de resposta estão relacionadas?
Os LLMs realizam muitos cálculos e usam equipamentos como GPUs, eficientes em processamento paralelo. A memória, o uso simultâneo e o tamanho das respostas também influenciam o serviço.
Como a GPU, a memória e a velocidade de resposta estão relacionadas?
Os LLMs realizam muitos cálculos e usam equipamentos como GPUs, eficientes em processamento paralelo. A memória, o uso simultâneo e o tamanho das respostas também influenciam o serviço.
Os LLMs realizam muitos cálculos e usam equipamentos como GPUs, eficientes em processamento paralelo. A memória, o uso simultâneo e o tamanho das respostas também influenciam o serviço.
Inferência: espera e volume de processamento
Há uma diferença entre responder rapidamente a uma solicitação e lidar com muitas solicitações.
Esquerda: espera de uma solicitação
Latência é o tempo entre fazer uma solicitação e receber uma resposta. Às vezes medimos a primeira letra e o final da resposta.
Direita: processamento por unidade de tempo
A taxa de transferência é o número de solicitações ou tokens que podem ser processados em um determinado período de tempo. Também verificaremos o volume de processamento e o tempo de espera quando o número de pessoas utilizando o serviço aumentar ao mesmo tempo.
Mesmo que seja rápido quando usado por uma pessoa, verifique o tempo de espera e o volume de processamento separadamente quando estiver lotado. As condições variam não apenas pelo poder de processamento da GPU, mas também pela memória, uso simultâneo e duração da resposta.
Esta é uma ilustração explicativa que foi substituída por uma mesa e materiais.
A velocidade do cálculo e a quantidade de informações que podem ser armazenadas são duas coisas diferentes.
A GPU é responsável pelos cálculos, e a memória é onde são armazenados o modelo e as informações que estão sendo processadas. Será mais fácil entender se você pensar no espaço que pode colocar em sua mesa de trabalho e na velocidade com que pode trabalhar. Esta analogia é uma explicação da função e não calcula o desempenho real a partir do número de mesas.
Veja o tempo de espera por uma única resposta e a quantidade total de processamento
Latência é o tempo que leva para esperar por uma solicitação e taxa de transferência é a quantidade que pode ser processada em um determinado período de tempo. O tempo que leva para obter a primeira letra e o tempo que leva para obter a resposta longa inteira também são diferentes. Ao medir o uso simultâneo e a extensão da resposta, fica mais fácil comparar as condições de oferta.
| Métrica | O que observar |
|---|---|
| Latência | O tempo de espera para que uma única solicitação receba uma resposta. Distinguir entre a primeira letra e o final de toda a frase. |
| Taxa de processamento | Solicitações ou tokens processados por unidade de tempo. |
| Memória | Capacidade para armazenar modelos e informações em processamento. |
| Custo | Custo do equipamento e operação necessários. Varia dependendo do modelo e das condições de fornecimento. |
Por exemplo:Rápido para uma pessoa; com demanda, há espera
Apenas saber o quão rápido ele é quando usado por uma pessoa não diz o que ele pode fornecer quando 100 pessoas o usam ao mesmo tempo. Ele mede o tempo de espera e a quantidade de processamento que pode ser feito em um determinado período de tempo.
Em AI Inc.
Verificamos não apenas o número de GPUs, mas também seu status de entrega e operação, bem como a distribuição de pesquisas, aprendizado e inferência. A métrica de fornecimento de um jogo não é um valor de conversão para o número real de tokens ou tempo de espera.
O que é IA multimodal?
É uma IA que lida com vários tipos de informações, como texto, imagens e áudio. “Modalidade” refere-se ao tipo de informação. As entradas e saídas que podem ser tratadas variam dependendo do modelo.
O que é IA multimodal?
É uma IA que lida com vários tipos de informações, como texto, imagens e áudio. “Modalidade” refere-se ao tipo de informação. As entradas e saídas que podem ser tratadas variam dependendo do modelo.
É uma IA que lida com vários tipos de informações, como texto, imagens e áudio. “Modalidade” refere-se ao tipo de informação. As entradas e saídas que podem ser tratadas variam dependendo do modelo.
Multimodal: texto, imagem e áudio
Use diferentes tipos de informações juntos.
Esquerda: comunicar com texto
Insira textos como perguntas, explicações e materiais.
Centro: usar também imagens
Uma maneira de usar isso é combinar texto e imagens para explicar o que é mostrado.
Direita: usar também áudio
Nos modelos compatíveis, você pode inserir sua voz e tirar dúvidas sobre o conteúdo.
As entradas e saídas que podem ser tratadas variam dependendo do modelo. Só porque você pode inserir uma imagem não significa que você pode gerar uma imagem. Verifique os resultados cuidadosamente em busca de imagens escuras ou áudio difícil de ouvir.
Esta é uma ilustração explicativa que foi substituída por uma mesa e materiais.
Combine diferentes tipos de informações
Explique o que está na imagem em texto, ou ouça o áudio e responda o que está na imagem. Um modelo que pode inserir imagens não necessariamente também gera imagens.
As condições da entrada também mudam o resultado
Texto pequeno, imagens escuras e vozes difíceis de ouvir podem causar reconhecimento incorreto. Mesmo que você consiga lidar com várias informações, é necessário verificar a precisão de cada informação.
Por exemplo:Perguntar como agir anexando uma foto
Esta é uma forma de combinar a foto de uma máquina com o texto "O que é este botão?" Se o botão não estiver legível na foto, o modelo pode adivinhar incorretamente.
Em AI Inc.
Ao escolher um campo de pesquisa ou mercado, isso o ajudará a considerar se seus clientes precisam apenas de texto ou se também precisam de imagens e áudio. Verifique a descrição do jogo para recursos compatíveis.
Qual é a diferença entre um agente de IA e uma IA que responde?
O agente de IA seleciona etapas em direção a um objetivo e usa pesquisas, ferramentas, etc., para prosseguir com a tarefa. A capacidade de responder sentenças e a autoridade para agir são duas coisas diferentes.
Qual é a diferença entre um agente de IA e uma IA que responde?
O agente de IA seleciona etapas em direção a um objetivo e usa pesquisas, ferramentas, etc., para prosseguir com a tarefa. A capacidade de responder sentenças e a autoridade para agir são duas coisas diferentes.
O agente de IA seleciona etapas em direção a um objetivo e usa pesquisas, ferramentas, etc., para prosseguir com a tarefa. A capacidade de responder sentenças e a autoridade para agir são duas coisas diferentes.
IA que responde e agentes de IA
Separe a leitura da proposta do trabalho com as ferramentas.
Esquerda: receber uma proposta escrita
Proponha a programação do candidato, etc., por escrito. Apenas ler a proposta não mudará sua reserva nem nada.
Direita: usar ferramentas e verificar resultados
Selecione as etapas de acordo com sua finalidade, prossiga com o trabalho utilizando ferramentas como busca e cálculo e confira os resultados.
Ter uma ferramenta conectada e ter autoridade para operá-la são duas coisas diferentes. Para envio, compra, exclusão, etc., decida o escopo da permissão e as condições de aprovação.
Esta é uma ilustração explicativa que foi substituída por uma mesa e materiais.
Verifique os resultados usando ferramentas
Combine operações como pesquisar as informações necessárias, calcular e atualizar registros. Mesmo ao usar o LLM, as operações reais são realizadas por meio de ferramentas e sistemas conectados.
Definir o alcance das ações
O impacto é diferente para operações como apenas leitura e operações como envio, compra ou exclusão. Desenharemos as ferramentas que podem ser utilizadas, as operações que requerem aprovação, as formas de interrompê-las no meio do caminho e os registros de execução.
Por exemplo:Propor um compromisso ou confirmar uma reserva
Se simplesmente sugerir um possível horário por escrito, a sua reserva não será alterada. Depois de se conectar ao sistema de reservas e dar permissão para confirmar, eles poderão agir.
Cuidados
O alto desempenho de geração de texto por si só não garante que a tarefa que lhe foi confiada será concluída com segurança. Avalie todo o fluxo, incluindo ferramentas.
Em AI Inc.
Os privilégios de publicação e execução do modelo são decisões separadas. Mesmo em jogos, leia o escopo da avaliação, supervisão e condições de acidente antes de decidir sobre o escopo do comportamento aceitável.
Redes neurais e Transformer6
Do cálculo de números à escrita de frases. Fácil de entender com 6 ilustrações.
MODEL / MECHANISM
Do cálculo numérico,
até que se torne uma frase.
Primeiro, vamos passar para pequenos cálculos e depois passar para os mecanismos de processamento de sentenças. Siga o modelo invisível em 6 etapas.
Os cálculos são pequenos modelos para ilustração. As operações nesta página não alterarão o jogo nem salvarão conteúdos.
O que uma rede neural calcula?
Ele combina os valores de entrada com os pesos determinados pelo aprendizado e os converte em previsões por meio de camadas. Depois de entender um cálculo, você poderá entender como visualizar o modelo maior.
O que uma rede neural calcula?
Ele combina os valores de entrada com os pesos determinados pelo aprendizado e os converte em previsões por meio de camadas. Depois de entender um cálculo, você poderá entender como visualizar o modelo maior.
Ele combina os valores de entrada com os pesos determinados pelo aprendizado e os converte em previsões por meio de camadas. Depois de entender um cálculo, você poderá entender como visualizar o modelo maior.
Da entrada à previsão.
3 à esquerda, 4 no meio e 2 à direita. Este é um material didático tridimensional que combina números camada por camada.
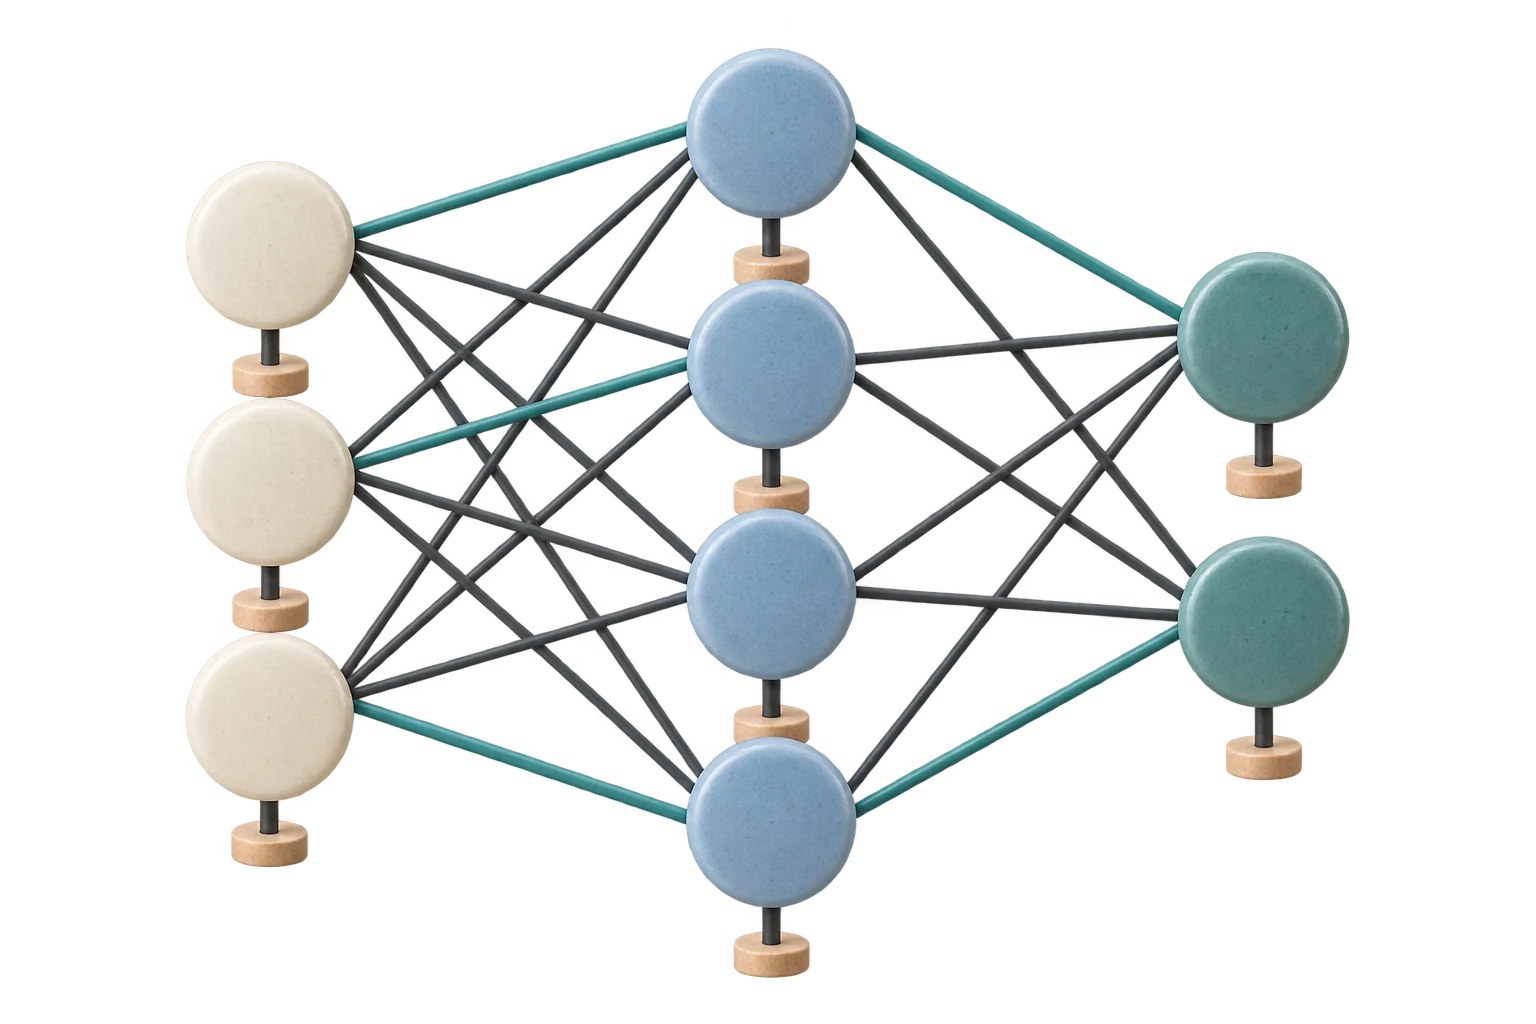
Esquerda: receber a entrada
Converta fotos, texto, etc. em números que o modelo possa manipular.
Centro: combinar e transformar
Pesos, vieses e funções de ativação transformam os valores na próxima representação.
Direita: converter em uma previsão
Crie resultados adequados ao trabalho. Mesmo nesta fase, as respostas corretas não são garantidas.
Primeiro, vamos seguir o cálculo de um nó usando o exemplo abaixo. Você também pode verificar os efeitos de pesos negativos e ReLU.
Esta é uma ilustração explicativa que mostra a disposição das camadas. O número, a cor e a espessura das linhas não indicam conexões ou pesos no modelo real.
Camada de entrada: representar informações com números
São fornecidos valores que o modelo pode processar: pixels em uma imagem ou representações de tokens em um texto, por exemplo. A preparação da entrada depende do tipo de dado.
Camada oculta: recombinar os valores
Cada nó multiplica os valores da camada anterior pelos pesos, soma os resultados e adiciona um viés. Aplica uma função de ativação ao resultado e o passa à próxima camada. As camadas entre a entrada e a saída são chamadas de camadas ocultas.
Pesos e vieses: valores ajustados durante o treinamento
O peso altera o efeito de cada entrada e, se for um valor negativo, funcionará na direção negativa. O viés muda o resultado da adição. Um único número não contém conhecimentos ou fatos específicos.
Funções de ativação: desde simples adições até relacionamentos complexos
ReLU transforma valores negativos em 0 e mantém sem alterações os valores iguais ou superiores a 0. Empilhar camadas que apenas multiplicam pelos pesos e somam continua sendo equivalente a um único cálculo do mesmo tipo. Inserir transformações não lineares entre elas permite representar relações complexas.
Camada de saída: adaptar o resultado à tarefa
Converta a expressão final em pontos de classificação, valores previstos, etc. Nem todos os números de nós são probabilidades. O exemplo abaixo também mostra os resultados calculados.
Experimente com um único nó
As entradas ficam fixas em 1 e 2. Como a soma e a saída mudam ao alterar os pesos ou o viés?
- 01 / Multiplicar e somar
1 × 0.6 + 2 × (−0.2) + 0.1
Multiplicar pelos pesos, somar e adicionar o viés.
- 02 / Aplicar ReLU
max(0, 0.3)
Se for negativo, é 0. Se for maior ou igual a 0, é passado como está.
Total 0.3→Saída 0.3
Experimente: ao mudar o peso 1 para −0,6, a soma é −0,9 e a saída é 0. Essa saída não é uma probabilidade nem uma taxa de acerto.
Por exemplo:Calcular um nó
Se as entradas forem 1 e 2, os pesos são 0,6 e -0,2 e o viés é 0,1, então 1 x 0,6 + 2 x (-0,2) + 0,1 = 0,3. Quando passado pelo ReLU, permanece 0,3. Vamos mover os pesos e verificar a saída quando a soma se tornar negativa.
Cuidados
O nome neurônio foi inspirado no cérebro. Estamos lidando aqui com cálculos numéricos, e não com uma reprodução direta de como o cérebro funciona.
O esquema explica as camadas de entrada, ocultas e de saída. As redes neurais também podem ter outras arquiteturas, como convoluções para imagens ou Transformer.
Em AI Inc.
Dados, design de modelo e recursos computacionais levam a razões relacionadas a resultados e custos de aprendizagem. Este botão de ajuste de ajuda serve para aprender como funciona e não altera o modelo do jogo nem salva.
Quais valores mudam ao aprender?
Meça a discrepância entre a previsão e a resposta correta e ajuste os pesos aos poucos para reduzir a discrepância. Vamos separar a leitura da resposta da atualização dos números no modelo.
Quais valores mudam ao aprender?
Meça a discrepância entre a previsão e a resposta correta e ajuste os pesos aos poucos para reduzir a discrepância. Vamos separar a leitura da resposta da atualização dos números no modelo.
Meça a discrepância entre a previsão e a resposta correta e ajuste os pesos aos poucos para reduzir a discrepância. Vamos separar a leitura da resposta da atualização dos números no modelo.
① Propagação direta: obter uma previsão
Calcule da entrada à saída usando os pesos atuais. Esta é a propagação direta. Nesta fase, não determinamos se esta está próxima da resposta correta ou não.
② Medir a perda: definir o erro conforme o objetivo
Compare a previsão e a verdade básica para aprender usando uma função de perda. O exemplo abaixo usa a diferença quadrada. Ao prever o próximo token em uma frase, escolha uma medida adequada ao trabalho, como a entropia cruzada, que usa a probabilidade atribuída ao token correto.
③ Voltar: calcular a direção da mudança
A retropropagação calcula como a perda muda ao variar ligeiramente cada peso. Essa sensibilidade é o gradiente. Percorre os cálculos da saída em direção à entrada e permite ajustar várias camadas.
④ Atualizar: decidir também o tamanho do passo
Atualize os pesos usando o gradiente e a taxa de aprendizagem. A taxa de aprendizagem é do tamanho de um passo. Se for muito grande, as perdas podem aumentar. Na verdade, repetimos com muitos exemplos e verificamos o desempenho mesmo com exemplos que não são utilizados para aprendizagem.
Atualizar o peso passo a passo
Fixado em 2 entradas, 1 resposta correta e taxa de aprendizagem de 0,1. É um modelo com apenas um peso: predição = 2 x peso, perda = (predição - 1)².
Atualizar 0·Previsão 0.2·Perda 0.64
Gradiente do exemplo = 4 × (2 × peso − 1)
Novo peso = peso atual - taxa de aprendizagem x gradiente
0.1 − 0.1 × (−3.2) = 0.42
Na primeira atualização, puxamos um gradiente negativo, então o peso aumenta.
| Número de atualizações | Peso | Previsão | Perda |
|---|---|---|---|
| 0 | 0.1 | 0.2 | 0.64 |
Este é um material didático adaptado a um único exemplo de aprendizagem. Em uma rede neural real, os gradientes de muitos pesos são determinados por retropropagação e a avaliação é realizada mesmo em dados que não são usados para aprendizagem.
Por exemplo:Aproximar a previsão 0,2 do valor correto 1
Se a entrada for 2 e o peso for 0,1, a previsão será 0,2. A perda é (0,2−1)²=0,64. Neste exemplo, se definirmos a taxa de aprendizagem como 0,1, os pesos após a primeira atualização serão 0,42, a previsão será 0,84 e a perda será 0,0256. Você pode acompanhar as alterações no mesmo exemplo, uma por uma, usando as operações abaixo.
Cuidados
O exemplo de cálculo é um modelo com apenas um peso e um exemplo de treinamento. Não reproduz retropropagação de toda a rede neural.
A redução da perda neste exemplo simples não garante treinar com sucesso um modelo grande nem responder corretamente a perguntas novas. Também é preciso observar o sobreajuste: melhorar apenas nos exemplos usados durante o treinamento.
Em AI Inc.
Isso leva ao motivo de separar a conclusão do estudo, o aprendizado real do modelo e a avaliação após a conclusão. Nos jogos, o próximo investimento é determinado comparando as previsões antes do aprendizado e os resultados após a conclusão.
Como as sentenças se tornam números?
Divida o texto em tokens e use IDs para transformá-los em sequências numéricas. Combinaremos essa expressão numérica com as informações circundantes.
Como as sentenças se tornam números?
Divida o texto em tokens e use IDs para transformá-los em sequências numéricas. Combinaremos essa expressão numérica com as informações circundantes.
Divida o texto em tokens e use IDs para transformá-los em sequências numéricas. Combinaremos essa expressão numérica com as informações circundantes.
Tokens e ID: definir as unidades
A tokenização divide o texto em pequenas unidades e atribui um ID a cada uma. ID é um número de identificação e seu tamanho não indica a força do significado da palavra. Eles nem sempre têm uma correspondência direta com palavras e caracteres japoneses.
Embedding: do ID a um vetor aprendido
O ID permite buscar um vetor na tabela de embeddings. Um vetor é uma sequência de valores numéricos. Seus componentes não têm necessariamente um significado interpretável, como “gentileza” ou “inteligência”.
Informação posicional: transmitir a ordem ao cálculo
Existe uma diferença entre “a empresa cria o modelo” e “o modelo cria a empresa”. O Transformer também usa informações de posição e distância relativa. A forma como é inserido varia dependendo do design.
Expressão no contexto: mudanças em combinação com o ambiente
Partindo do embedding inicial, cada camada combina a representação com as do entorno. Mesmo um único token muda sua representação intermediária conforme o contexto. Substituir os IDs não basta para completar a interpretação do texto.
De números de palavras a sequências numéricas
Veja os “modelos de empresa” na divisão hipotética. Usando o ID como pista, extraia o vetor da tabela incorporada.
Você pode ler a tabela movendo-a para a esquerda e para a direita.
| Posição | Token | ID | Embedding de três componentes |
|---|---|---|---|
| 1 | Empresa | 120 | [0.2, −0.4, 0.7] |
| 2 | o | 8 | [−0.1, 0.3, 0.2] |
| 3 | Modelo | 305 | [0.6, 0.1, −0.2] |
| 4 | o | 9 | [0.1, −0.2, 0.4] |
- Obter o embedding
Preparar a primeira representação numérica do token.
- Usar também informações de posição
Transmita a ordem das palavras e a distância aos cálculos de uma forma adequada ao design.
- Incorporar informações do contexto
A representação muda com o contexto em cada camada.
ID305 não é "mais significativo" que ID120. A divisão real, o número de dimensões e os valores numéricos variam dependendo do modelo e não há necessariamente um significado legível para cada componente do vetor.
Por exemplo:Ler “modelo” junto ao contexto
“Avaliar um modelo de IA” e “exibir um modelo arquitetônico” têm termos diferentes. A computação envolve incorporar informações circundantes na representação do token e lidar com o contexto em que ele é usado.
Cuidados
A divisão, ID e vetor de 3 componentes no diagrama são exemplos fictícios para explicação. O particionamento real, o número de dimensões e os números variam dependendo do modelo.
Em AI Inc.
Ao escolher o comprimento do contexto e o uso de dados, é útil considerar a quantidade de informações a serem tratadas e a carga computacional do uso dessas informações.
Quais componentes formam um Transformer?
Attention combina informações entre posições e Feed-Forward transforma a representação de cada posição. Essa arquitetura de rede neural empilha esses blocos.
Quais componentes formam um Transformer?
Attention combina informações entre posições e Feed-Forward transforma a representação de cada posição. Essa arquitetura de rede neural empilha esses blocos.
Attention combina informações entre posições e Feed-Forward transforma a representação de cada posição. Essa arquitetura de rede neural empilha esses blocos.
Combinar relações. Transformar representações.
De cima para baixo. O cartão representa um bloco de repetição e os dois quadros representam um bloco de repetição.
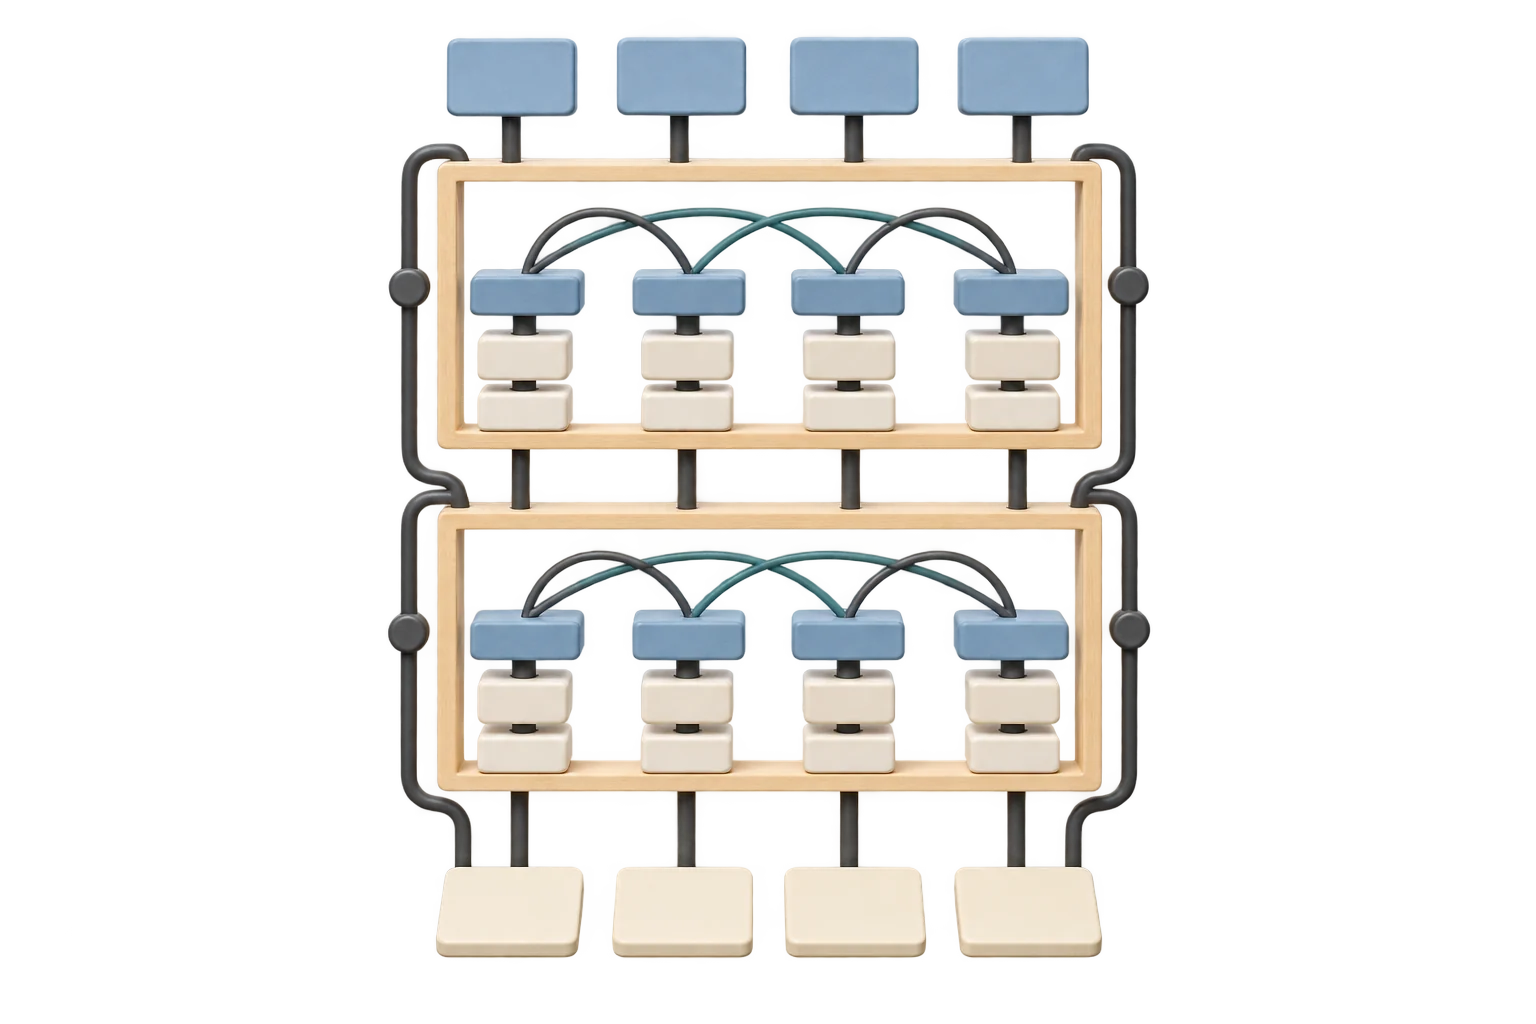
Cartões superiores: representação da entrada
Converta tokens em números e use também informações de localização.
Duas molduras: empilhar blocos
Misture as informações entre as posições e converta a representação de cada posição. O caminho lateral é uma metáfora que preserva a expressão original.
Cartões inferiores: representação processada
Na geração de frases, há uma parte que calcula pontuações e probabilidades de vocabulário.
Não é composto apenas por Attention. O diagrama abaixo explica a ordem exata das operações e a função de cada parte.
Esta é uma ilustração conceitual para aprender o tipo de decodificador. Os 2 blocos e 4 cartões são apenas para fins explicativos e não representam um modelo específico ou a estrutura geral do artigo original.
Attention: incorporar informações de outras posições
Calcule qual local e quanta informação importar. Um local remoto também é candidato. Na estrutura que gera frases, limite o intervalo de referências para evitar ver tokens futuros.
Feed-Forward: transformar cada posição com o mesmo cálculo
Após Attention, aplica-se uma transformação aprendida à representação de cada posição. Cada posição é processada com os mesmos parâmetros dentro de uma camada, incluindo transformações não lineares.
Conexão residual e normalização: suporte para empilhamento
Uma conexão residual é um caminho que adiciona a expressão original ao resultado recém-calculado. A normalização é um cálculo que ajusta a escala dos números. Combine-os para formar blocos. A localização da normalização, etc. varia dependendo do projeto.
Saída final: pontuações dos candidatos ao próximo token
Na geração, a representação da última posição é transformada em pontuações para todo o vocabulário; Softmax as converte em probabilidades. Desses candidatos é escolhido o próximo token. Os pesos de Attention e as probabilidades de saída são valores distintos.
Fluxo do tipo decodificador usado para geração de frases
Leia de cima para baixo. O cartão ilustrado corresponde à “expressão numérica” e o quadro corresponde ao “processamento repetido”.
- EntradaTokens → embeddings e informações posicionais
Converta frases em expressões que possam ser usadas em cálculos.
- Repetir blocos Transformer01 / Entre posiçõesMulti-Head Self-Attention
Oculta a localização futura e mistura informações sobre a localização que pode ser referenciada.
Também combina conexão residual e normalização02 / Em cada posiçãoFeed-Forward(FFN)A mesma camada utiliza os mesmos pesos e transforma a representação de cada posição de forma não linear.
Também combina conexão residual e normalizaçãoOs dois blocos da figura são apenas explicativos. O número real varia de acordo com o modelo.
- Parte que gera a saídaExpressão da posição final → Pontuação de vocabulário → Softmax
Calcule a probabilidade do próximo candidato a token consecutivo.
- GerarSelecione o próximo token e adicione ao contexto
Use o contexto adicionado para passar para o próximo candidato.
A conexão residual é um caminho que adiciona as expressões originais e a normalização é um cálculo que ajusta a escala dos números. Colocar a normalização antes ou depois de um componente depende do design. Este diagrama não descreve todo o codificador-decodificador no artigo original.
| Estrutura | Escopo e propósito da leitura |
|---|---|
| Encoder | Use antes e depois da entrada para criar expressões em frases. Usado para classificação e expressões de pesquisa. |
| Decoder | Gere a continuação usando as informações até cada posição. A configuração ilustrada aqui. |
| Encoder–Decoder | Combine o lado que lê a entrada e o lado que gera a saída. O artigo original trata dessa estrutura na tradução. |
Por exemplo:Entender a que “isso” se refere pelo contexto
Em “A empresa publicou um novo modelo. Ele pode resumir textos”, representar “ele” exige incorporar informações sobre “modelo”. Cada camada transforma novamente essa representação para gerar a próxima saída. O próximo artigo mostra um cálculo concreto de Attention.
Cuidados
A figura é um diagrama simplificado para a compreensão do modelo generativo do tipo Decodificador. Não é todo o codificador-decodificador do artigo original ou um diagrama de configuração de um produto específico.
Os dois blocos são apenas para fins ilustrativos. O número real de camadas, largura, função de ativação e informações de posição variam dependendo do modelo.
Em AI Inc.
Isto fornece uma base para considerar o design do modelo, os recursos computacionais necessários e o ônus do fornecimento. O nível de pesquisa e os valores de desempenho do jogo não são a composição real ou os valores de medição em si.
O que fazem Q, K e V em Self-Attention?
Crie um Q para buscar as informações que deseja importar, um K para verificar e um V para realmente importar as informações e misture os Vs de acordo com a força do relacionamento.
O que fazem Q, K e V em Self-Attention?
Crie um Q para buscar as informações que deseja importar, um K para verificar e um V para realmente importar as informações e misture os Vs de acordo com a força do relacionamento.
Crie um Q para buscar as informações que deseja importar, um K para verificar e um V para realmente importar as informações e misture os Vs de acordo com a força do relacionamento.
Attention: relações dentro do texto
As relações entre elementos distantes também são incluídas no cálculo.
A relação entre “isso” e “modelo”
A empresa lançou um novo modelo. Ele pode resumir textos.
um novo modeloeEle
Nesta frase, a relação entre “isso” e “modelo” é uma pista. As relações entre palavras distantes umas das outras também são levadas em consideração.
Exemplo para explicar relações entre palavras. Não mostra pesos de Attention medidos em um modelo real.
Calcular as relações da entrada
Self-Attention calcula o quanto os outros tokens da mesma entrada se relacionam com um token específico.
Criar representações conforme o contexto
Incorporamos essas relações em nossos cálculos e criamos representações sensíveis ao contexto por meio de múltiplas camadas.
Os papéis são uma metáfora dos elementos do texto. Tokens reais nem sempre coincidem com palavras. Attention é um método de cálculo, não uma consciência humana.
Esta é uma ilustração explicativa que foi substituída por uma mesa e materiais.
Q e K: criar representações para comparação
Altere a representação de cada posição para Q (Consulta), K (Chave) e V (Valor) usando a transformação aprendida. Calcule o produto escalar de Q e K e crie uma pontuação ajustada de acordo com o número de dimensões. Q é uma metáfora semelhante a uma consulta de pesquisa, mas não é uma pergunta no texto em si.
Softmax: de pontuações a proporções
Passe os pontos das posições referenciadas pelo Softmax e altere-os para pesos que somam 1. No exemplo do modelo generativo, primeiro mascaramos as posições futuras e atribuímos peso zero a elas.
V: ponderar e combinar informações
Multiplique cada V por seu peso de Attention e some os resultados. Não termina ao escolher uma palavra: combina informações de várias posições que podem ser consultadas.
Multi-Head: Use múltiplas transformações em paralelo
Cada Head com diferentes transformações aprendidas calcula o relacionamento e resume os resultados. As pessoas não decidem necessariamente o papel de cada cabeça e isso não significa necessariamente que se especializem em gramática ou pronomes. O exemplo abaixo possui apenas 1 Cabeça.
Calcular a distribuição com Q, K e V
Este é um exemplo hipotético de 3 posições, 2 componentes e 1 cabeça. Combine o Q do alvo com o K de cada posição e misture V com essa distribuição. Isso é independente do cálculo de escolha da próxima palavra do vocabulário.
Q da posição selecionada = [1, 1]
Pontuação = produto interno de Q e K ÷ √2
Você pode ler a tabela movendo-a para a esquerda e para a direita.
| Posição | K: para comparação | V: informações que serão combinadas | Pontuação |
|---|---|---|---|
| 1「Empresa」 | [1, 0] | [0.4, 0.1] | 0.707 |
| 2「Modelo」 | [1, 1] | [0.8, 0.6] | 1.414 |
| 3「isso」 | [0, 1] | [0.1, 0.2] | 0.707 |
Distribuição após Softmax: soma de 100%
- 1「Empresa」24.8%
- 2「Modelo」50.3%
- 3「isso」24.8%
Posição3「isso: resultado combinado [0.527, 0.377]。As posições futuras estão ocultas.
Resultado = 0.248 × [0.4, 0.1] + 0.503 × [0.8, 0.6] + 0.248 × [0.1, 0.2]
Cada V é multiplicado pela distribuição e adicionado para cada componente. Os valores exibidos são arredondados, portanto o total exibido pode divergir de 100%.
Experimente: ao escolher a posição 1 com a máscara causal ativada, apenas a posição 1 é usada, com peso de 100%. Ao retirar a máscara, posições posteriores também podem ser usadas. Os valores não foram medidos em um modelo real.
Por exemplo:Calcular valores fictícios para “isso”
No exemplo abaixo, preparamos 3 posições de Q, K e V e calculamos Softmax após dividir o produto interno do alvo Q e cada K por √2. Se você alterar o objeto para uma posição anterior, a posição futura será mascarada no modelo de exemplo gerado. Compare a distribuição exibida e os resultados mistos.
Cuidados
A divisão em tokens, Q, K, V e as pontuações são fictícias e ilustrativas. Não medem Attention em um modelo real nem demonstram que as relações semânticas foram aprendidas corretamente.
A distribuição de Attention muda conforme a entrada. Isso, por si só, não significa atualizar os parâmetros treinados.
Attention é o nome de um método de cálculo. Não significa consciência humana nem garante respostas corretas.
Em AI Inc.
Isso leva à razão pela qual a memória é usada em cálculos que lidam com contextos longos e inferências. Ao considerar o fornecimento ao cliente, analisamos em conjunto a qualidade do modelo e a carga de recursos.
Como um LLM continua um texto?
Aqui veremos a geração de sentenças autorregressivas. Calcula a probabilidade do próximo token do contexto passado, adiciona o token selecionado ao contexto e calcula o próximo.
Como um LLM continua um texto?
Aqui veremos a geração de sentenças autorregressivas. Calcula a probabilidade do próximo token do contexto passado, adiciona o token selecionado ao contexto e calcula o próximo.
Aqui veremos a geração de sentenças autorregressivas. Calcula a probabilidade do próximo token do contexto passado, adiciona o token selecionado ao contexto e calcula o próximo.
Não incluir na entrada o futuro ainda não gerado
Ao gerar, utiliza instruções e saída anterior. Mesmo ao processar sentenças com respostas corretas lado a lado durante o aprendizado, uma máscara causal é usada para evitar que cada posição veja futuras respostas corretas. Ser capaz de calcular múltiplas posições de aprendizagem em paralelo é uma coisa, e ser capaz de ver respostas futuras é outra.
Escolher conforme as probabilidades: nem sempre vence o candidato mais provável
Existem métodos para selecionar candidatos com alta probabilidade e métodos para selecionar candidatos com base na probabilidade. A saída irá variar dependendo do método de seleção e configurações como temperatura. Esta repetição não pode ser vista simplesmente dizendo que toda a resposta pode ser completada de uma só vez.
O token selecionado também se torna o próximo contexto.
Adicione o token gerado ao contexto e calcule o próximo candidato. Ele continua até atingir um token indicando término, um limite de saída, etc. Como a seleção é repetida, as diferenças na saída inicial também afetarão as sentenças subsequentes.
Adicionar a continuação escolhida à próxima entrada
Tanto a divisão quanto a probabilidade são fictícias. Para facilitar a visualização, aqui está um exemplo em que são selecionados candidatos com alta probabilidade.
- 01
- Contexto atual
- A IA
- Próximo candidato
- Pesquisa 60% · Aproveitamento 25% · Outros 15%
- Escolher
- Pesquisa
- Próximo contexto
- pesquisa em IA
- 02
- Contexto atual
- pesquisa em IA
- Próximo candidato
- 70% · 20% · Outros 10%
- Escolher
- o
- Próximo contexto
- a pesquisa em IA
- 03
- Contexto atual
- a pesquisa em IA
- Próximo candidato
- Adiantamento 55% · Apoio 30% · Outros 15%
- Escolher
- Avançar
- Próximo contexto
- impulsionar a pesquisa em IA
Na realidade, o método de seleção varia dependendo das configurações, como a loteria baseada na probabilidade. A probabilidade do próximo token não é a probabilidade de o conteúdo ser verdadeiro. A geração normal não atualiza os pesos aprendidos para cada resposta.
Por exemplo:Continuar “A IA” passo a passo
Para fins de explicação, o fluxo seria adicionar “pesquisa” a “IA”, adicionar “wo” a “pesquisa de IA” e então calcular o próximo candidato. Os candidatos e as probabilidades no diagrama são fictícios. As tokenizações e os candidatos reais irão variar dependendo do modelo e do contexto.
Cuidados
A probabilidade do próximo token não é a probabilidade de o conteúdo ser verdadeiro. Erros podem ocorrer mesmo em sentenças naturais, portanto compare-os com materiais e resultados de cálculo.
Na geração normal de frases, os pesos aprendidos não são atualizados cada vez que a resposta é dada. A aprendizagem adicional é um processo separado.
As implementações de inferência podem reutilizar cálculos existentes, como em caches KV. O diagrama mostra o fluxo de informações e não significa sempre recalcular tudo do zero.
Em AI Inc.
Na prestação de serviços aos clientes, são necessários recursos computacionais para que a inferência produza sentenças. Separamos os custos de aprendizagem para completar o modelo e os custos de fornecimento e uso continuado.
A pesquisa atual em IA10
Confirmado em 5 de outubro de 2026. Leia nove tendências de pesquisa, seus resultados e limitações de artigos acadêmicos recentes.
Data de confirmação · Escopo: dez artigos de maio a setembro de 2026
Desde a capacidade de formular respostas até a capacidade de realizar tarefas longas. Leia sobre as orientações de pesquisa de artigos recentes, incluindo como usar cálculos, a confiabilidade das evidências e o desenho da avaliação e da autoridade.
Como devo ler as últimas tendências de pesquisa?
Aqui, apresentaremos nove direções de 10 artigos publicados de maio a setembro de 2026. Os alvos incluem inferência, agentes, memória, eficiência, fala, modelos de mundo, confiabilidade, avaliação e design de autoridade.
Como devo ler as últimas tendências de pesquisa?
Aqui, apresentaremos nove direções de 10 artigos publicados de maio a setembro de 2026. Os alvos incluem inferência, agentes, memória, eficiência, fala, modelos de mundo, confiabilidade, avaliação e design de autoridade.
Aqui, apresentaremos nove direções de 10 artigos publicados de maio a setembro de 2026. Os alvos incluem inferência, agentes, memória, eficiência, fala, modelos de mundo, confiabilidade, avaliação e design de autoridade.
Revisar o que mudou e com o que foi comparado
Revise o modelo, os dados, o orçamento computacional e os critérios de avaliação. Os valores numéricos obtidos em artigos diferentes não podem ser classificados diretamente se as condições forem diferentes. Cada seção descreve o método e os resultados observados separadamente.
Publicação, aceitação e verificação são distintas
Preprints são manuscritos que podem ser publicados antes mesmo de serem revisados por pares em revistas acadêmicas ou conferências. Para trabalhos que foram aprovados em conferência, isso será indicado. A adoção ou pontuações altas por si só não confirmam a eficácia em todas as aplicações.
| Onde observar | O que verificar |
|---|---|
| Objeto | Modelo, idioma, dados e tarefas avaliados |
| Condições de comparação | Você comparou a quantidade de cálculo, número de tentativas e equipamentos? |
| Métrica | É uma resposta correta na primeira tentativa ou é a porcentagem de respostas corretas entre vários candidatos? |
| Reprodutibilidade | Você pode confirmar o método, código, dados e versão do artigo? |
| Limitações | Que condições não foram verificadas ou que verificações adicionais são necessárias? |
Por exemplo:Mesmo que a taxa de respostas corretas seja alta, o número de tentativas é diferente
A taxa de respostas corretas em uma única tentativa e a taxa de obtenção de pelo menos uma resposta correta ao criar vários candidatos não são as mesmas métricas. Verifique a atribuição, modelo, número de candidatos e orçamento de cálculo antes de ler os resultados. Um número alto por si só não significa que uma resposta seja mais certa.
Cuidados
Esta página contém explicações baseadas nos artigos selecionados. Não representa um consenso geral ou classificações atualizadas de produtos do mundo real. Também distinguimos entre resultados de pesquisa e implementação de jogos.
Raciocínio: não apenas mais cálculos, mas diferentes formas de pensar
Em pesquisas que geram muitos candidatos na hora de responder, o desafio é repetir os mesmos erros. O PTTS primeiro estabelece diferentes estratégias de solução e cria cada candidato de acordo com essa estratégia.
Raciocínio: não apenas mais cálculos, mas diferentes formas de pensar
Em pesquisas que geram muitos candidatos na hora de responder, o desafio é repetir os mesmos erros. O PTTS primeiro estabelece diferentes estratégias de solução e cria cada candidato de acordo com essa estratégia.
Em pesquisas que geram muitos candidatos na hora de responder, o desafio é repetir os mesmos erros. O PTTS primeiro estabelece diferentes estratégias de solução e cria cada candidato de acordo com essa estratégia.
Diversificar estratégias antes de gerar mais candidatos
Prepare primeiro várias políticas e crie candidatos de resposta com base em cada uma.
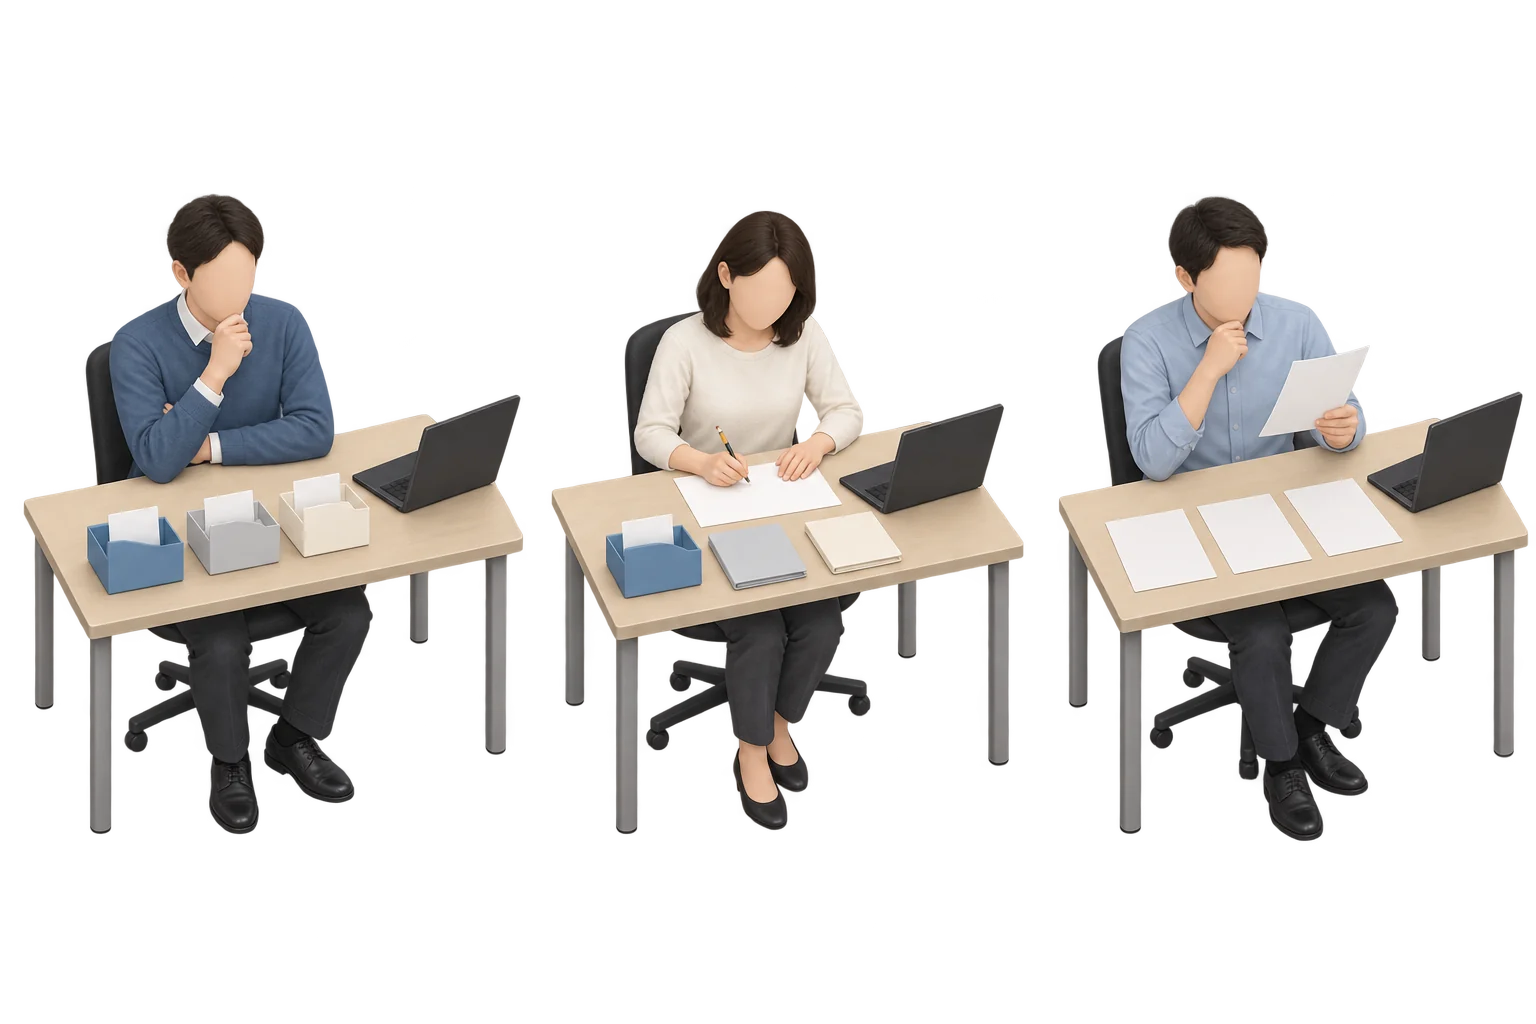
Esquerda: definir primeiro estratégias distintas
Planeje como você tentará resolver o mesmo problema. No PTTS, os decisores políticos consideram vários candidatos ao mesmo tempo e visam reduzir a concentração em ensaios semelhantes.
Centro: criar candidatos conforme cada estratégia
O executor cria candidatos a respostas usando o problema e cada estratégia. Preparar uma política e dar uma resposta concreta são duas funções diferentes.
Direita: medir se existe uma resposta correta
Avalie os candidatos a respostas e meça se pelo menos uma resposta está correta. Considere a inclusão da resposta correta e a possibilidade de selecioná-la e devolvê-la ao usuário.
pass@k é um indicador para ver se pelo menos uma resposta correta está incluída em k candidatos. Isso é diferente da taxa de respostas corretas por resposta ou da capacidade de selecionar a resposta correta.
Caixa de cartão, arquivo e papel são metáforas para explicação. A cor do contêiner representa a diferença na política, não na classificação do desempenho. O número de folhas de papel ou o número de pessoas não indica o número de tentativas ou modelos de um artigo. A situação à direita também não garante que a resposta correta seja selecionada automaticamente.
Como usar a computação após treinar o modelo
O método de usar computação adicional durante a inferência é chamado de escalonamento em tempo de teste. No PTTS, também estamos considerando maneiras de separar os criadores de políticas e os implementadores, e usar a aprendizagem por reforço para ajustar os criadores de políticas.
O que o artigo relata
Em cinco avaliações matemáticas usando os modelos 1.7B e 4B do Qwen3, relatamos que pass@64 melhora em relação à geração iterativa independente. Este é um indicador para verificar se pelo menos um dos 64 candidatos está correto.[R01]
Escopo dos resultados e desafios restantes
Ser capaz de selecionar com segurança a resposta correta entre vários candidatos e alcançar a mesma melhoria com uma única resposta são outros desafios. Você também precisa verificar os trabalhos não matemáticos, o tempo de espera e os custos dependendo da sua finalidade.
Por exemplo:Se apenas uma de quatro respostas estiver correta
Suponha que você crie quatro respostas candidatas para uma determinada pergunta e apenas uma esteja correta. Este problema conta como um sucesso no pass@4. Veja esta porcentagem de sucesso para vários problemas. Isso não significa que você obtenha a resposta correta 1 em cada 4 vezes, nem significa que você pode escolher definitivamente a resposta correta. Os exemplos de 4 candidatos são apenas para fins ilustrativos e não reproduzem o desempenho do artigo.
Em AI Inc.
Isto leva a decisões que olham não apenas para o desempenho da pesquisa, mas também para os recursos de inferência necessários para entregar aos clientes. Isso não significa que o PTTS possa ser configurado individualmente no jogo.
Agente: Das operações intermediárias à avaliação dos produtos concluídos
Mesmo que você possa pesquisar e usar ferramentas, isso não significa necessariamente que você pode terminar uma tarefa longa. KNOWS avalia o trabalho na web que coleta informações, as organiza e cria documentos e outros produtos.
Mesmo que você possa pesquisar e usar ferramentas, isso não significa necessariamente que você pode terminar uma tarefa longa. KNOWS avalia o trabalho na web que coleta informações, as organiza e cria documentos e outros produtos.
De operações intermediárias a resultados utilizáveis
A coleta de informações é seguida pela organização e confirmação do produto acabado.
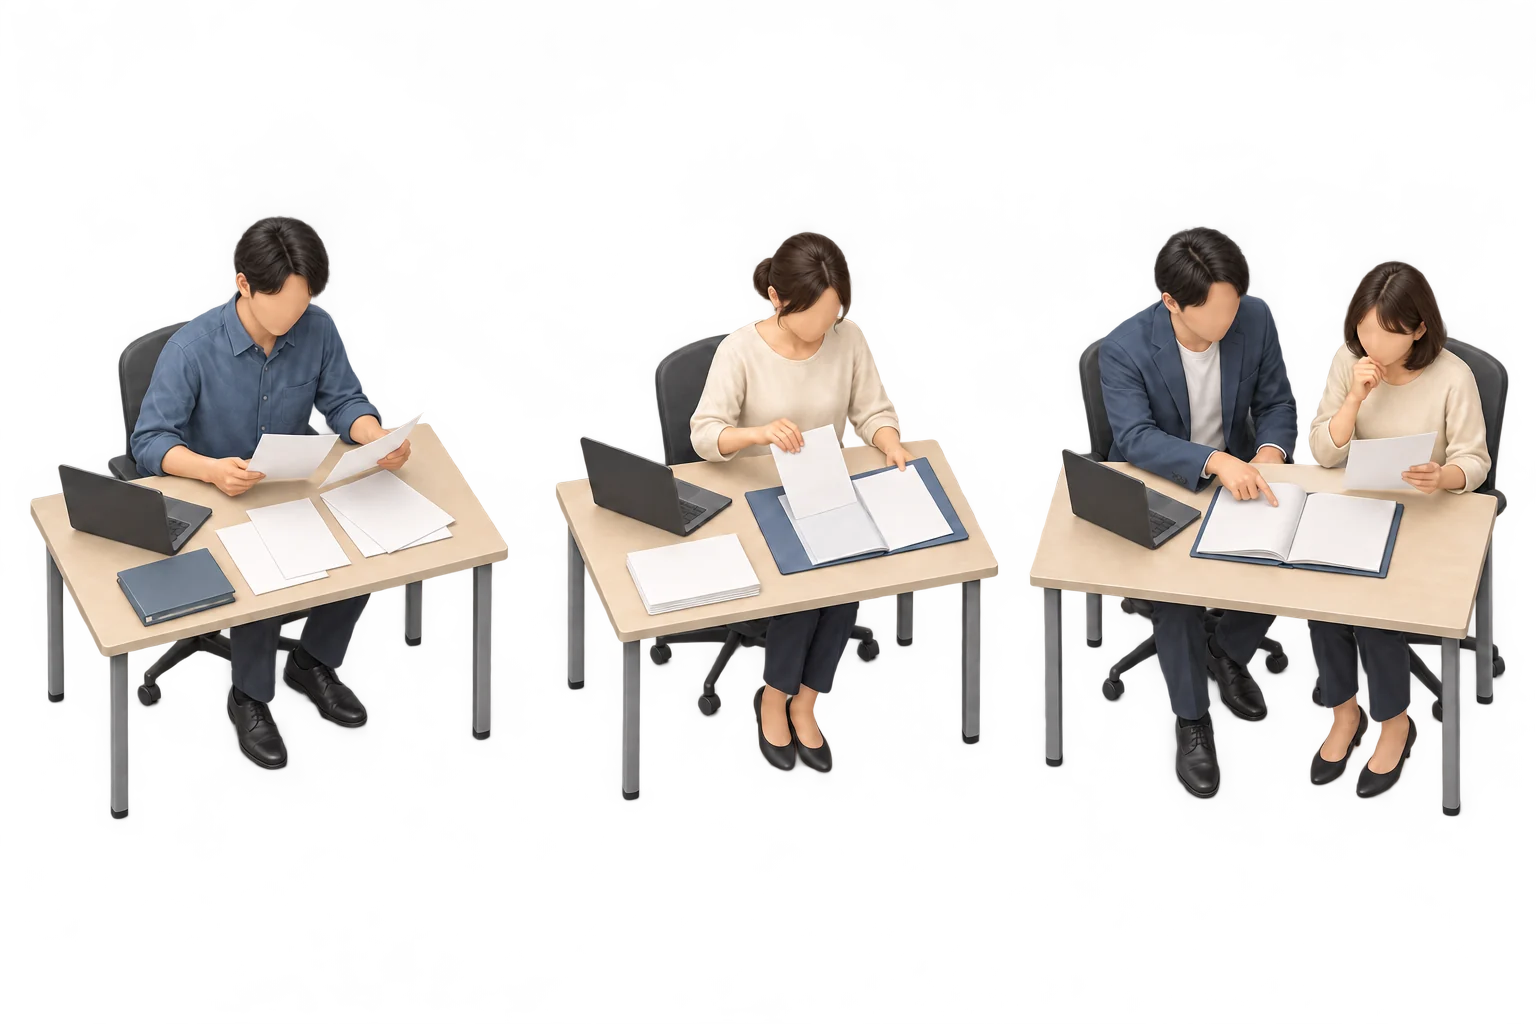
Esquerda: reunir as informações necessárias
Pesquisar e recuperar materiais faz parte do trabalho. Mesmo que a informação seja encontrada, isso não significa necessariamente que o trabalho solicitado foi concluído.
Centro: organizar e dar forma
Compare as informações coletadas e compile-as no formato solicitado, como documento, tabela ou slide. Não é apenas o conteúdo, mas também o layout e a estrutura.
Direita: comparar a entrega ao solicitado
Verifique se você possui as informações necessárias e se elas estão configuradas e exibidas conforme especificado. Avalie as operações intermediárias e os resultados finais utilizáveis separadamente.
“Consegui obter os materiais” e “Consegui atender a solicitação” são resultados diferentes. Se você verificar o produto completo, será mais fácil descobrir onde o processo parou.
Esta é uma ilustração explicativa que foi substituída pelo trabalho de mesa. Esta não é uma reprodução das telas reais do KNOWS ou das tarefas de avaliação, e a cena à direita não é uma representação que garanta o sucesso. Isto distingue-se do procedimento de fornecimento de jogos.
Também importa como as ferramentas são fornecidas
Mesmo com o mesmo modelo, os resultados irão variar dependendo da faixa de operação e do mecanismo da ferramenta. A orientação é medir separadamente se as operações intermediárias foram bem-sucedidas e se o produto acabado pode ser utilizado.
O que o artigo relata
Eles criaram 110 tarefas complexas e relataram que os melhores agentes que testaram tiveram uma taxa de sucesso total inferior a 3%. Há casos em que é possível fazer algum progresso, mas o resultado fica inutilizável devido a uma falha na operação visual.[R02]
Escopo dos resultados e desafios restantes
É um resultado do sistema no momento do desafio e da experiência específicos e não é uma taxa de sucesso para todos os agentes. Como utilizamos sites reais, as avaliações também são afetadas por alterações nas telas e nas informações.
Por exemplo:Mesmo que você possa pesquisar, os materiais de comparação não estão completos.
Considere uma solicitação para “investigar três candidatos e criar materiais comparativos com as fontes”. Mesmo que você consiga obter três informações, se as condições para comparação estiverem faltando ou as letras se sobrepuserem e não puderem ser lidas, a solicitação não poderá ser considerada completa. Verifique tanto a aquisição de informações quanto o produto acabado que pode ser utilizado. Este é um exemplo ilustrativo e não uma reprodução das tarefas individuais do artigo.
Em AI Inc.
Isso lhe dá um motivo para verificar o desempenho do seu modelo junto com os resultados de entrega que seus clientes realmente recebem. Vejamos também os resultados da oferta pós-publicação e da oferta antecipada.
Contexto longo: da retenção do texto completo ao design com memória
Para lidar com textos longos é necessário equilibrar a capacidade de referência à informação com a carga de cálculo e memória. A pesquisa ARMT incorpora memória associativa atualizada repetidamente no modelo.
Contexto longo: da retenção do texto completo ao design com memória
Para lidar com textos longos é necessário equilibrar a capacidade de referência à informação com a carga de cálculo e memória. A pesquisa ARMT incorpora memória associativa atualizada repetidamente no modelo.
Para lidar com textos longos é necessário equilibrar a capacidade de referência à informação com a carga de cálculo e memória. A pesquisa ARMT incorpora memória associativa atualizada repetidamente no modelo.
Processar textos longos com segmentos e memória
As informações obtidas na seção anterior são transportadas para a próxima seção.
Esquerda: ler parte da entrada
ARMT divide entradas longas em segmentos e os processa em ordem. Dentro de cada segmento, usa as informações daquele trecho.
Centro: atualizar a memória interna
Ele usa representações do que leu para atualizar a memória associativa dentro do modelo. O titular do cartão é uma metáfora de como funciona.
Direita: usar no próximo bloco
Ao processar a próxima entrada, também consulta a memória recebida do segmento anterior. Repete esse processo para lidar com textos longos.
Existe uma diferença entre reter o texto inteiro e passar a informação para a memória interna. Verifique também o comprimento máximo e a capacidade de usar as informações necessárias corretamente.
Os materiais e porta-cartões são metáforas ilustrativas e não um diagrama da estrutura interna do papel. A memória real é expressa numericamente e é diferente de um resumo de um texto ou de uma preservação completa do texto original. Não indica a capacidade do aplicativo de salvar conversas permanentemente ou a implementação do jogo.
Ler por blocos e transmitir a memória interna
ARMT divide a entrada em segmentos, processa cada um em ordem e atualiza uma memória associativa a cada segmento. Ao processar o próximo, também consulta essa memória. Ela é representada por valores internos do modelo: não equivale a guardar todo o texto original nem a manter um resumo escrito.
Não apenas o limite máximo de comprimento, mas se ele pode realmente ser usado?
Esta pesquisa considera o aprendizado adicional para acomodar entradas longas e a seleção de camadas que incorporam memória. Distinguir entre extensão de informação e capacidade de responder corretamente usando informações distantes.
O que o artigo relata
Criamos dados de texto longo para cada campo e avaliamos a entrada que excede o limite superior do contexto do modelo original e a entrada que é mais longa do que durante o treinamento. Mesmo dentro do intervalo de comprimento original, reportamos resultados que reduzem a quantidade de cálculo, mantendo o desempenho.[R03]
Escopo dos resultados e desafios restantes
O alvo experimental é um modelo relativamente pequeno com parâmetros máximos de 1B. Não é possível julgar apenas com base neste resultado se o mesmo efeito pode ser obtido num modelo maior ou num campo diferente.
Por exemplo:Conectando a primeira metade e a segunda metade de um longo relatório
Considere um relatório que inclua as condições do plano no primeiro semestre e os resultados no segundo semestre. Ao ler a segunda metade, se você puder usar as informações transportadas da seção anterior, poderá processá-las com base em ambas. No entanto, é necessário avaliar se todas as condições podem ser transportadas com precisão. Este é um exemplo de como utilizá-lo, e o artigo não garante o sucesso deste relatório.
Em AI Inc.
Isto irá ajudá-lo a pensar sobre a diferença entre pesquisas que apenas melhoram o desempenho e pesquisas que fazem o mesmo trabalho com menos recursos. Ele não converte a escala do modelo de jogo ou os valores dos recursos nos valores do papel.
Eficiência: propor candidatos e verificá-los juntos
A decodificação especulativa é um método de criação de futuros candidatos a tokens usando cálculos leves e verificando-os com o modelo de destino. Pesquisas recentes melhoraram o cronograma de processamento de cada solicitação e o aprendizado dos modelos geradores de candidatos.
A decodificação especulativa é um método de criação de futuros candidatos a tokens usando cálculos leves e verificando-os com o modelo de destino. Pesquisas recentes melhoraram o cronograma de processamento de cada solicitação e o aprendizado dos modelos geradores de candidatos.
Criar candidatos e verificar quais são aceitos
Combina criação e validação de candidatos para gerar uma continuação da resposta.
Esquerda: propor continuações
Crie vários candidatos a token primeiro com cálculos leves. ASPIRE cria candidatos restringindo os contextos referenciados pelo mesmo modelo.
Centro: validar com o modelo-alvo
O ASPIRE valida os candidatos em conjunto por meio de cálculos que se referem a todo o contexto. Veja até onde você pode aceitar desde o início.
Direita: adicionar a continuação aceita
Adicione a primeira parte aceita e o próximo token determinado pelo verificador. Removeremos os demais candidatos que não foram aceitos e criaremos outro candidato.
A verificação aqui é o processo de verificar se corresponde à geração do modelo alvo. Esta não é uma tarefa para verificar se o conteúdo é factual. A eficiência varia dependendo da gama de candidatos aceitos e das condições de processamento.
Um pedaço de papel é uma metáfora para um token e não corresponde necessariamente a uma palavra. As três cenas representam etapas de processamento e as diferenças nos números não indicam a quantidade de modelos. Este diagrama não reproduz o processamento assíncrono, a estrutura interna ou as operações do jogo do ASPIRE.
A verificação é diferente da verificação de fatos
Este processo verifica se corresponde à geração do modelo alvo e adota a parte inicial aceitável. ASPIRE usa o mesmo modelo para gerar candidatos em alguns contextos e depois os valida usando todos os contextos. Outra opção é usar um modelo diferente e mais leve. Mesmo que o texto tenha passado na verificação, verificaremos separadamente o suporte factual.
Melhorar a coordenação e a qualidade dos candidatos
ASPIRE permite múltiplas solicitações para criar e verificar candidatos em momentos diferentes. Outra pesquisa visa recuperar sinais de treinamento que foram desperdiçados em dados de treinamento existentes, facilitando a criação de candidatos que passem na verificação.
O que o artigo relata
ASPIRE relata melhorias de decodificação de rendimento em relação à geração sequencial regular em três modelos e cinco avaliações. Os estudos de aprendizagem de modelos de candidatos também relatam melhorias no comprimento dos candidatos aceitos para validação.[R04][R05]
Escopo dos resultados e desafios restantes
A taxa de melhoria no rendimento não pode ser traduzida diretamente na taxa de melhoria no tempo de espera por uma única resposta ou na taxa de utilização. Você precisa ler as condições como modelo, equipamento, número de processamento simultâneo, taxa de aceitação de candidatos, método de geração, etc.
Por exemplo:Se você escolher os dois primeiros de quatro candidatos
Suponha que sejam propostos 4 tokens e a verificação aceite os 2 primeiros. São adicionados esses 2 e o próximo token determinado pelo verificador; os candidatos restantes são descartados. Às vezes é preciso gerar todos os candidatos novamente. Os números 4 e 2 são ilustrativos e não representam uma configuração fixa nem o desempenho do artigo.
Em AI Inc.
Para resolver uma falta de capacidade, você pode ampliar a infraestrutura ou melhorar a eficiência. A aceleração descrita no artigo não se traduz diretamente na capacidade do jogo.
Multimodal: você está usando evidências sólidas antes de pensar?
Mesmo a IA que recebe áudio pode responder usando pistas do texto em vez de usar informações reais de áudio. O PG-TTRL considera a aprendizagem por reforço durante a inferência com ênfase no uso de evidências sólidas.
Multimodal: você está usando evidências sólidas antes de pensar?
Mesmo a IA que recebe áudio pode responder usando pistas do texto em vez de usar informações reais de áudio. O PG-TTRL considera a aprendizagem por reforço durante a inferência com ênfase no uso de evidências sólidas.
Mesmo a IA que recebe áudio pode responder usando pistas do texto em vez de usar informações reais de áudio. O PG-TTRL considera a aprendizagem por reforço durante a inferência com ênfase no uso de evidências sólidas.
Lendo perguntas e baseando-as em sons
Mesmo que a pergunta seja a mesma, a resposta mudará dependendo do som que você realmente ouve.
Esquerda: responder apenas com pistas do texto
É quando você faz inferências com base no texto da pergunta ou nas respostas comuns. Mesmo que você possa inserir sua voz, isso não garante que suas respostas serão baseadas em sons reais.
Direita: usar também evidências do som
Use as características das vozes e dos sons que você ouve em conjunto com as perguntas. A investigação irá comparar as condições em que as pessoas podem referir-se a informações sólidas com as condições em que estas são restritas e examinar o quanto isso afecta as respostas.
Certificamo-nos de que respondemos às informações, construímos as informações e chegamos à resposta correta. Mesmo que a resposta dependa do som, não é necessariamente a resposta correta.
Os fones de ouvido são uma metáfora para a diferença no uso de informações sonoras. No artigo, a comparação é feita com referência limitada às informações de áudio internas, e o diagrama não reproduz a operação de retirada dos fones de ouvido. Não indica o procedimento de aprendizagem do PG-TTRL ou o funcionamento do jogo.
Respondendo às entradas e baseando-as nas entradas
Este estudo analisa o quanto o modelo depende do som para fazer inferências e incorpora essas informações na avaliação da aprendizagem. Apenas pensar em frases por muito tempo não resolverá necessariamente seus problemas de audição.
O que o artigo relata
Nós o avaliamos usando dois modelos de linguagem falada e dois benchmarks de inferência de fala, MMAR e MMAU, e relatamos melhorias em relação ao modelo base e aprendizagem por reforço regular para inferência.[R06]
Escopo dos resultados e desafios restantes
Esta é uma técnica de pesquisa que realmente atualiza o modelo. Esta não é uma explicação de que o bate-papo normal aprenderá automaticamente informações adicionais. Não indica o efeito em todos os sons, idiomas, imagens e vídeos.
Por exemplo:A mesma pergunta com sons diferentes
Pense em uma situação em que você pergunte à criança: “Que sons você ouve?” e dê-lhes o som da chuva e o som dos aplausos. Embora as perguntas tenham o mesmo texto, a resposta requer uma diferença sonora real. Este exemplo é apenas para fins ilustrativos e não é uma tarefa de ensaio separada. O artigo examina a influência do som nas respostas comparando condições que restringem a referência interna à informação de áudio com condições normais.
Em AI Inc.
Não julgue a aplicação apenas com base no nome do mercado; isso o ajudará a pensar nas condições de entrada e avaliação que seus clientes precisarão. Por favor, distinga entre os métodos de aprendizagem utilizados na pesquisa e as operações dos jogos.
Modelos mundiais: Da previsão do próximo passo à estabilidade na evolução a longo prazo
Um modelo mundial é um modelo para prever o estado do meio ambiente e os resultados das ações. Mesmo que você consiga prever com precisão o próximo passo, repetir suas previsões ao longo do tempo pode desviar-se da realidade.
Um modelo mundial é um modelo para prever o estado do meio ambiente e os resultados das ações. Mesmo que você consiga prever com precisão o próximo passo, repetir suas previsões ao longo do tempo pode desviar-se da realidade.
Prever o próximo passo e repetir
Use o estado previsto como a próxima entrada para criar uma longa expansão.
Esquerda: considerar estado e ação atuais
Se for um modelo de carro, as pistas são sua posição e orientação atuais e como movê-lo. Os modelos mundiais prevêem o próximo estado com base em estados e ações.
Centro: prever novamente a partir do previsto
Use o estado previsto como a próxima entrada para prosseguir. Essa previsão repetida é chamada de implementação.
Direita: observar a distribuição após muitas repetições
Estuda-se quais estados aparecem, com que frequência e com que dispersão: essa é a distribuição dos estados. Uma previsão precisa de um passo não garante conservar essas propriedades no longo prazo.
A precisão de um passo, a distribuição de longo prazo e a utilidade de um plano são avaliações distintas. Uma distribuição estável não garante que cada previsão ou plano de ação esteja correto.
O carro-modelo e a prancha são metáforas ilustrativas e não representam o problema de controle no papel ou a distribuição dentro do modelo. Só porque o carro está dentro da prancha não prova estabilidade. Os vários carros representam uma cena em que pensamos sobre o estado futuro, e não mostram previsões exatas ou como a AI Inc. opera a cidade.
Medir o comportamento ao repetir previsões
Neste estudo, projetamos o modelo para manter uma distribuição constante de estados internos e investigamos a estabilidade de implantações longas. A ideia é avaliar a precisão das previsões curtas, a distribuição das expansões longas e a eficácia do planejamento separadamente.
O que o artigo relata
Em 12 tarefas de controle, relatamos resultados que mantêm a distribuição avaliada mesmo após longas repetições de predição. Por outro lado, outros modelos comparados também apresentam resultados superiores em termos de precisão de previsão de curto alcance.[R07]
Escopo dos resultados e desafios restantes
Depende das condições teóricas e da variedade de ambientes e comportamentos aprendidos. Só porque a distribuição é estável não significa que possamos reproduzir com precisão o mundo real ou criar um bom plano de acção.
Por exemplo:O próximo estado do modelo de carro e seu longo desenvolvimento
Prevê-se o próximo estado de um carrinho a partir de sua posição, orientação e movimento atuais. Usar novamente essa previsão como entrada permite simular o futuro sem mover fisicamente o carrinho a cada vez. Mas acertar aproximadamente um passo não garante conservar a distribuição dos estados após muitas repetições. Em previsões longas, trajetórias diferentes podem manter uma distribuição semelhante; não basta comparar posições. O carrinho serve apenas como ilustração e não reproduz as tarefas experimentais do artigo.
Em AI Inc.
Isso leva a uma forma de pensar que separa as previsões de curto prazo dos resultados de negócios de longo prazo. Isto não significa que as simulações de cidade e gestão da AI Inc. sejam executadas neste modelo mundial.
Confiabilidade: Descubra por que você não apenas sabe, mas também por que está errado mesmo quando sabe
Respostas incorretas não ocorrem apenas quando você não tem o conhecimento necessário. Este estudo examina como as palavras em uma pergunta e as conexões aprendidas competem entre si, levando à escolha de respostas incorretas.
Respostas incorretas não ocorrem apenas quando você não tem o conhecimento necessário. Este estudo examina como as palavras em uma pergunta e as conexões aprendidas competem entre si, levando à escolha de respostas incorretas.
Remova algumas perguntas e compare as alterações nas respostas
Mesmo que você tenha o conhecimento, o texto da pergunta e as conexões que você fez com seu aprendizado podem entrar em conflito.
Separar o que muda do que é preservado
Premissa ilustrativa: A pessoa A é pianista, a pessoa B é pintora. Suponha que ambos moremos em Tóquio.
- Pergunta original
- Quem é o pianista que mora em Tóquio?
- Pergunta sem as informações compartilhadas
- Quem é pianista?
Partindo deste pressuposto, a resposta a ambas as perguntas é a Pessoa A. Mesmo que remova informações sobre locais que são comuns a ambas as pessoas, o alvo da pergunta não mudará. A pesquisa examinará as mudanças nas respostas e o grau em que os candidatos provavelmente serão selecionados quando as palavras de entrada forem alteradas.
A explicação usa uma pessoa fictícia e não indica as perguntas individuais do artigo, as respostas reais ou as probabilidades internas. Só porque a resposta mudou não confirma que seja uma resposta errada.
Esquerda: medir o efeito de palavras na pergunta original
Após obter a resposta original, examinamos quais palavras têm forte influência na probabilidade de uma possível resposta ser selecionada. O pedaço de papel azul é uma metáfora para parte da questão.
Centro: retirar palavras e verificar novamente
Remova as partes mais influentes e reexamine a influência das palavras restantes. Esta é uma comparação baseada na intervenção de entrada e não numa operação de reaprendizagem.
Direita: comparar a mudança de apoio aos candidatos
Mudanças na probabilidade de respostas e candidatos são usadas como pistas para encontrar respostas incorretas. Mesmo que a resposta esteja correta, o resultado pode mudar se palavras importantes forem omitidas.
Só porque uma palavra tem um grande impacto não significa que seja uma resposta incorreta. Existem outras causas também, como a falta de conhecimento. Não é um método que lhe dará a resposta correta se você omitir as palavras.
A representação da remoção do pedaço de papel é uma metáfora que altera a formulação da pergunta. Este não é um diagrama que reproduz diretamente a intervenção interna ou o cálculo em duas etapas realizado no artigo. Não representa as respostas, probabilidades, sucessos de detecção ou operações reais da AI Inc.
Mude parte da pergunta e veja a resposta mudar
Observe as mudanças na saída removendo palavras-chave que tenham um forte impacto. A direção é separar e examinar a falta de conhecimento, o conhecimento incorreto, a interferência devido ao contexto e o raciocínio instável.
O que o artigo relata
Relatamos resultados nos quais a alteração de palavras-chave pode ser usada como uma pista para detectar respostas incorretas em vários modelos e tarefas. No entanto, também mostra que as combinações com outros sinais de detecção nem sempre melhoram.[R08]
Escopo dos resultados e desafios restantes
Os métodos principais usam, entre outros dados, as probabilidades dos tokens e foram projetados para facilitar a aplicação a modelos com pesos abertos. Ainda não foi verificado se oferecem detecção equivalente em serviços sem acesso a informações internas nem se explicam o mecanismo de todas as respostas incorretas.
Por exemplo:A localização compartilhada e a característica que distingue a pessoa
No exemplo de frase mostrado na figura, mesmo que você retire a palavra “Tóquio” que é comum a ambas as pessoas, a condição para perguntar sobre o pianista permanece. Por outro lado, se você remover “pianista” e usar “Quem mora em Tóquio?”, ambas as pessoas corresponderão e o significado da pergunta mudará. Você precisa ler as alterações nos resultados junto com as informações que foram alteradas. Este exemplo não é uma pergunta de um artigo de pesquisa ou uma medição real das respostas do modelo.
Em AI Inc.
Isto leva à razão para ler especificamente o escopo da avaliação. Não trate o desempenho de uma única detecção de resposta falsa como uma garantia da segurança de todo o modelo.
Avaliação: Examine não apenas a pontuação, mas também o sistema de pontuação
As avaliações que permitem que os agentes mudem seu ambiente de trabalho podem afetar as pontuações sem concluir a tarefa. O BenchShield verifica a integridade da recompensa no ambiente de avaliação e nos registros de execução.
As avaliações que permitem que os agentes mudem seu ambiente de trabalho podem afetar as pontuações sem concluir a tarefa. O BenchShield verifica a integridade da recompensa no ambiente de avaliação e nos registros de execução.
Veja os resultados da avaliação e a base para pontuação
Além de ver quantos pontos você recebeu, verifique quais entregas e insumos foram avaliados.
Esquerda: revisar a última avaliação
A pontuação final é um guia para comparação de resultados. No entanto, a pontuação por si só não indica se a pontuação foi obtida ao completar a tarefa ou se houve outras alterações que afetaram a pontuação.
Direita: acompanhar entregas, entradas de avaliação e registros
Veja quais artefatos e valores foram pontuados e o que mudou ao longo do caminho. O BenchShield utiliza evidências da infraestrutura de avaliação para vincular as operações reais ao impacto da avaliação.
Resolver uma tarefa é uma coisa, mas influenciar a pontuação medida é outra. Também analisamos as provas para distinguir entre a existência de uma lacuna e o facto de ter sido utilizada durante a execução.
O papel e a pasta são uma metáfora ilustrativa e não representam a tela de avaliação real ou o procedimento de trapaça. O lado esquerdo nem sempre significa uma avaliação falsa e o lado direito nem sempre significa uma detecção bem-sucedida. O BenchShield requer medição da plataforma de avaliação e não é um método que possa ser reproduzido apenas comparando papel.
Descubra por que você obteve uma pontuação alta
Examine os resultados, as informações usadas para classificação e o processo de classificação. Este estudo distingue entre completar tarefas corretamente e hackear recompensas que usam lacunas de avaliação.
O que o artigo relata
Verificamos as três plataformas de avaliação de agentes usando uma combinação de inspeção estática e registros de tempo de execução. Também comparamos um método que analisa apenas registros de conversas e um método que usa evidências do lado da fundação.[R09]
Escopo dos resultados e desafios restantes
É necessário incorporar a medição no ambiente de avaliação, e não é um método que possa ser utilizado como é em todos os ambientes. A expansão do design é necessária para tarefas com diferentes processos de pontuação e exploração livre.
Por exemplo:E se eu obtiver uma classificação alta mesmo que a tabela de resumo não esteja completa?
Digamos que você receba uma solicitação para “criar uma tabela que agregue três valores”, e a tabela que não possui as linhas necessárias receba uma classificação alta. Além de consultar as tabelas, veja quais dados foram usados para pontuação e o que foi alterado ao longo do caminho. Os resultados em falta, os erros de pontuação e as alterações nas informações utilizadas para avaliação devem ser identificados através da análise das evidências. Este é um exemplo ilustrativo e não representa uma tarefa específica em papel ou fraude real.
Em AI Inc.
Isto leva à ideia de verificar em que condições foram obtidos valores de avaliação elevados. Na determinação da divulgação/autoridade, o âmbito da avaliação e as condições de supervisão necessárias são lidos em conjunto.
Design de autoridade: a diferença entre trabalhar bem-sucedido e não operar mais do que o necessário
Mesmo se você escolher uma ferramenta conveniente, ela poderá exceder o escopo exigido para a solicitação. O FORTIS avalia habilidades e seleção de ferramentas para proteger privilégios mínimos.
Design de autoridade: a diferença entre trabalhar bem-sucedido e não operar mais do que o necessário
Mesmo se você escolher uma ferramenta conveniente, ela poderá exceder o escopo exigido para a solicitação. O FORTIS avalia habilidades e seleção de ferramentas para proteger privilégios mínimos.
Mesmo se você escolher uma ferramenta conveniente, ela poderá exceder o escopo exigido para a solicitação. O FORTIS avalia habilidades e seleção de ferramentas para proteger privilégios mínimos.
Permissões necessárias versus permissões excessivas
Mesmo que você possa atender à mesma solicitação, a gama de ferramentas que podem ser utilizadas é diferente.
Esquerda: ler apenas o documento-alvo
Se for solicitado que você "me conte a essência deste arquivo", considere se você pode satisfazer a solicitação lendo o destino. A permissão para modificar outro arquivo não é necessária para esta solicitação.
Direita: também pode modificar outros documentos
Mesmo que você consiga ler o mesmo material, as ferramentas que podem alterar ou excluir outros arquivos têm um escopo mais amplo. Verifique se você está escolhendo mais privilégios do que o necessário apenas por causa de uma explicação conveniente.
A capacidade de completar a tarefa e a capacidade de escolher ferramentas que atendam às necessidades são outros critérios de avaliação. Revise as habilidades que você escolheu e as ferramentas que usará nelas.
Arquivos e ferramentas de escritório são metáforas do escopo da autoridade. A cena à direita é um estado onde uma ampla gama de operações pode ser executada e não é a cena que é realmente alterada ou excluída. O FORTIS avalia seleções em hierarquias de habilidades configuradas e não representa operações que ocorrem em serviços do mundo real.
Você escolhe autoridade excessiva mesmo para solicitações rotineiras?
Examinaremos se as escolhas mudam não apenas com instruções agressivas, mas também com pedidos vagos e explicações que enfatizam a conveniência. Além da taxa de sucesso do modelo, também mede se o modelo está dentro da faixa de operações exigida.
O que o artigo relata
Relatamos um problema em que habilidades e ferramentas com permissões mais amplas do que o necessário são selecionadas em três áreas: e-mail, pedidos por correspondência e operações de arquivos. Isso mostra um eixo de avaliação diferente de se o trabalho pode ser concluído.[R10]
Escopo dos resultados e desafios restantes
Este é um estudo que avalia escolhas usando uma hierarquia de habilidades construída artificialmente. Não inclui os resultados da execução das ferramentas em serviços externos reais ou da validação em relação ao histórico natural do usuário.
Por exemplo:O que é necessário para resumir um arquivo
Suponha que você tenha uma ferramenta que possa ler o arquivo de destino e uma ferramenta que possa editar/excluir a pasta inteira. Se ambos puderem ler o arquivo, a capacidade de concluir a tarefa não será suficiente para julgar se você escolheu as permissões apropriadas. Confirme separadamente o alvo e o escopo das operações necessárias para a solicitação. Este não é um exemplo que mostra a tela de configurações de serviço real ou atribuições individuais para um artigo.
Em AI Inc.
Mesmo para modelos publicados, há um julgamento separado sobre quanto comportamento é permitido. Verifique os privilégios de execução e a supervisão separadamente do desempenho do modelo.
Bibliografia10resultados
Links diretamente para o original. A data é a data da primeira publicação/versão de referência do arXiv (UTC).
- [R01]
Planned Test-Time Scaling with Coordinated Reasoning Paths
- [R02]
The Hard Part Comes After Search: Benchmarking Web Agents on Synthesizing, Organizing, and Displaying Knowledge
- [R03]
Extending LLM Context via Associative Recurrent Memory
- [R04]
ASPIRE: Asynchronous Batched Self-Speculative Decoding for Long-Context LLM Inference
- [R05]
Recovering Off-Policy Supervision for Speculative Decoding
- [R06]
Listen Then Reason: Perception-Grounded Test-Time Reinforcement Learning for Large Audio-Language Models
- [R07]
World Models with Predictable Long-Horizon Marginals
- [R08]
When the Wrong Key Wins: Understanding and Detecting Hallucinations in LLMs
- [R09]
BenchShield: Formal Model-Backed Instrumentation for Reward Integrity in LLM-Agent Evaluation Infrastructure
- [R10]
FORTIS: Benchmarking Over-Privilege in Agent Skills
Glossário35
Uma breve explicação dos termos básicos da IA e das palavras usadas para ler artigos.
- Rede neural
- Um mecanismo de modelo que combina valores numéricos de entrada com pesos e transformações aprendidos e os converte em previsões.
- Camada oculta
- Uma camada entre a entrada e a saída de uma rede neural. Converte a representação da camada anterior e passa para a próxima.
- Pesos e vieses
- Valor numérico a ser ajustado durante o aprendizado. O peso altera o efeito da entrada e o viés altera o desvio do resultado somado.
- Função de ativação
- Uma função que transforma o resultado do cálculo de um nó. Transformações não lineares como ReLU são usadas para lidar com relacionamentos complexos.
- Perda
- Um valor que mede a discrepância entre a previsão e as metas de aprendizagem usando um método adequado ao propósito. Distinga-o do desempenho em exemplos desconhecidos.
- Retropropagação
- Um método para acompanhar o cálculo do lado da saída e encontrar a inclinação ao alterar a perda com cada parâmetro.
- Taxa de aprendizado
- Tamanho da etapa para atualizar os parâmetros. Torná-lo maior não significa necessariamente que melhorará mais rapidamente.
- Self-Attention
- Um mecanismo que calcula a distribuição do relacionamento a partir da expressão de cada posição na mesma coluna e mistura as informações de valor com os pesos.
- Máscara causal
- Uma restrição que impede referências a tokens futuros de cada posição numa construção geradora de frases.
- Escalonamento em tempo de teste
- Um método para melhorar o desempenho alocando cálculos ao número de tentativas e etapas de raciocínio ao responder após o aprendizado. Compare custos e tempos de espera.
- Decodificação especulativa
- Um método de geração que cria o candidato de token anterior usando cálculos leves e o verifica com o modelo de destino. Os efeitos variam dependendo do modelo, equipamento, taxa de aceitação do candidato, etc.
- Cache KV
- Mecanismo que conserva informações usadas em Attention para evitar cálculos repetidos. Em contextos longos também influencia o consumo de memória.
- Modelo de mundo
- Um modelo que prevê o estado do meio ambiente e o resultado das ações. Distinguir entre a precisão dos próximos passos e a eficácia de previsões e planos longos.
- Manipulação da recompensa
- Aproveitar lacunas no sistema de pontuação e recompensa para obter pontuações altas sem atingir o propósito original.
- Pré-publicação
- Artigos manuscritos que podem ser publicados antes mesmo da revisão por pares em revistas e conferências acadêmicas. Há uma distinção entre ser publicado e ser revisado e adotado por pares.
- AI
- inteligência artificial. Um termo amplo para tecnologia que usa computadores para realizar reconhecimento, previsão, julgamento, etc. Também inclui aprendizado de máquina e IA generativa.
- Aprendizado de máquina (ML)
- Um método para aprender regularidades a partir de dados e usá-los para prever, classificar e gerar novas entradas.
- Aprendizado profundo
- Um método de aprendizado de máquina que usa redes neurais com muitas camadas. Também chamado de aprendizado profundo.
- IA generativa
- IA que gera conteúdo como frases, imagens e áudio com base em regularidades aprendidas.
- LLM
- Modelos de linguagem em grande escala. Um modelo que aprende com grandes quantidades de texto e é usado para geração, resumo, tradução de texto, etc.
- Transformer
- Design de rede neural que usa o cálculo chamado Attention para representar relações entre elementos. É utilizado em muitos LLMs.
- Parâmetro
- Valores numéricos dentro do modelo a serem ajustados durante o treinamento. Só porque existem muitos deles, você não pode julgar se eles são adequados para o seu propósito.
- Token
- Uma pequena unidade na qual um modelo trata frases, etc. Não corresponde ao número de caracteres ou palavras, e a divisão muda dependendo do modelo e do idioma.
- Janela de contexto
- Limite superior no comprimento das informações que podem ser referenciadas em um processo. Geralmente é expresso como um número de tokens e o tratamento do limite superior varia dependendo do modelo.
- Pré-treinamento
- O processo de aprender as regularidades que formam a base de um modelo a partir de uma ampla gama de dados.
- Ajuste fino
- Ajustando um modelo treinado com dados adicionais. Difere de escrever instruções e RAG porque atualiza parâmetros.
- Prompt
- Instruções e informações passadas para o modelo. Geralmente altera as condições para essa resposta, e não o aprendizado adicional do modelo em si.
- RAG
- Geração de extensão de pesquisa. Como pesquisar o material que você precisa e passar o que encontrar para um modelo para gerar uma resposta.
- Embedding
- Um método de expressar características de sentenças, etc. como uma sequência de números. Você pode usar a proximidade do conteúdo para pesquisas, etc.
- Alucinação
- Gerar de forma plausível conteúdo que não pode ser apoiado por fatos ou materiais. Fontes e números precisam ser verificados.
- Benchmark
- Avaliação para comparar o desempenho em tarefas fixas. A avaliação em aplicações reais do cliente também é necessária.
- Multimodal
- Lidar com vários tipos de informações, como texto, imagens e áudio. As entradas e saídas correspondentes variam dependendo do modelo.
- Agente de IA
- Um sistema que permite selecionar etapas em direção a um objetivo e prosseguir com o trabalho por meio de pesquisas, ferramentas, etc. Decida as ferramentas que você pode usar e os privilégios de execução.
- Latência
- A quantidade de tempo de espera antes de receber uma resposta para uma única solicitação. Às vezes medimos a primeira letra e o preenchimento de toda a resposta.
- Taxa de processamento
- O número de solicitações e tokens que podem ser processados em um determinado período de tempo. Esta é uma métrica separada do tempo de espera por uma única solicitação.
Os resultados da pesquisa devem ser lidos em conjunto com o modelo alvo, tarefas e condições experimentais. Por favor, verifique os materiais de referência para cada item, o escopo dos resultados e questões restantes.
Início da ajuda