Aprende sobre IA
De los fundamentos de IA y LLM a la investigación actual.
Categorías: 3 · Artículos: 30 · Términos: 35
Busca en «Aprende sobre IA». Separa las palabras con espacios para encontrar entradas que las contengan todas.
Empieza por lo que te interese
Todo el contenido de aprendizaje
Artículos: 30 · Términos: 35
Fundamentos de IA y LLM14
Incluso si es nuevo en la IA, puede comprender el significado de investigación, aprendizaje y provisión. Aprenda los conceptos básicos de la IA del mundo real a partir de ejemplos familiares.
Esta categoría es el conocimiento básico de la IA del mundo real. El rendimiento, el coste y el número de días de juego son expresiones de la gestión del juego. Las operaciones relacionadas se pueden encontrar en "Leer también" para cada elemento.
Aprender con ilustraciones
¿Qué diferencia a IA, aprendizaje automático e IA generativa?
IA es un término amplio para la tecnología que utiliza computadoras para realizar reconocimiento, predicción, juicio, etc. El aprendizaje automático se refiere a un método para aprender regularidades a partir de datos, y la IA generativa se refiere a la IA que crea oraciones, imágenes, etc.
IA es un término amplio para la tecnología que utiliza computadoras para realizar reconocimiento, predicción, juicio, etc. El aprendizaje automático se refiere a un método para aprender regularidades a partir de datos, y la IA generativa se refiere a la IA que crea oraciones, imágenes, etc.
IA, aprendizaje automático e IA generativa
Incluso para el mismo correo electrónico, las funciones de categorizar y crear una respuesta son diferentes.
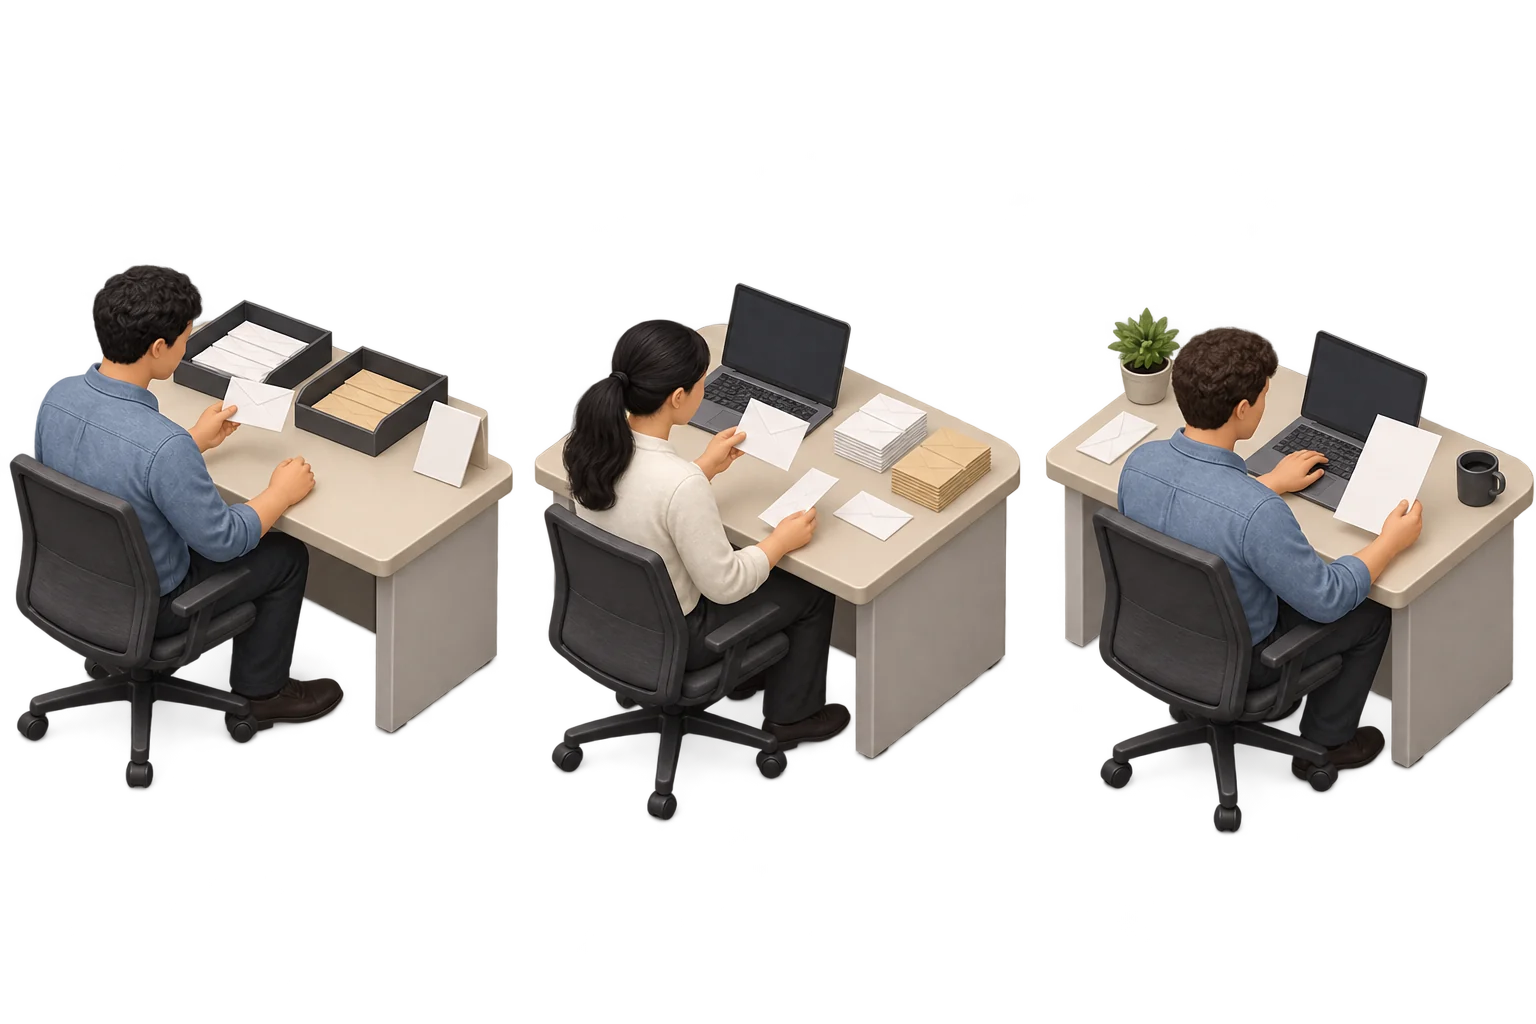
Izquierda: clasificar con reglas
Ordene los correos electrónicos según condiciones predeterminadas. La IA tiene otros mecanismos además de aprender de los datos.
Centro: aprender a clasificar con ejemplos
Utilice correos electrónicos clasificados y más para conocer regularidades y clasificar correos electrónicos nuevos. Este es un ejemplo de aprendizaje automático.
Derecha: crear una respuesta nueva
Utilice las regularidades aprendidas para generar oraciones que coincidan con las instrucciones. Este es un ejemplo de IA generativa.
El aprendizaje automático y la IA generativa están incluidos en la IA. El aprendizaje automático es un método de aprendizaje y la IA generativa es el nombre de la IA que crea contenido. La IA generativa como LLM se crea mediante aprendizaje automático.
Esta es una ilustración explicativa que ha sido reemplazada por un escritorio y materiales.
El aprendizaje profundo es un tipo de aprendizaje automático
Es un método que combina muchas capas de un mecanismo de cálculo llamado red neuronal. Es la base para LLM, etc. No toda la IA se crea con aprendizaje profundo.
Puede leer la tabla moviéndola hacia la izquierda y hacia la derecha.
| Palabras | Significado | Ejemplo |
|---|---|---|
| AI | Todo el arte de hacer trabajo intelectual. También incluye mecanismos que operan de acuerdo con reglas establecidas. | Rivales de juegos y reconocimiento de imágenes |
| Aprendizaje automático (ML) | Aprenda las regularidades de la predicción y la clasificación utilizando datos de ejemplo. | Clasificación de correo electrónico no deseado, previsión de ventas. |
| IA generativa | Genere contenido nuevo utilizando regularidades aprendidas. | Redactar texto, generar imágenes y audio. |
Por ejemplo:Un mismo correo puede tener funciones distintas
"Determinar si es spam" es clasificación y "crear un texto de respuesta" es generación. Las empresas de IA eligen su tecnología en función de las tareas que necesitan sus clientes.
En AI Inc.
Al elegir un campo de estudio, piense no sólo en el nombre de la tecnología, sino también en el tipo de trabajo que desea que pueda realizar su próximo modelo.
¿Qué es un LLM y cómo genera texto?
LLM significa «modelo de lenguaje de gran tamaño». Aprende patrones del lenguaje a partir de grandes cantidades de texto y se usa para generar, resumir y traducir, entre otras tareas.
¿Qué es un LLM y cómo genera texto?
LLM significa «modelo de lenguaje de gran tamaño». Aprende patrones del lenguaje a partir de grandes cantidades de texto y se usa para generar, resumir y traducir, entre otras tareas.
LLM significa «modelo de lenguaje de gran tamaño». Aprende patrones del lenguaje a partir de grandes cantidades de texto y se usa para generar, resumir y traducir, entre otras tareas.
LLM: crear texto calculando su continuación
Calcula el siguiente candidato del contexto y continúa.
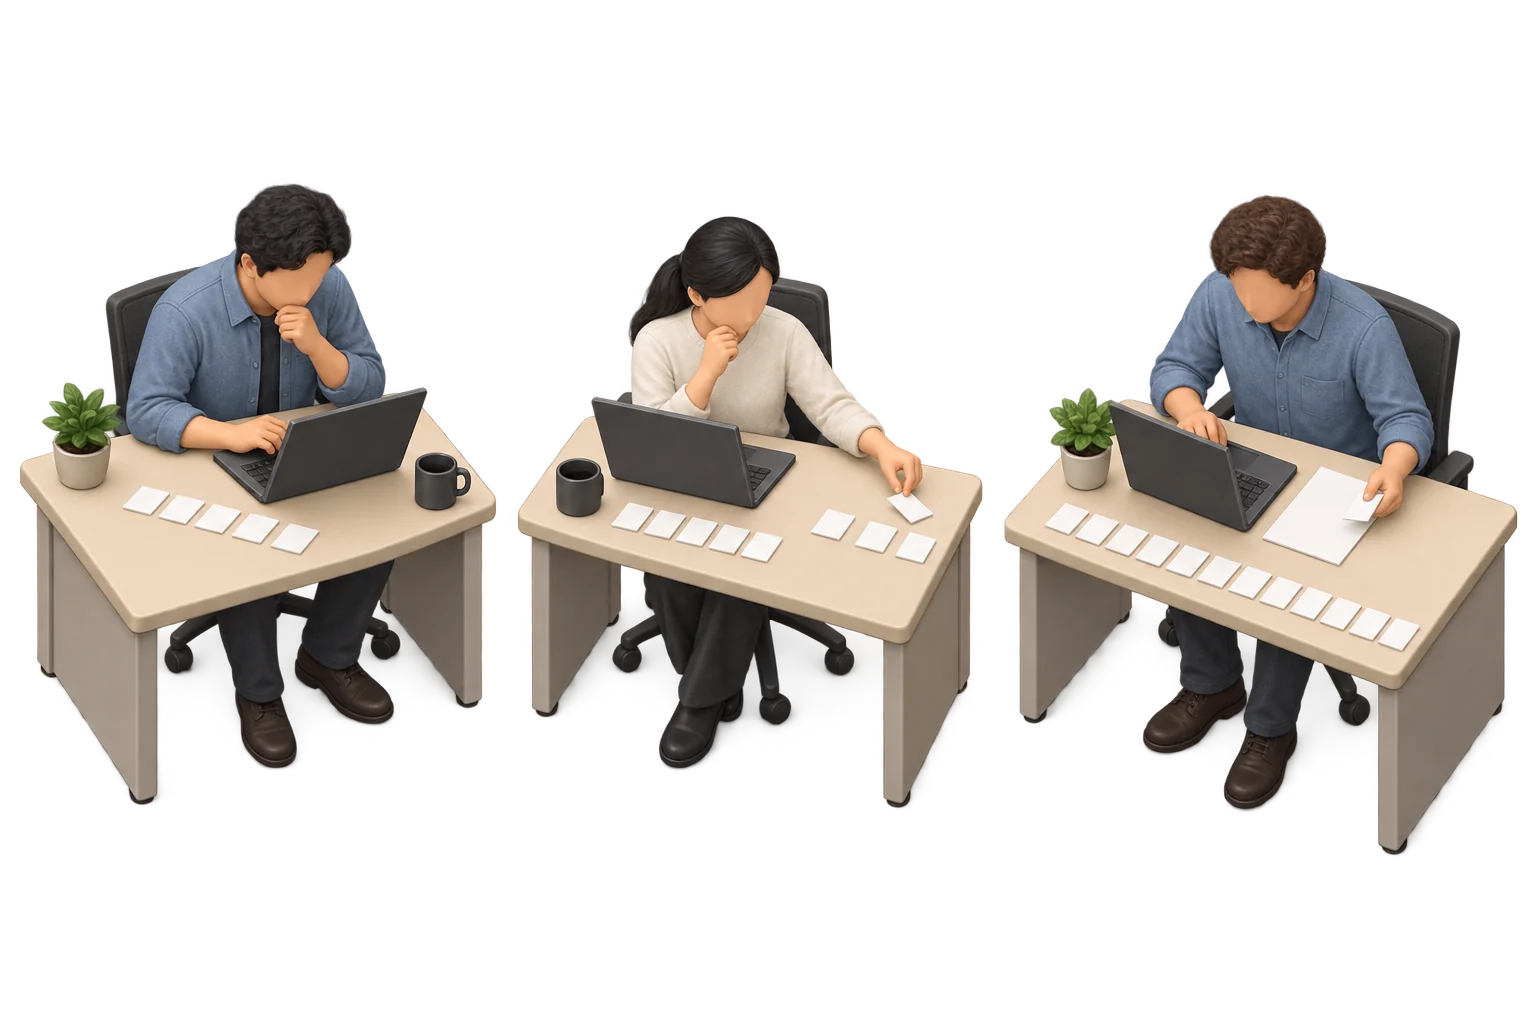
Recibir el contexto
Utilice instrucciones, preguntas y contenido generado previamente.
Calcular la siguiente sugerencia
Calcule el candidato y la probabilidad del siguiente token.
Construir el texto añadiendo continuaciones
Repita el proceso de calcular el siguiente token utilizando el contenido recién generado.
Un trozo de papel es una metáfora de una ficha. Los tokens son pequeñas unidades de texto que no necesariamente coinciden con palabras. Hay una diferencia entre la naturalidad del texto y la exactitud de los hechos.
Esta es una ilustración explicativa que ha sido reemplazada por un escritorio y materiales.
Calcular candidatos para la continuación
Divide el texto en pequeñas unidades de tokens y calcula el siguiente token candidato y la probabilidad en función de la entrada y el contenido generado hasta el momento. Repita este proceso para crear una respuesta.
Un modelo y una aplicación de chat son distintos
El modelo es la parte que calcula la salida a partir de la entrada. Las aplicaciones de chat utilizan modelos que combinan historial de conversaciones, búsqueda, archivos, herramientas y más. Las funciones que están disponibles también dependen de la aplicación.
Por ejemplo:Continuar «Como llueve,»
Hay sugerencias que coinciden con el contexto, como "traer paraguas" y "posponer salir". LLM calcula estas continuaciones incluso en oraciones más largas. El procesamiento real no es necesariamente palabra por palabra.
Precauciones
Incluso si puedes escribir oraciones naturales, eso no significa necesariamente que el contenido sea correcto. Es necesario revisar los conocimientos adquiridos, los materiales entregados y el alcance de la información buscada.
En AI Inc.
El modelo completo y el producto API que ofrecemos a nuestros clientes son etapas separadas. Después de crear un modelo, se generarán razones para ajustar el uso, los precios y el suministro.
¿Qué son los tokens y la ventana de contexto?
Un token es una unidad pequeña, como una oración, que maneja el modelo. La ventana de contexto representa el límite superior de la longitud de la información que se puede ver en un proceso.
¿Qué son los tokens y la ventana de contexto?
Un token es una unidad pequeña, como una oración, que maneja el modelo. La ventana de contexto representa el límite superior de la longitud de la información que se puede ver en un proceso.
Un token es una unidad pequeña, como una oración, que maneja el modelo. La ventana de contexto representa el límite superior de la longitud de la información que se puede ver en un proceso.
Contexto: la información de esta ocasión
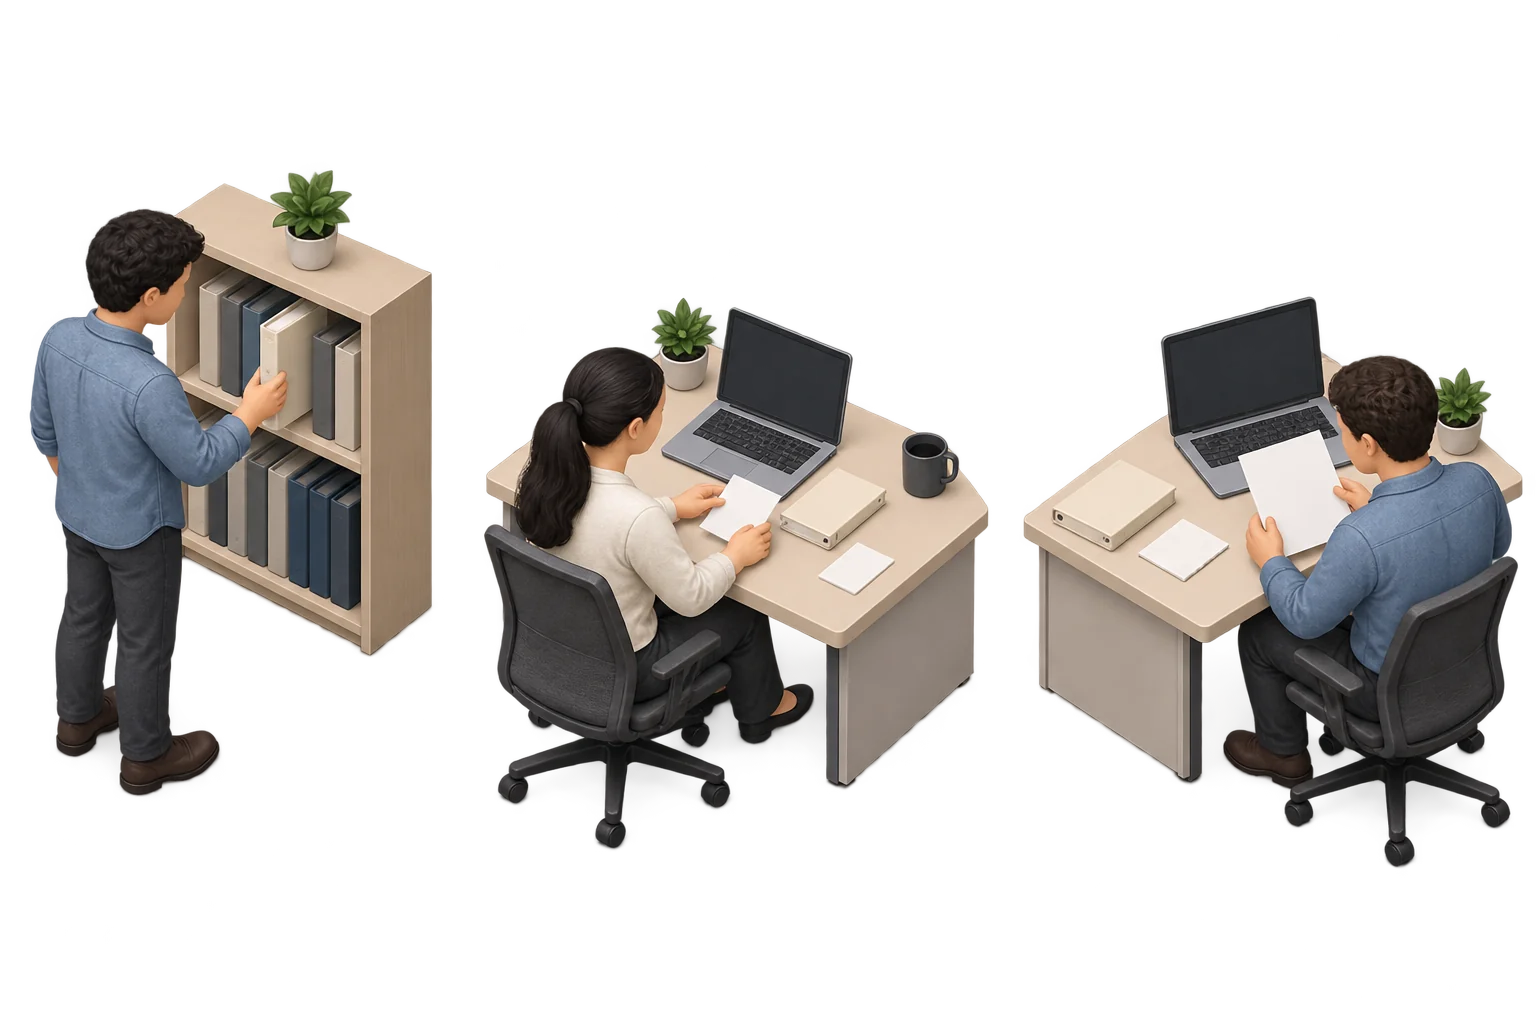
Separe los materiales de su escritorio de los almacenados en el estante.
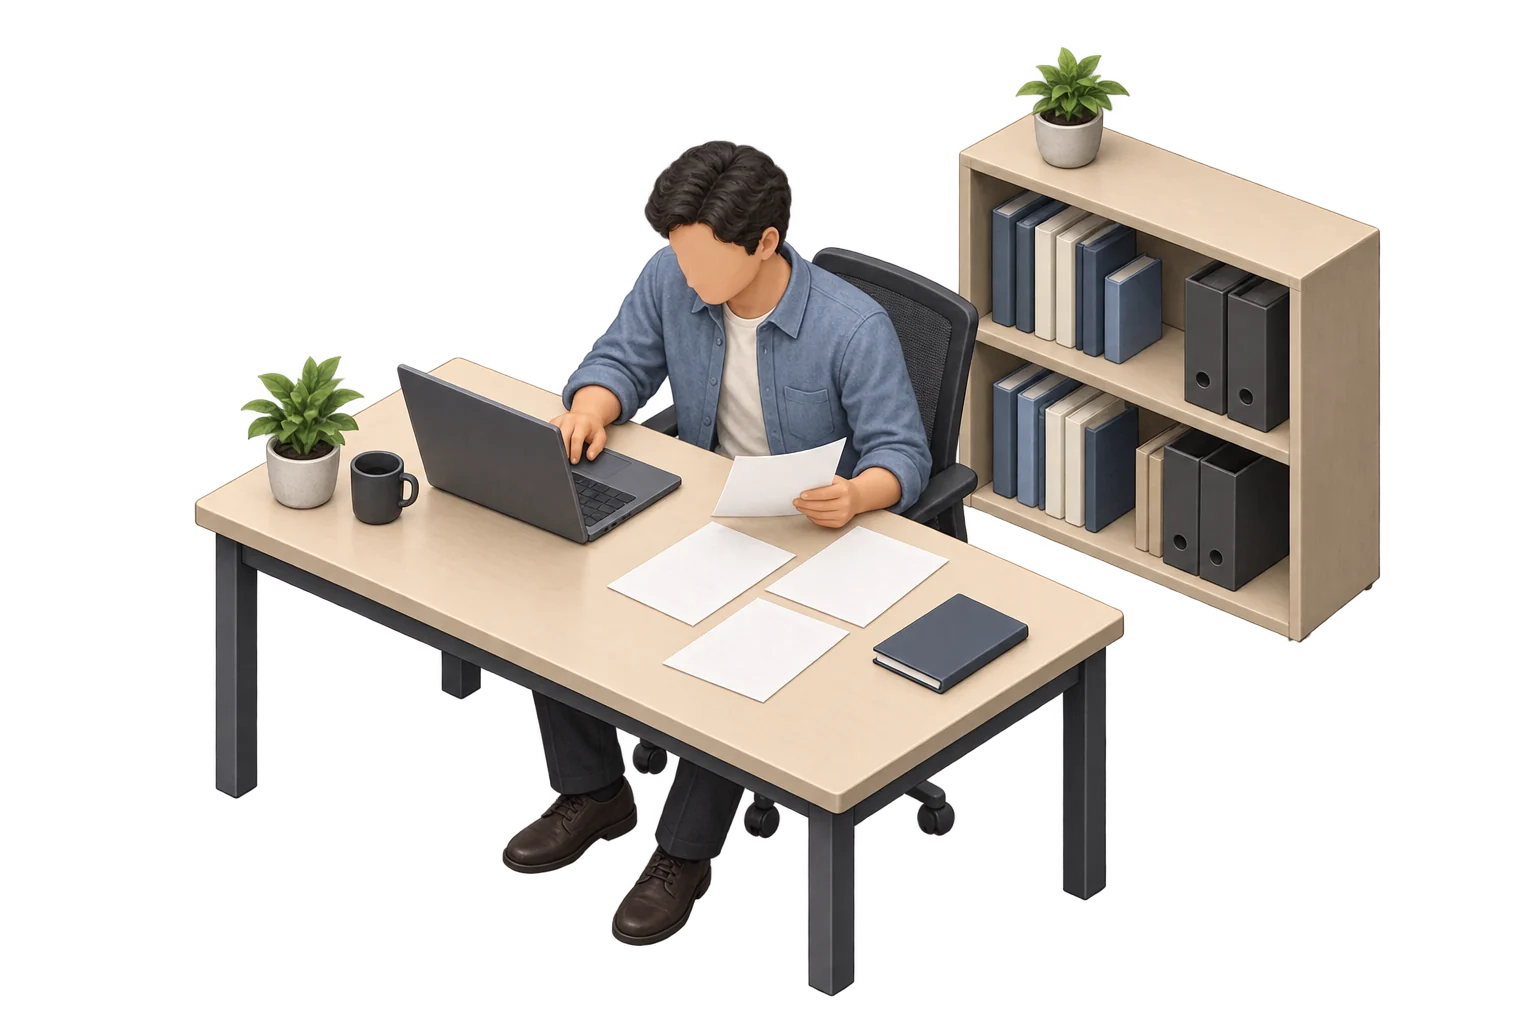
En el escritorio: información proporcionada esta vez
Las instrucciones, preguntas, historial de conversaciones y materiales pasados por la aplicación a este proceso se incluirán en el contexto.
Dentro de la estantería: Materiales que aún no han sido entregados
Incluso si ha guardado materiales o conversaciones pasadas, es posible que no pueda consultarlos a menos que se los hayan entregado esta vez.
La ventana de contexto es la longitud máxima de información que se puede ver, generalmente expresada en tokens. La entrega de materiales es independiente del aprendizaje adicional. Incluso si les das materiales largos, eso no significa que puedan usarlos todos correctamente.
Esta es una ilustración explicativa que ha sido reemplazada por un escritorio y materiales.
No coincide con el número de caracteres/palabras
Los tokens pueden ser palabras, partes de palabras, caracteres, etc. La división cambia según el modelo y el idioma, por lo que un carácter japonés no siempre puede contarse como un token.
Conversaciones y documentos también aportan contexto
Las instrucciones, el historial de conversaciones, los materiales, etc. pasados por la aplicación entran en contexto. Los límites de entrada y salida se tratan de forma diferente según el modelo. Incluso si incluye material extenso, no hay garantía de que pueda utilizarlo todo con precisión.
Por ejemplo:Imagen de materiales para esparcir sobre un escritorio.
El contexto es similar a los materiales que extiende sobre su escritorio para formular su respuesta. Tener los materiales en tu escritorio es una cosa, pero aprender más sobre el modelo en sí es otra.
En AI Inc.
A medida que aumente la cantidad de información manejada, las cargas computacionales y de memoria también cambiarán en los servicios del mundo real. En el juego, verifica la inferencia de oferta y demanda para ofrecer a tus clientes.
¿Más parámetros significan un modelo mejor?
Los parámetros son valores numéricos dentro del modelo que se ajustan durante el entrenamiento. Esta es una pista sobre la escala del modelo, pero el hecho de que haya un gran número no significa que sea adecuado para el propósito.
¿Más parámetros significan un modelo mejor?
Los parámetros son valores numéricos dentro del modelo que se ajustan durante el entrenamiento. Esta es una pista sobre la escala del modelo, pero el hecho de que haya un gran número no significa que sea adecuado para el propósito.
Los parámetros son valores numéricos dentro del modelo que se ajustan durante el entrenamiento. Esta es una pista sobre la escala del modelo, pero el hecho de que haya un gran número no significa que sea adecuado para el propósito.
Elegir modelo: tamaño, uso y coste
Compare no solo la cantidad de productos, sino también las condiciones de trabajo en las que se utilizarán.
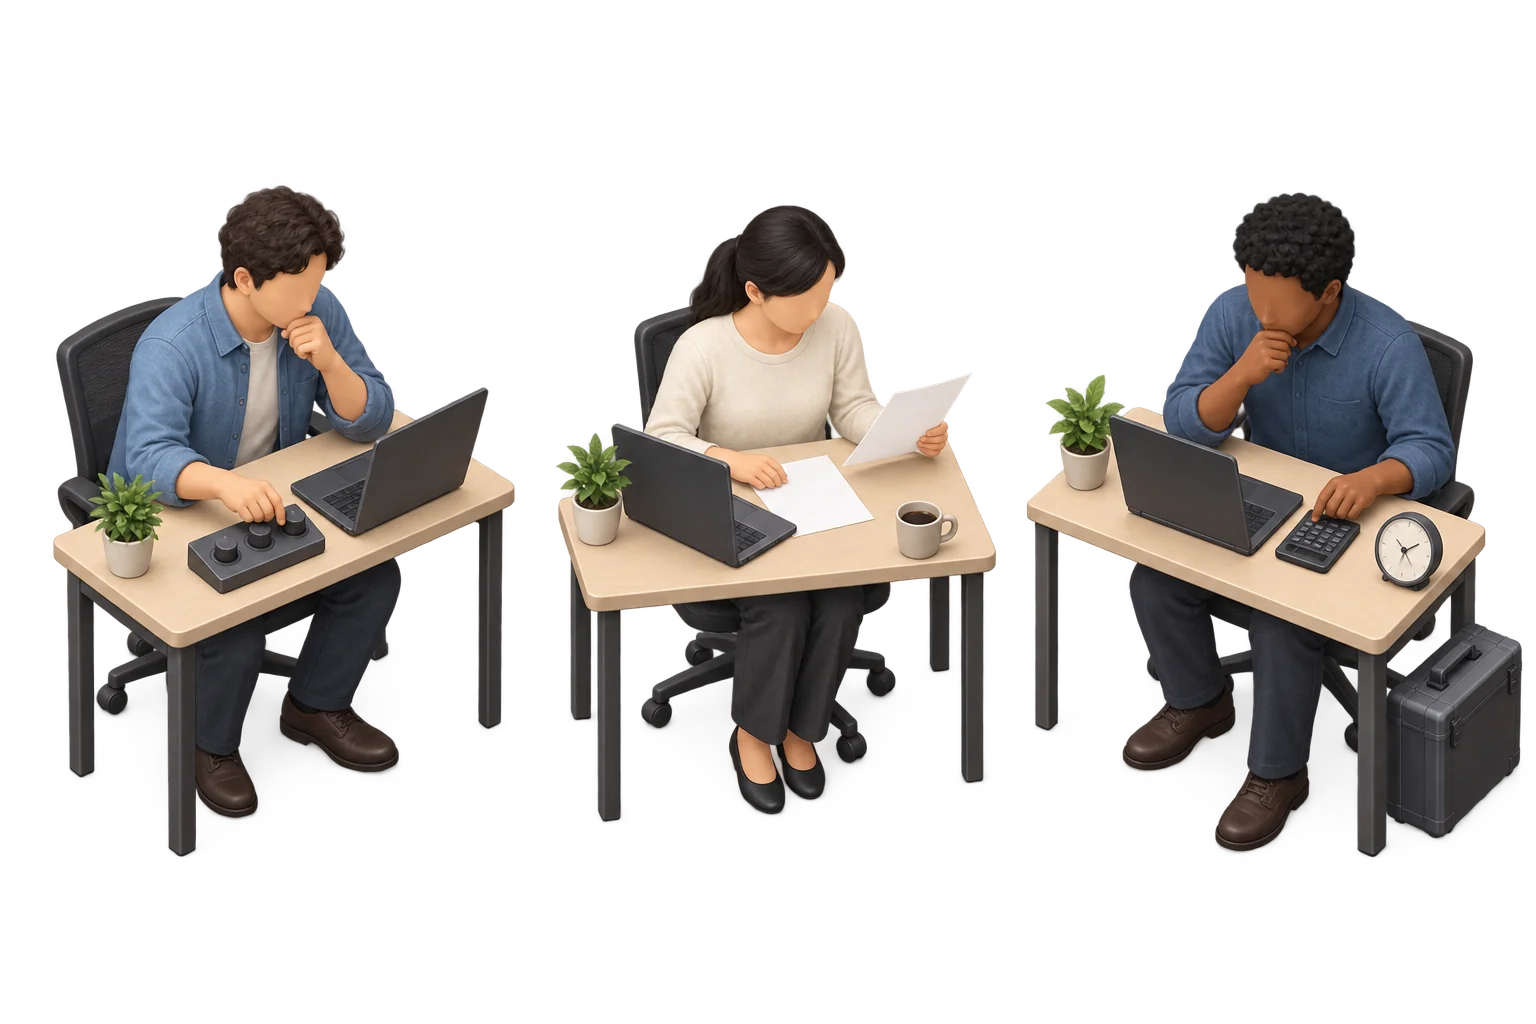
Izquierda: valores ajustados al entrenar
Los parámetros son valores numéricos dentro del modelo. El hecho de que el número sea grande no significa que sea adecuado para el propósito.
Centro: comprobar en la tarea real
Pruébelo con preguntas y materiales reales para asegurarse de que cumple con la calidad que necesita.
Derecha: comparar también recursos y costes
Compare la velocidad, el costo, la carga computacional y de memoria de los candidatos que cumplen con la calidad requerida.
Una perilla es una metáfora para ajustar los valores internos. El número de parámetros no es el número de hechos conocidos. Los datos, el diseño y los métodos de aprendizaje también afectan los resultados.
Esta es una ilustración explicativa que ha sido reemplazada por un escritorio y materiales.
Valores que se ajustan al entrenar
Son valores como los pesos de una red neuronal. Se ajustan a partir de muchos ejemplos para producir salidas adecuadas al objetivo. El número de parámetros no equivale al número de hechos que el modelo conoce.
Considerar rendimiento, recursos y uso juntos
Además de la escala, la calidad de los datos, el diseño y los métodos de aprendizaje afectan los resultados. Los modelos grandes generalmente requieren más memoria y recursos computacionales, pero la configuración y optimización también varían. Comparemos en uso real.
Por ejemplo:Clasificación breve y redacción de textos complejos
Un modelo ligero puede ser suficiente para clasificar consultas breves. La escritura más compleja puede requerir un mayor nivel de habilidad. Compare la velocidad y el costo de los modelos que cumplen con la calidad deseada.
En AI Inc.
Al diseñar un modelo, no solo observe el rendimiento predictivo, sino también el costo de entrenamiento y la carga/velocidad de inferencia. Combinaremos la decisión de aumentar la escala con la decisión de continuar como negocio.
¿En qué se diferencian entrenamiento e inferencia?
El aprendizaje es el proceso de ajustar los valores internos del modelo y la inferencia es el proceso de calcular la respuesta utilizando el modelo entrenado. También se requieren recursos informáticos para dar respuestas a los usuarios.
¿En qué se diferencian entrenamiento e inferencia?
El aprendizaje es el proceso de ajustar los valores internos del modelo y la inferencia es el proceso de calcular la respuesta utilizando el modelo entrenado. También se requieren recursos informáticos para dar respuestas a los usuarios.
El aprendizaje es el proceso de ajustar los valores internos del modelo y la inferencia es el proceso de calcular la respuesta utilizando el modelo entrenado. También se requieren recursos informáticos para dar respuestas a los usuarios.
Entrenamiento e inferencia
Se requieren cálculos tanto al crear como al utilizar un modelo.
Entrenamiento: ajustar el modelo
Utilice datos de ejemplo para ajustar los números dentro del modelo.
Inferencia: usar un modelo entrenado
Ingrese una nueva pregunta, etc., y calcule la respuesta.
La inferencia normal no actualiza los números dentro del modelo. Guardar conversaciones es una cosa, aprender más es otra.
Esta es una ilustración explicativa que ha sido reemplazada por un escritorio y materiales.
Entrenar: ajustar el modelo a partir de ejemplos
Compare el resultado del ejemplo con el objetivo de aprendizaje y ajuste los números internos. Si separa el proceso de creación de un modelo y el proceso de uso del modelo creado, será más fácil comprender la diferencia entre recursos y costos.
Inferir: responder a la solicitud actual
Calcula la salida a partir de la entrada utilizando números aprendidos. La inferencia normal no es un proceso de reaprender números internos cada vez que respondes. Hacer referencia a conversaciones y materiales como aportes actuales es independiente del aprendizaje adicional.
Puede leer la tabla moviéndola hacia la izquierda y hacia la derecha.
| Qué comprobar | Entrenamiento | Inferencia |
|---|---|---|
| Objetivo | Ajustar parámetros a partir de ejemplos | Calcular la salida para una nueva entrada |
| Ejemplo de entrada | Textos de entrenamiento y ejemplos de preguntas y respuestas | Preguntas del usuario y documentos consultados |
| Valores internos | Actualizar mediante entrenamiento | No se actualiza durante la inferencia habitual |
| Cómo utilizar los recursos | Cómputo para crear y mejorar modelos | Cálculos para procesar solicitudes de clientes. |
Por ejemplo:Crear también implica costes de operación
Incluso si completa un modelo que responde a una consulta, aún necesita hacer inferencias cada vez que un usuario hace una pregunta. A medida que más personas lo utilizan al mismo tiempo, también aumenta la capacidad de entrega requerida.
Precauciones
Guardar conversaciones y utilizar entradas para aprendizaje futuro es una política de servicio diferente a actualizar parámetros durante la respuesta actual.
En AI Inc.
Los recursos computacionales para el aprendizaje y la inferencia son roles separados. Incluso si se completa el aprendizaje, si la asignación a la inferencia es insuficiente, habrá escasez de suministro para los clientes.
¿Qué son el preentrenamiento y el ajuste fino?
El preentrenamiento es el proceso de aprender regularidades básicas a partir de una amplia gama de datos, y el ajuste fino es el proceso de ajustar el modelo entrenado con datos adicionales.
¿Qué son el preentrenamiento y el ajuste fino?
El preentrenamiento es el proceso de aprender regularidades básicas a partir de una amplia gama de datos, y el ajuste fino es el proceso de ajustar el modelo entrenado con datos adicionales.
El preentrenamiento es el proceso de aprender regularidades básicas a partir de una amplia gama de datos, y el ajuste fino es el proceso de ajustar el modelo entrenado con datos adicionales.
Preentrenamiento y entrenamiento adicional
Construya una base y ajústela para que se adapte al trabajo para el que la utilizará.
Izquierda: crear una base con ejemplos diversos
Aprenda reglas básicas usando muchas oraciones. Este es el proceso de ajustar los valores numéricos dentro del modelo.
Derecha: ajustar con ejemplos del uso previsto
Utilice el modelo entrenado como punto de partida y aprenda adicionalmente con ejemplos que se adapten a su trabajo y formato de salida. El ajuste fino actualiza los valores internos.
Dar instrucciones en un prompt o proporcionar documentos mediante RAG es distinto del entrenamiento adicional. Para comprobar si el entrenamiento mejoró el modelo se usan ejemplos que no formaron parte de él.
Esta es una ilustración explicativa que ha sido reemplazada por un escritorio y materiales.
Crear una base con preentrenamiento
Muchos modelos de lenguaje aprenden las regularidades de las palabras resolviendo una gran cantidad de tareas, como predecir la continuación de una oración. Al utilizar una base previamente entrenada, no es necesario crear un modelo desde cero cada vez.
Adaptar al uso con entrenamiento adicional
Los ejemplos de preguntas y respuestas deseadas hacen que las instrucciones sean más fáciles de seguir o adaptadas a tareas y formatos de salida específicos. Aprender a responder a instrucciones y utilizar las evaluaciones de las personas se incluye en la postformación después del preaprendizaje.
Por ejemplo:Unificar el formato de clasificación de consultas
Se puede considerar un aprendizaje adicional para facilitar la producción en un formato fijo utilizando oraciones de consulta y ejemplos de clasificación de "facturación", "contrato" y "operación". Compruebe si las mejoras se han realizado utilizando ejemplos que no se utilizaron para el aprendizaje.
Precauciones
El entrenamiento adicional es distinto de RAG, que busca documentos. No debe elegirse automáticamente como una forma de garantizar que el modelo memorice hechos nuevos.
En AI Inc.
El desarrollo de derivados utilizando un modelo principal lleva a la idea de hacer uso de la base existente. Lea la pantalla de confirmación de objetivos para conocer las condiciones de rendimiento y costos que se transferirán al juego.
¿Basta con aumentar los datos de entrenamiento?
Los datos necesitan no sólo cantidad, sino también precisión, variedad y proximidad en su uso. Un estado en el que el sistema es fuerte sólo con ejemplos que ha visto durante el entrenamiento y débil con ejemplos nuevos se llama "sobreajuste".
¿Basta con aumentar los datos de entrenamiento?
Los datos necesitan no sólo cantidad, sino también precisión, variedad y proximidad en su uso. Un estado en el que el sistema es fuerte sólo con ejemplos que ha visto durante el entrenamiento y débil con ejemplos nuevos se llama "sobreajuste".
Los datos necesitan no sólo cantidad, sino también precisión, variedad y proximidad en su uso. Un estado en el que el sistema es fuerte sólo con ejemplos que ha visto durante el entrenamiento y débil con ejemplos nuevos se llama "sobreajuste".
Datos de entrenamiento: cantidad, calidad y verificación
No se limite a agregar más ejemplos, límpielos y compruébelos con otros ejemplos.
Cantidad: ¿Hay sólo ejemplos similares?
Aumentar el número de ejemplos no basta para cubrir las situaciones de uso si hay muchos duplicados o sesgos.
Calidad: prepare ejemplos que coincidan con la situación de uso
Revise los errores y las duplicaciones, y prepare una amplia gama de ejemplos que se acerquen a la pregunta, el lenguaje y la audiencia reales.
Evaluación: comprobar con ejemplos no usados en el entrenamiento
Separe las partes para aprendizaje, verificación para ajuste y prueba final. Comprobemos con un ejemplo que no se utilizó en el estudio.
El sobreajuste es un estado en el que el sistema es fuerte solo con ejemplos vistos durante el entrenamiento y débil con ejemplos nuevos. Nos fijamos en la cantidad, calidad y proximidad de los datos al uso previsto.
Esta es una ilustración explicativa que ha sido reemplazada por un escritorio y materiales.
Preparar ejemplos próximos al uso real
Los errores, la duplicación y los datos sesgados también pueden afectar sus resultados. Decida qué tipo de preguntas, lenguaje y usuarios espera, y prepare ejemplos que sean representativos del uso real.
Separar datos de entrenamiento y evaluación
Si evalúa sólo los ejemplos que memorizó durante el aprendizaje, será difícil juzgar si puede manejar nuevos aportes. También distinguimos entre los datos de verificación utilizados para el ajuste y los datos de prueba utilizados para la confirmación final.
Por ejemplo:Aprender solo con preguntas cortas
Incluso si se le dan bien las frases breves y fijas, es posible que se le debiliten las consultas largas o las preguntas con frases diferentes. Lo comprobaremos con datos no utilizados, incluidos ejemplos realmente escritos por los usuarios.
En AI Inc.
La concesión de licencias de datos, el mantenimiento y la selección para el aprendizaje son etapas separadas. Una vez que comprenda el concepto de calidad de los datos en la vida real, será más fácil comprender el propósito del mantenimiento en los juegos.
¿Escribir un prompt es entrenar?
Las indicaciones son instrucciones o información que usted pasa a su modelo. Por lo general, se cambian las condiciones para la respuesta, lo cual es diferente del aprendizaje, que actualiza los parámetros del modelo.
¿Escribir un prompt es entrenar?
Las indicaciones son instrucciones o información que usted pasa a su modelo. Por lo general, se cambian las condiciones para la respuesta, lo cual es diferente del aprendizaje, que actualiza los parámetros del modelo.
Las indicaciones son instrucciones o información que usted pasa a su modelo. Por lo general, se cambian las condiciones para la respuesta, lo cual es diferente del aprendizaje, que actualiza los parámetros del modelo.
Prompt: objetivo, documentos y formato
Dígales qué quiere que hagan, qué usar y cómo responder.
Finalidad: Cuéntanos lo que quieres
Escriba la tarea específica que está solicitando, como "resumir las actas".
Documentos: indicar el alcance de uso
Deles las actas a las que le gustaría que se refieran e indique el alcance de la reunión, diciendo: "Sólo usaré este material".
Formato: indicar la forma de la respuesta
Especifique el formato del resultado, como "Decisiones en tres viñetas".
Pasar instrucciones y materiales suele estar separado del aprendizaje posterior del modelo. Incluso si las instrucciones son específicas, seguirán produciéndose errores, así que coteje sus respuestas con los materiales.
Esta es una ilustración explicativa que ha sido reemplazada por un escritorio y materiales.
Transmitir el propósito, los materiales y el formato de salida.
Escriba en detalle lo que quiere que hagan, qué información quiere que utilicen y cómo quiere que respondan. Si es necesario, pase también un ejemplo del resultado deseado.
Continuar la conversación amplía la información disponible
La razón por la que puedes usar declaraciones pasadas es porque la aplicación tiene un mecanismo para pasarlas al modelo. El simple hecho de poder utilizar nueva información durante una conversación no significa que el modelo haya aprendido permanentemente.
Por ejemplo:Concretar la petición «Resúmelo»
Comunique el propósito, el alcance y el formato, como por ejemplo: "Utilice sólo los siguientes minutos y enumere las decisiones en tres puntos". Por favor, no complete nada que no esté en el documento".
Precauciones
Las instrucciones detalladas pueden ayudar, pero no garantizan que estén libres de errores. Comprobemos el resultado con el material real.
En AI Inc.
Diseñar un modelo y comenzar a aprender en un juego es diferente a escribir instrucciones en un chat de la vida real. El simple hecho de guardar el diseño no generará el costo ni el progreso de este estudio.
¿Qué son RAG y los embeddings? ¿En qué se diferencian del entrenamiento adicional?
RAG es un método que busca los materiales necesarios para una respuesta y pasa el contenido encontrado al modelo para generarlo. Los materiales a buscar se gestionan por separado de los parámetros del modelo.
¿Qué son RAG y los embeddings? ¿En qué se diferencian del entrenamiento adicional?
RAG es un método que busca los materiales necesarios para una respuesta y pasa el contenido encontrado al modelo para generarlo. Los materiales a buscar se gestionan por separado de los parámetros del modelo.
RAG es un método que busca los materiales necesarios para una respuesta y pasa el contenido encontrado al modelo para generarlo. Los materiales a buscar se gestionan por separado de los parámetros del modelo.
RAG: buscar documentos antes de responder
Pase el material recuperado al modelo para que responda.
Buscar materiales relacionados
Busque la pieza que necesita en los manuales que coincidan con su pregunta.
Proporcionar junto con la pregunta
Pase el material encontrado al modelo como información para referencia en la respuesta.
Responda refiriéndose a los materiales.
El modelo genera una respuesta. También verifique que el material respalde su respuesta.
Proporcionar documentos no equivale a entrenar adicionalmente el modelo. Los documentos pueden estar desactualizados y la respuesta puede apartarse de ellos, por lo que RAG por sí solo no garantiza la exactitud.
Esta es una ilustración explicativa que ha sido reemplazada por un escritorio y materiales.
Buscar → aportar documentos → responder
Busque manuales internos de la empresa relacionados con su pregunta y pase las partes relevantes junto con su pregunta. No es necesario volver a entrenar todo el modelo para hacer referencia a la documentación actualizada.
Buscar contenido similar con embeddings
Un embedding representa características de un texto u otros datos mediante una secuencia de números. La proximidad entre esas representaciones puede usarse para buscar. RAG también puede emplear búsquedas por palabras clave o combinar ambos métodos.
Diferentes formas de aportar información
Usando la respuesta a la consulta como ejemplo, separaremos la información que se transmitirá esta vez y los números que se ajustarán durante el aprendizaje.
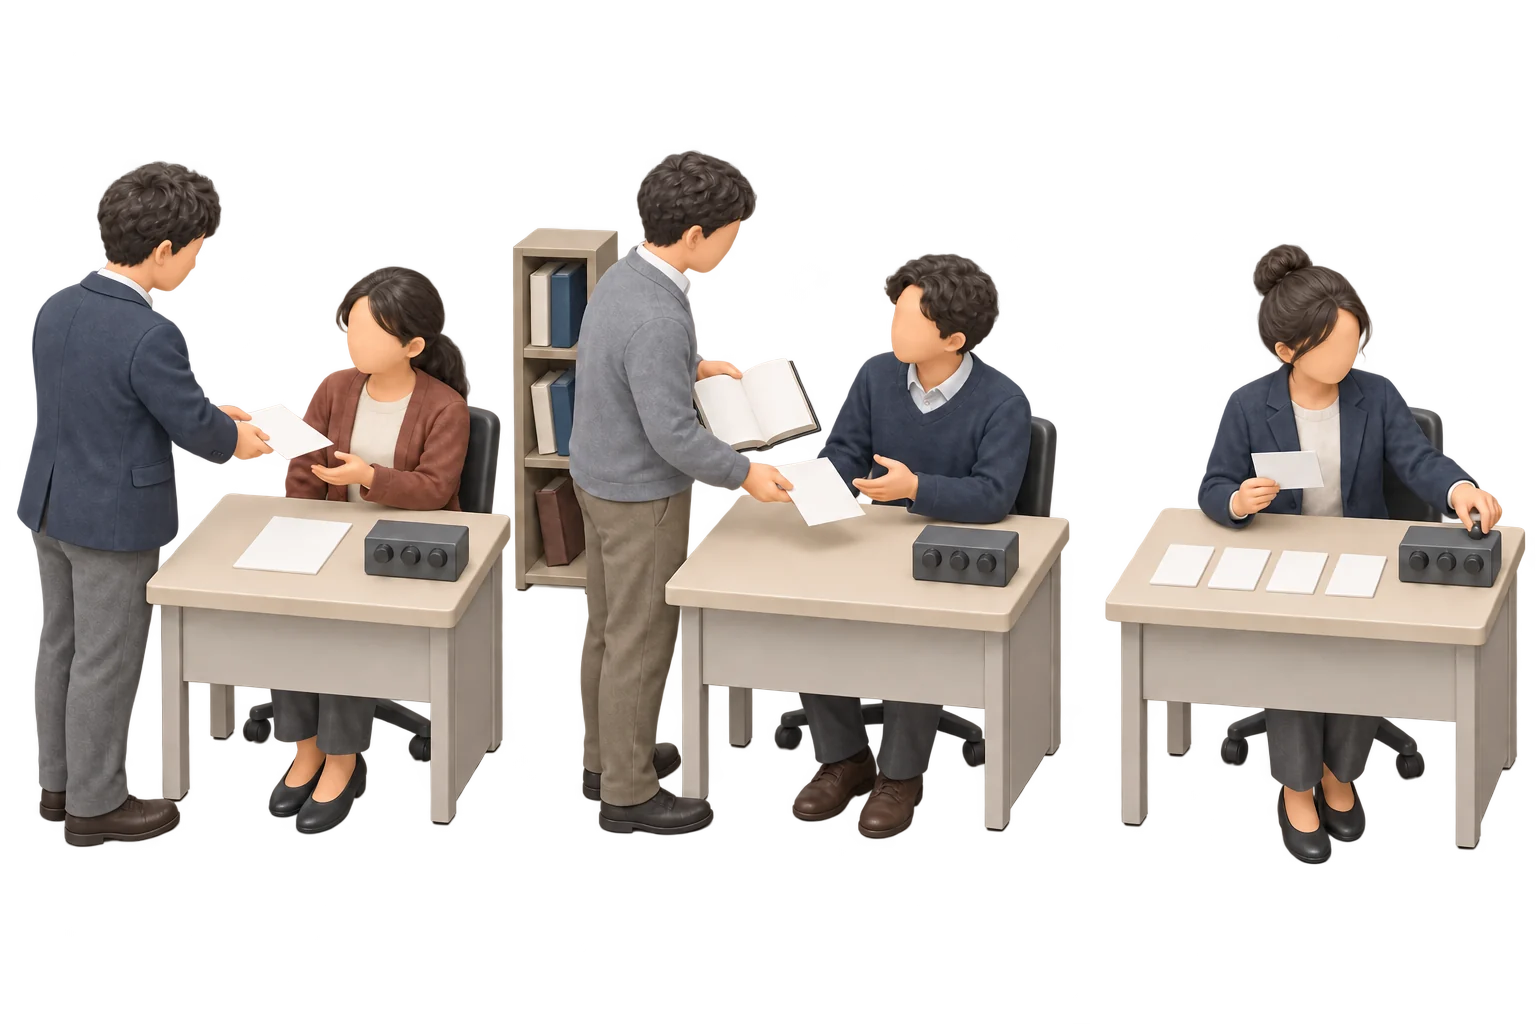
Izquierda: prompt
Bríndeles instrucciones y materiales, como "Mantenga sus respuestas en dos oraciones". La respuesta habitual no actualiza los números dentro del modelo.
Centro: RAG
Encuentre un manual que se ajuste a su pregunta y transmítale las piezas necesarias junto con las instrucciones. El proceso de buscar y pasar datos en sí no actualiza los valores numéricos dentro del modelo.
Derecha: ajuste fino
Ajuste los números internos del modelo entrenado con una consulta de ejemplo y la clasificación deseada. Se utiliza para coincidir con el formato de clasificación de "Facturación/Contrato/Operación".
Los tres métodos pueden combinarse. En RAG, los documentos recuperados se incluyen en el prompt. Piensa si necesitas usar documentos que se actualizan o adaptar el formato de salida, y compruébalo con preguntas reales.
Una perilla es una metáfora que representa un valor numérico dentro de un modelo. Las tres escenas son comparaciones de métodos, no de orden de trabajo.
Por ejemplo:Si cambia el horario de atención
Busque materiales con nuevos horarios comerciales y proporciónelos como evidencia de su respuesta. Si busca material antiguo, incluso RAG puede ser una respuesta antigua.
Precauciones
Es posible que los materiales se mezclen o que se genere información que no esté en los materiales. Evalúe tanto los resultados de la búsqueda como el resultado para asegurarse de que las referencias realmente respalden la respuesta.
En AI Inc.
Este es un conocimiento básico para los servicios de IA del mundo real. Esto no significa que puedas configurar RAG individualmente en el juego. Esto lleva a la idea de seleccionar modelos y datos que se adapten al propósito.
¿Qué es la alucinación? ¿Por qué comprobar la respuesta?
La alucinación es la creación de contenido plausible que no puede respaldarse con hechos o documentos. Se puede mezclar información o fuentes inexistentes en la escritura natural.
¿Qué es la alucinación? ¿Por qué comprobar la respuesta?
La alucinación es la creación de contenido plausible que no puede respaldarse con hechos o documentos. Se puede mezclar información o fuentes inexistentes en la escritura natural.
La alucinación es la creación de contenido plausible que no puede respaldarse con hechos o documentos. Se puede mezclar información o fuentes inexistentes en la escritura natural.
Alucinaciones y comprobación de fuentes
Incluso si la respuesta es fácil de leer, abra la fuente y verifique.
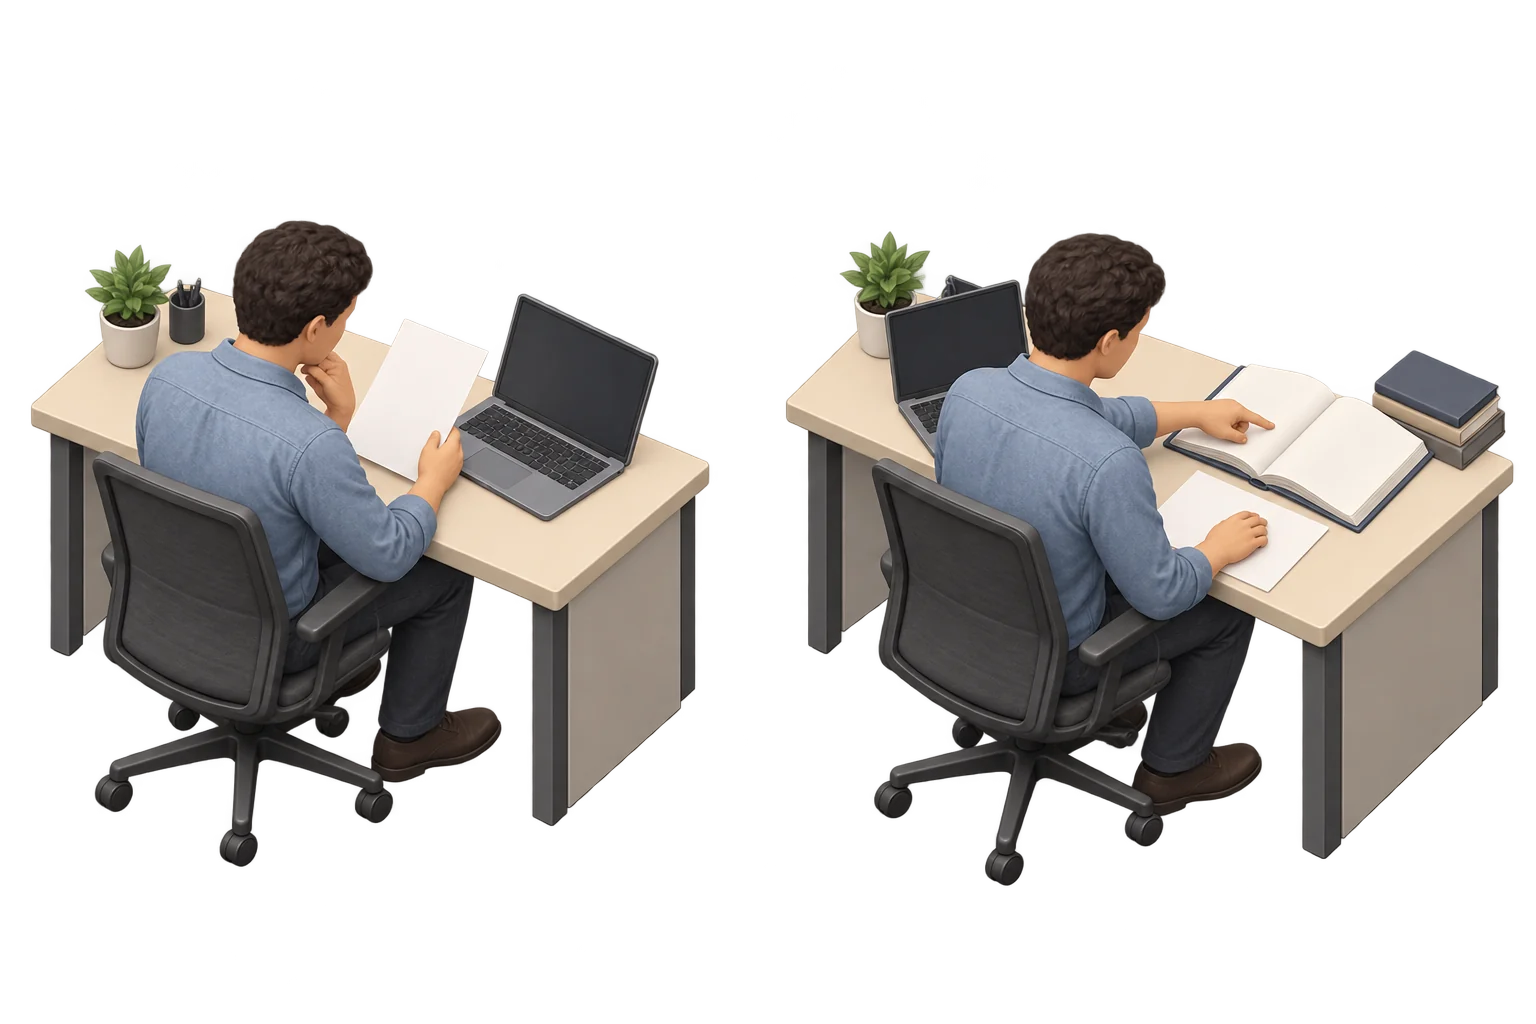
Izquierda: leer una respuesta natural
Las explicaciones detalladas y los nombres de documentos específicos no pueden utilizarse por sí solos para determinar que existe respaldo fáctico.
Derecha: cotejar con el original
Abra la fuente y verifique si hay partes que respalden su respuesta y si los números, fechas y nombres de las personas coinciden.
Incluso si existe una fuente, no necesariamente respalda la respuesta. Si no podemos encontrar ninguna evidencia, no la trataremos como un hecho y verificaremos otros materiales.
Esta es una ilustración explicativa que ha sido reemplazada por un escritorio y materiales.
La naturalidad del texto y la exactitud de los hechos son dos cosas diferentes.
Un LLM calcula una salida adecuada al contexto. Un tono seguro o una explicación detallada no bastan para demostrar que existe fundamento. Que el modelo haya usado búsquedas o cálculos también depende del funcionamiento de la aplicación.
Verifique la evidencia abriéndola
Verifique las partes relevantes de los documentos, números, fechas, nombres de personas, etc. Incluso si existe una cita, no necesariamente respalda la respuesta. Si dices que no lo sabes, lo incluiremos en tu evaluación.
Por ejemplo:Crear un nombre de documento probable
Cuando se le pregunte: "¿De dónde sacó esta función?", es posible que encuentre una referencia a un manual que no existe. Incluso si el nombre del documento es específico, verifique si el original está disponible.
Precauciones
La búsqueda, RAG, aprendizaje adicional, etc. ayudan a reducir los errores, pero no garantizan la corrección. Incluso si reduce la variación en la producción, las respuestas incorrectas pueden corregirse.
En AI Inc.
La evaluación externa es un material que permite leer qué se ha confirmado y en qué medida. Los resultados de evaluación y alto rendimiento por sí solos no garantizan la seguridad para todas las aplicaciones.
Si el punto de referencia es alto, ¿puede proporcionarlo tal como está?
Un punto de referencia es una evaluación para comparar el desempeño en una tarea fija. Es necesario confirmar por separado si es útil en la aplicación real del cliente.
Si el punto de referencia es alto, ¿puede proporcionarlo tal como está?
Un punto de referencia es una evaluación para comparar el desempeño en una tarea fija. Es necesario confirmar por separado si es útil en la aplicación real del cliente.
Un punto de referencia es una evaluación para comparar el desempeño en una tarea fija. Es necesario confirmar por separado si es útil en la aplicación real del cliente.
Evaluación: desafíos comunes y aplicaciones prácticas
Consulte los problemas comunes y las condiciones laborales por separado.
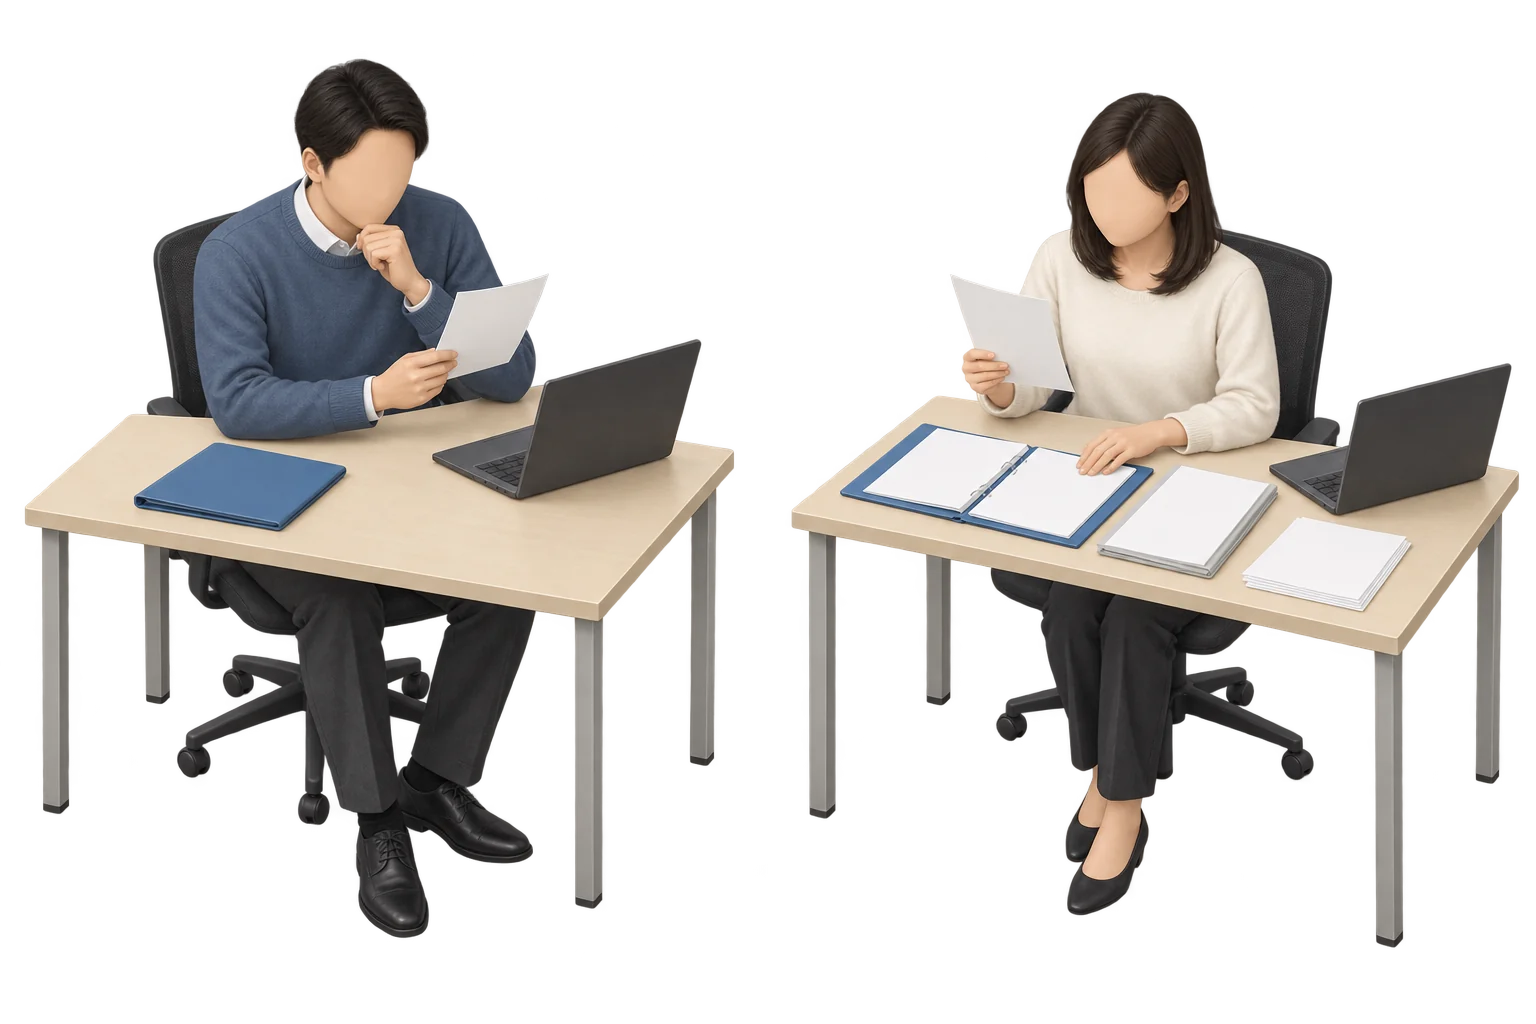
Izquierda: leer resultados de tareas comunes
Compare el desempeño de los modelos utilizando las mismas preguntas y condiciones de puntuación. Lea la hoja de resultados para comprobar el alcance de las tareas que intentó.
Derecha: probar en las condiciones de uso
Utilice materiales y preguntas reales para confirmar que se mantienen los números y plazos requeridos. También veremos la velocidad de respuesta y el costo.
Los resultados comparativos por sí solos no pueden utilizarse para concluir que son útiles para cualquier trabajo. Primero decidimos las condiciones que se adaptan a la aplicación del cliente y luego las verificamos incluso después de cambiar de modelo y material.
El papel y las carpetas son metáforas para describir resultados de tareas comunes y confirmación en aplicaciones del mundo real. Izquierda y derecha no son el orden de los procesos y ninguno de los dos garantiza el éxito, la seguridad o la entrega. El número de personas y materiales no representa el número de pruebas.
Probar en condiciones próximas al trabajo real
Compare el idioma utilizado, los materiales utilizados, la extensión de las preguntas, el formato requerido, etc. Incluya ejemplos que no haya utilizado en sus estudios o preguntas que no pueda responder.
Evaluar todo el servicio, además del modelo
Comprobamos no sólo la tasa de respuesta correcta y su justificación, sino también la velocidad de respuesta, el coste, los fallos de búsqueda, el funcionamiento de la herramienta, etc. Si sólo nos fijamos en la puntuación media, es posible que se pasen por alto los modelos que son débiles en determinadas condiciones.
Por ejemplo:Incluso si eres bueno resumiendo, es posible que aún te pierdas los números.
Incluso un resumen fácil de leer será inútil si falta el importe de la factura o la fecha límite. Decida primero qué debe quedar y evalúelo en esas condiciones.
Precauciones
La evaluación refleja lo observado en las condiciones y el momento de la prueba. No garantiza resultados para usos que no se han evaluado. Comprueba de nuevo los resultados después de modificar el modelo o los documentos.
En AI Inc.
Esto lleva a la razón por la cual la evaluación del modelo, la publicación, el suministro anticipado y la migración de clientes se juzgan por separado. Veamos los resultados de las pruebas junto con los resultados reales de suministro y ventas.
¿Cómo se relacionan la GPU, la memoria y la velocidad de respuesta?
Los LLM realizan muchos cálculos y emplean equipos como las GPU, eficaces en procesamiento paralelo. La memoria, el uso simultáneo y la longitud de las respuestas también influyen en el servicio.
¿Cómo se relacionan la GPU, la memoria y la velocidad de respuesta?
Los LLM realizan muchos cálculos y emplean equipos como las GPU, eficaces en procesamiento paralelo. La memoria, el uso simultáneo y la longitud de las respuestas también influyen en el servicio.
Los LLM realizan muchos cálculos y emplean equipos como las GPU, eficaces en procesamiento paralelo. La memoria, el uso simultáneo y la longitud de las respuestas también influyen en el servicio.
Inferencia: espera y volumen de procesamiento
Existe una diferencia entre responder una solicitud rápidamente y manejar muchas solicitudes.
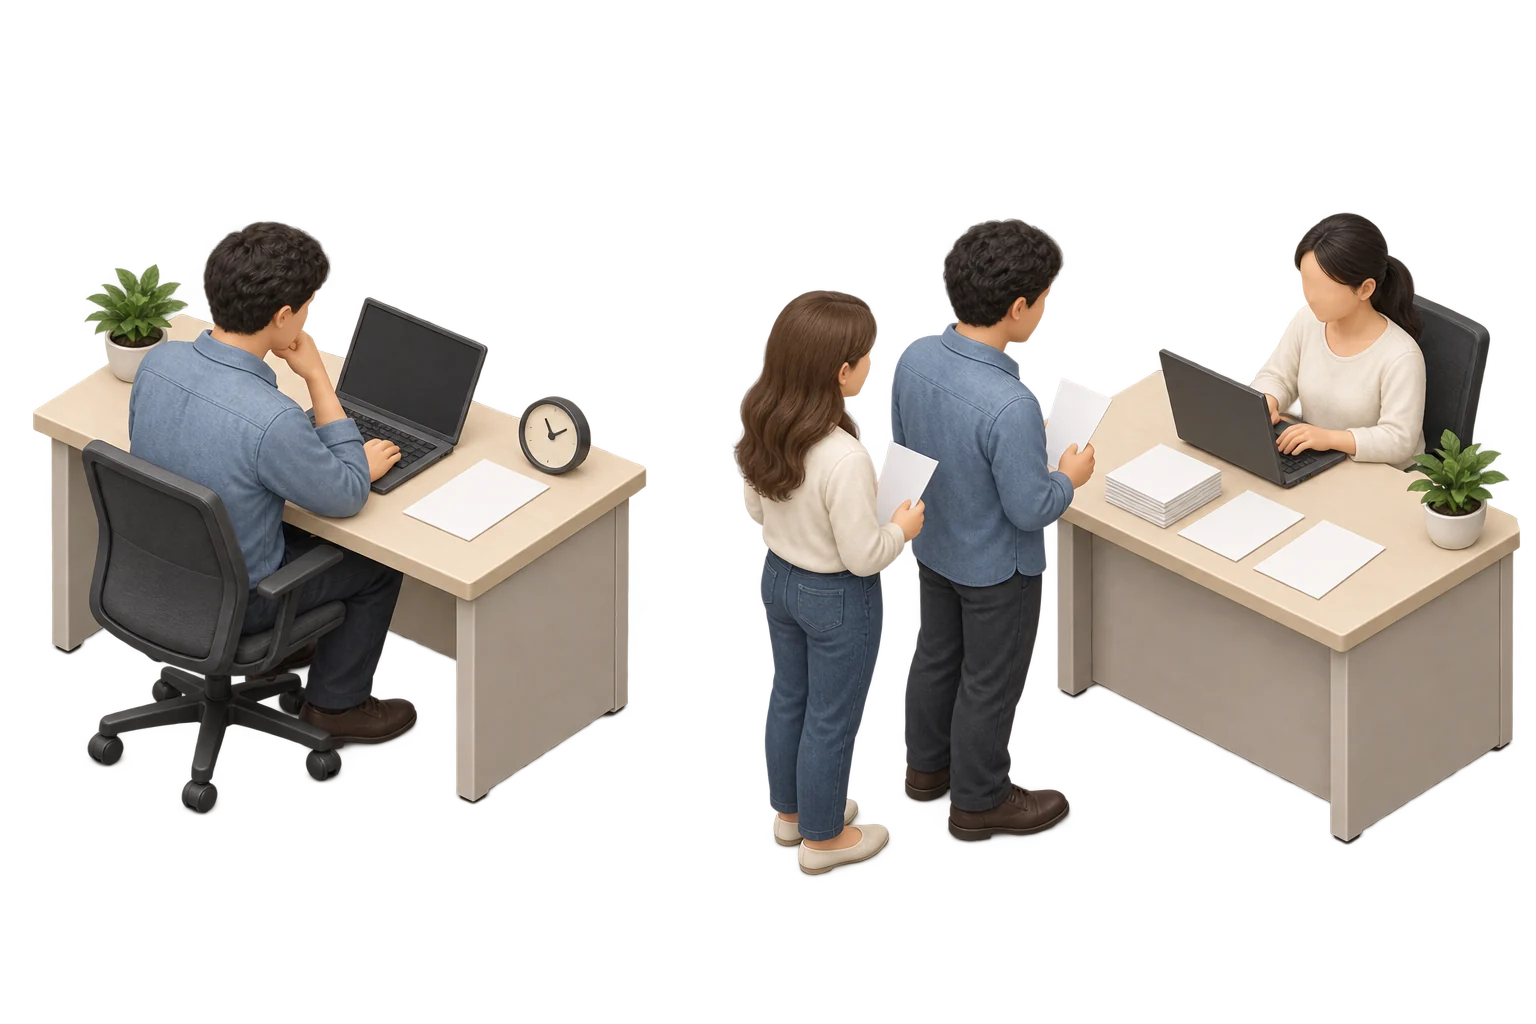
Izquierda: espera de una solicitud
La latencia es el tiempo entre realizar una solicitud y recibir una respuesta. A veces medimos la primera letra y la finalización de la respuesta.
Derecha: procesamiento por unidad de tiempo
El rendimiento es la cantidad de solicitudes o tokens que se pueden procesar en un período de tiempo determinado. También comprobaremos el volumen de procesamiento y el tiempo de espera cuando aumente el número de personas que utilizan el servicio al mismo tiempo.
Incluso si es rápido cuando lo usa una sola persona, verifique el tiempo de espera y el volumen de procesamiento por separado cuando esté lleno de gente. Las condiciones varían no sólo según la potencia de procesamiento de la GPU, sino también según la memoria, el uso concurrente y la duración de la respuesta.
Esta es una ilustración explicativa que ha sido reemplazada por un escritorio y materiales.
La velocidad de cálculo y la cantidad de información que se puede almacenar son dos cosas diferentes.
La GPU es responsable de los cálculos y la memoria es donde se almacena el modelo y la información que se procesa. Será más fácil de entender si piensas en el espacio que puedes poner en tu escritorio de trabajo y la velocidad a la que puedes trabajar. Esta analogía es una explicación del rol y no calcula el desempeño real a partir del número de escritorios.
Vea el tiempo de espera para una única respuesta y la cantidad total de procesamiento
La latencia es el tiempo que lleva esperar una solicitud y el rendimiento es la cantidad que se puede procesar en un período de tiempo determinado. El tiempo que lleva recibir la primera letra y el tiempo que lleva obtener la respuesta larga completa también es diferente. Al medir el uso simultáneo y la duración de las respuestas, resulta más fácil comparar las condiciones de provisión.
| Métrica | Qué observar |
|---|---|
| Latencia | El tiempo de espera para que una única solicitud reciba una respuesta. Distinga entre la primera letra y la finalización de la oración completa. |
| Rendimiento | Solicitudes o tokens procesados por unidad de tiempo. |
| Memoria | Capacidad para alojar modelos e información en proceso. |
| Coste | Costo del equipo y operación necesarios. Varía según modelo y condiciones de prestación. |
Por ejemplo:Rápido para uno; con demanda, hay espera
El simple hecho de saber qué tan rápido es cuando lo usa una persona no indica lo que puede proporcionar cuando lo usan 100 personas al mismo tiempo. Mide tanto el tiempo de espera como la cantidad de procesamiento que se puede realizar en un período de tiempo determinado.
En AI Inc.
Verificamos no solo la cantidad de GPU, sino también su estado de entrega y funcionamiento, así como la distribución de la investigación, el aprendizaje y la inferencia. La métrica de suministro de un juego no es un valor de conversión a la cantidad real de tokens o al tiempo de espera.
¿Qué es la IA multimodal?
Es una IA que maneja múltiples tipos de información como texto, imágenes y audio. “Modalidad” se refiere al tipo de información. Las entradas y salidas que se pueden manejar varían según el modelo.
¿Qué es la IA multimodal?
Es una IA que maneja múltiples tipos de información como texto, imágenes y audio. “Modalidad” se refiere al tipo de información. Las entradas y salidas que se pueden manejar varían según el modelo.
Es una IA que maneja múltiples tipos de información como texto, imágenes y audio. “Modalidad” se refiere al tipo de información. Las entradas y salidas que se pueden manejar varían según el modelo.
Multimodal: texto, imagen y audio
Utilice diferentes tipos de información juntos.
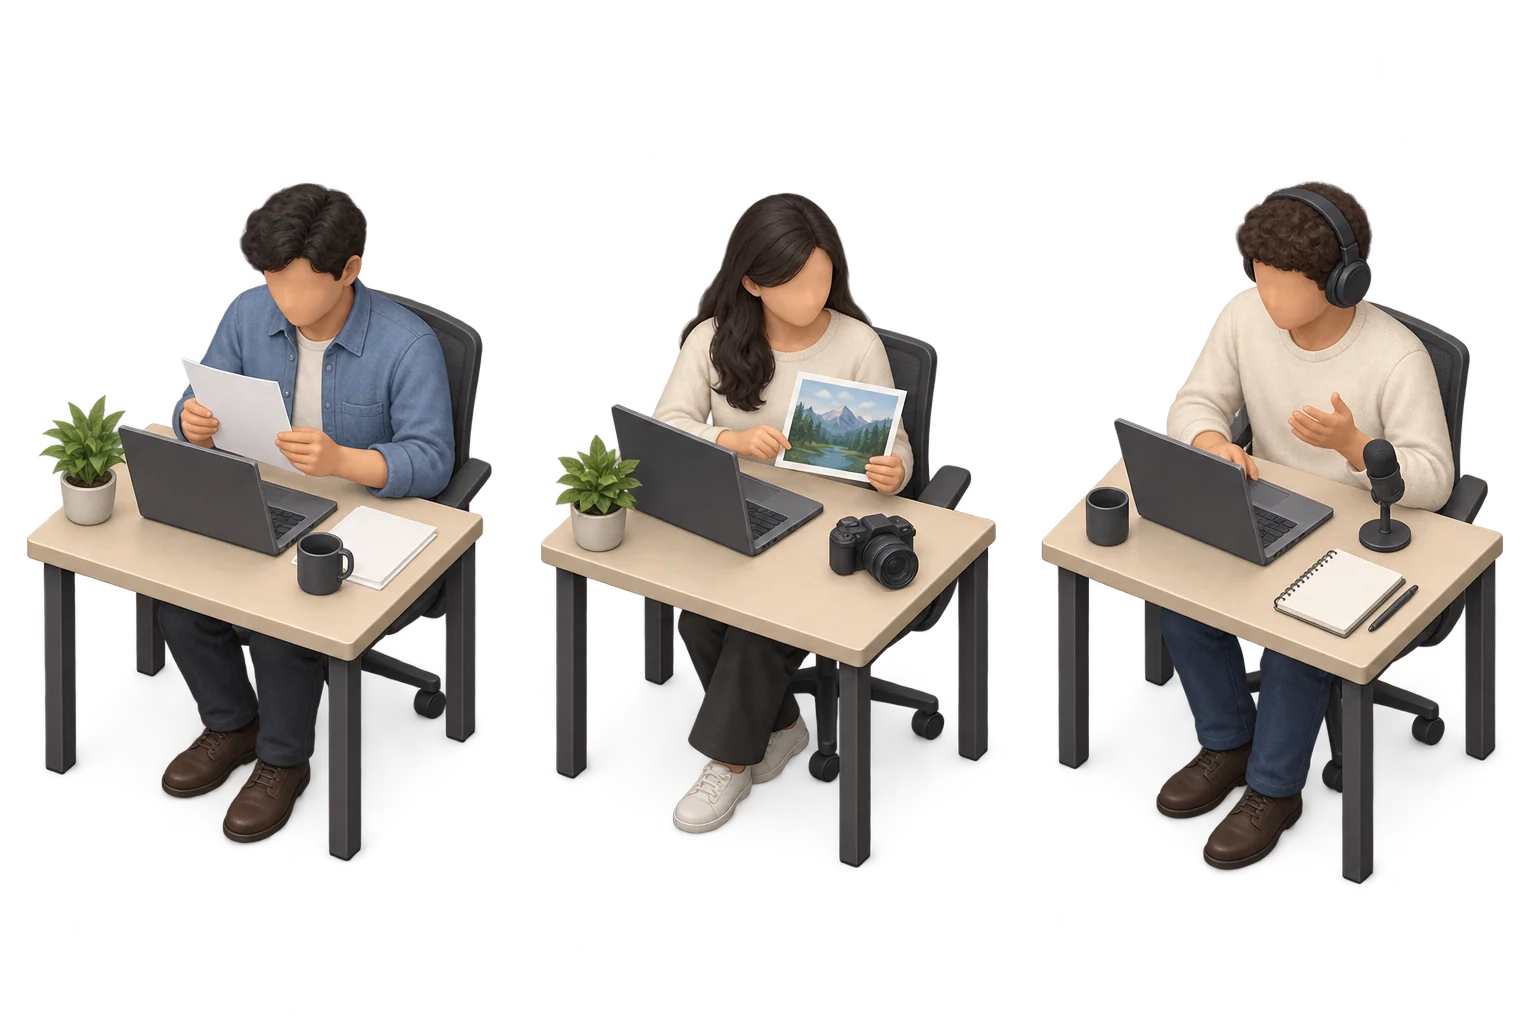
Izquierda: comunicar con texto
Ingrese texto como preguntas, explicaciones y materiales.
Centro: usar también imágenes
Una forma de utilizar esto es combinar texto e imágenes para explicar lo que se muestra.
Derecha: usar también audio
En modelos compatibles, puedes ingresar tu voz y hacer preguntas sobre el contenido.
Las entradas y salidas que se pueden manejar varían según el modelo. El hecho de que pueda ingresar una imagen no significa que pueda generar una imagen. Verifique los resultados cuidadosamente para detectar imágenes oscuras o audio difícil de escuchar.
Esta es una ilustración explicativa que ha sido reemplazada por un escritorio y materiales.
Combina diferentes tipos de información
Explica lo que hay en la imagen en texto, o escucha el audio y responde lo que hay en la imagen. Un modelo que puede ingresar imágenes no necesariamente también genera imágenes.
Las condiciones de entrada también cambian el resultado
El texto pequeño, las imágenes oscuras y las voces difíciles de escuchar pueden provocar un reconocimiento erróneo. Incluso si puede manejar varios datos, debe verificar la exactitud de cada uno de ellos.
Por ejemplo:Preguntar cómo actuar adjuntando una foto
Esta es una forma de hacer coincidir una foto de una máquina con el texto "¿Qué es este botón?" Si el botón no se puede leer en la foto, es posible que el modelo adivine incorrectamente.
En AI Inc.
Al elegir un campo o mercado de investigación, esto le ayudará a considerar si sus clientes solo necesitan texto o si también necesitan imágenes y audio. Consulta la descripción del juego para conocer las funciones compatibles.
¿Cuál es la diferencia entre un agente de IA y una IA que responde?
El agente de IA selecciona los pasos hacia un objetivo y utiliza búsquedas, herramientas, etc. para continuar con la tarea. La capacidad de responder oraciones y la autoridad para actuar son dos cosas diferentes.
¿Cuál es la diferencia entre un agente de IA y una IA que responde?
El agente de IA selecciona los pasos hacia un objetivo y utiliza búsquedas, herramientas, etc. para continuar con la tarea. La capacidad de responder oraciones y la autoridad para actuar son dos cosas diferentes.
El agente de IA selecciona los pasos hacia un objetivo y utiliza búsquedas, herramientas, etc. para continuar con la tarea. La capacidad de responder oraciones y la autoridad para actuar son dos cosas diferentes.
IA que responde y agentes de IA
Separe la lectura de la propuesta del trabajo con las herramientas.
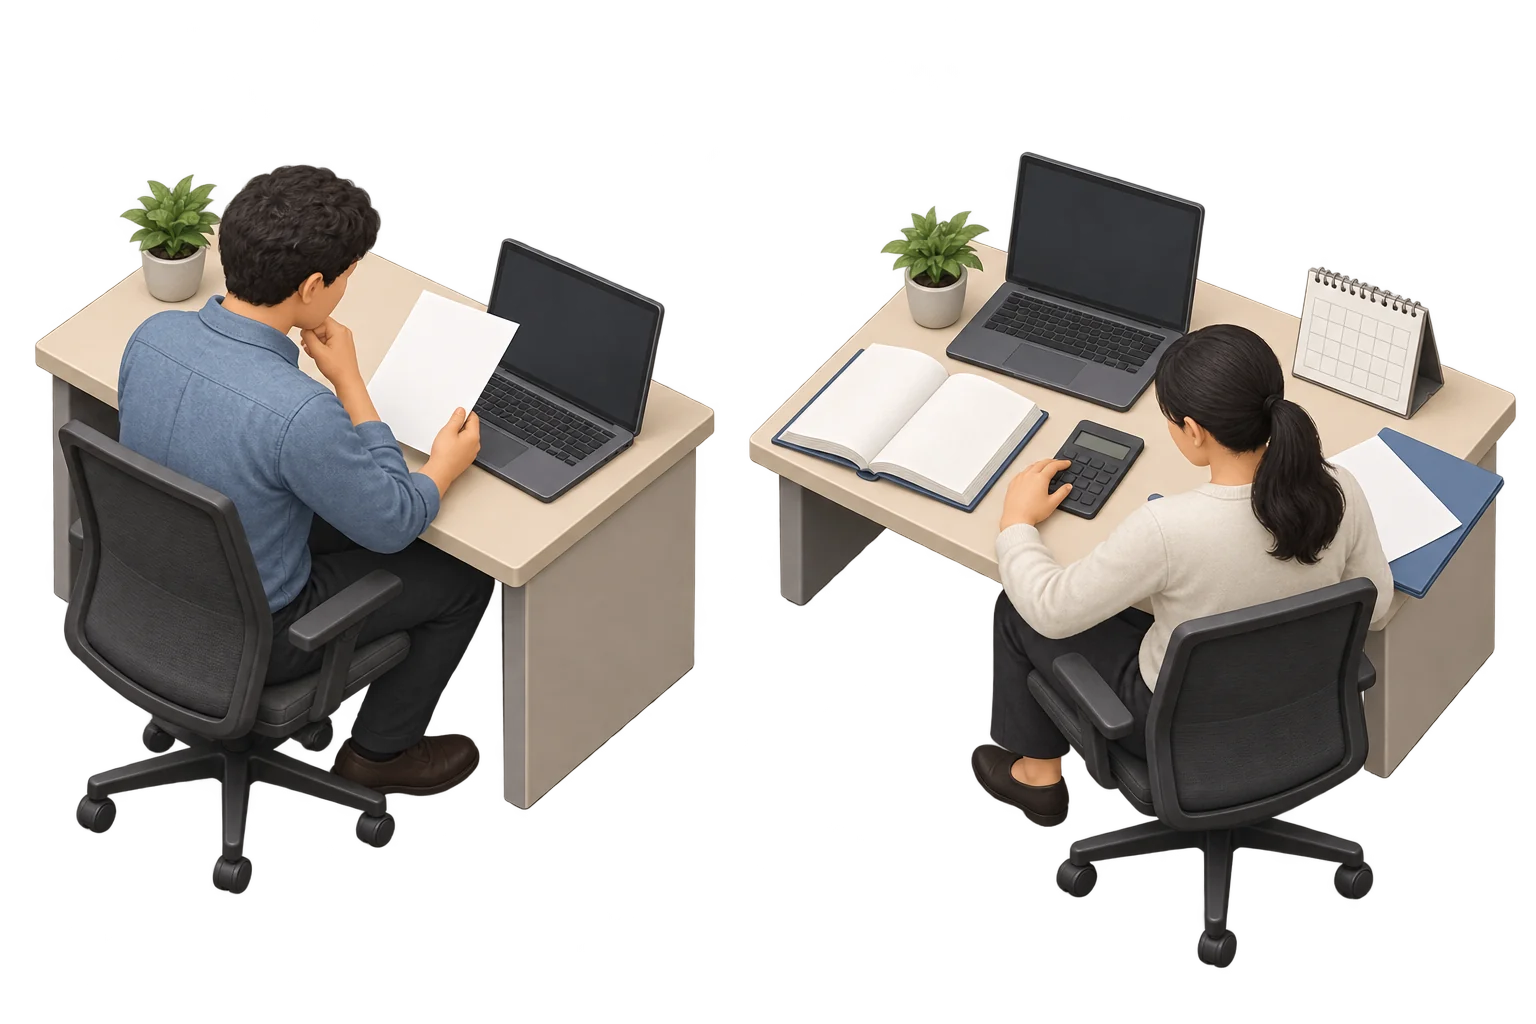
Izquierda: recibir una propuesta escrita
Proponer por escrito el horario del candidato, etc. El solo hecho de leer la propuesta no cambiará tu reserva ni nada.
Derecha: usar herramientas y comprobar resultados
Seleccione los pasos según su propósito, continúe con el trabajo utilizando herramientas como búsqueda y cálculo, y verifique los resultados.
Tener una herramienta conectada y tener la autoridad para operarla son dos cosas diferentes. Para enviar, comprar, eliminar, etc., decida el alcance del permiso y las condiciones de aprobación.
Esta es una ilustración explicativa que ha sido reemplazada por un escritorio y materiales.
Comprueba los resultados utilizando herramientas.
Combina operaciones como buscar la información que necesitas, calcular y actualizar registros. Incluso cuando se utiliza LLM, las operaciones reales se realizan a través de herramientas y sistemas conectados.
Definir el alcance de las acciones
El impacto es diferente para operaciones como simplemente leer y operaciones como enviar, comprar o eliminar. Diseñaremos las herramientas que se pueden utilizar, las operaciones que requieren aprobación, las formas de detenerlas a mitad de camino y los registros de ejecución.
Por ejemplo:Proponer una cita o confirmar una reserva
Si simplemente sugiere un posible horario por escrito, su reserva no se modificará. Una vez que se conecte al sistema de reservas y les dé permiso para confirmar, podrán tomar medidas.
Precauciones
El alto rendimiento de generación de texto por sí solo no garantiza que la tarea que se le ha confiado se completará de forma segura. Evaluar todo el flujo, incluidas las herramientas.
En AI Inc.
Los privilegios de publicación y ejecución de modelos son decisiones independientes. Incluso en los juegos, lea el alcance de la evaluación, supervisión y condiciones de accidente antes de decidir el alcance del comportamiento aceptable.
Redes neuronales y Transformer6
Desde calcular números hasta escribir oraciones. Fácil de entender con 6 ilustraciones.
MODEL / MECHANISM
Del cálculo numérico,
hasta convertirse en una frase.
Primero, pasemos a pequeños cálculos y luego pasemos a los mecanismos para manejar oraciones. Sigue el modelo invisible en 6 pasos.
Los cálculos son pequeños modelos para ilustración. Las operaciones en esta página no cambiarán el juego ni guardarán el contenido.
¿Qué calcula una red neuronal?
Combina los valores de entrada con los pesos determinados por el aprendizaje y los convierte en predicciones a través de capas. Una vez que comprenda un cálculo, podrá comprender cómo ver el modelo más grande.
¿Qué calcula una red neuronal?
Combina los valores de entrada con los pesos determinados por el aprendizaje y los convierte en predicciones a través de capas. Una vez que comprenda un cálculo, podrá comprender cómo ver el modelo más grande.
Combina los valores de entrada con los pesos determinados por el aprendizaje y los convierte en predicciones a través de capas. Una vez que comprenda un cálculo, podrá comprender cómo ver el modelo más grande.
De la entrada a la predicción.
3 a la izquierda, 4 en el medio y 2 a la derecha. Este es un material didáctico tridimensional que combina números capa por capa.
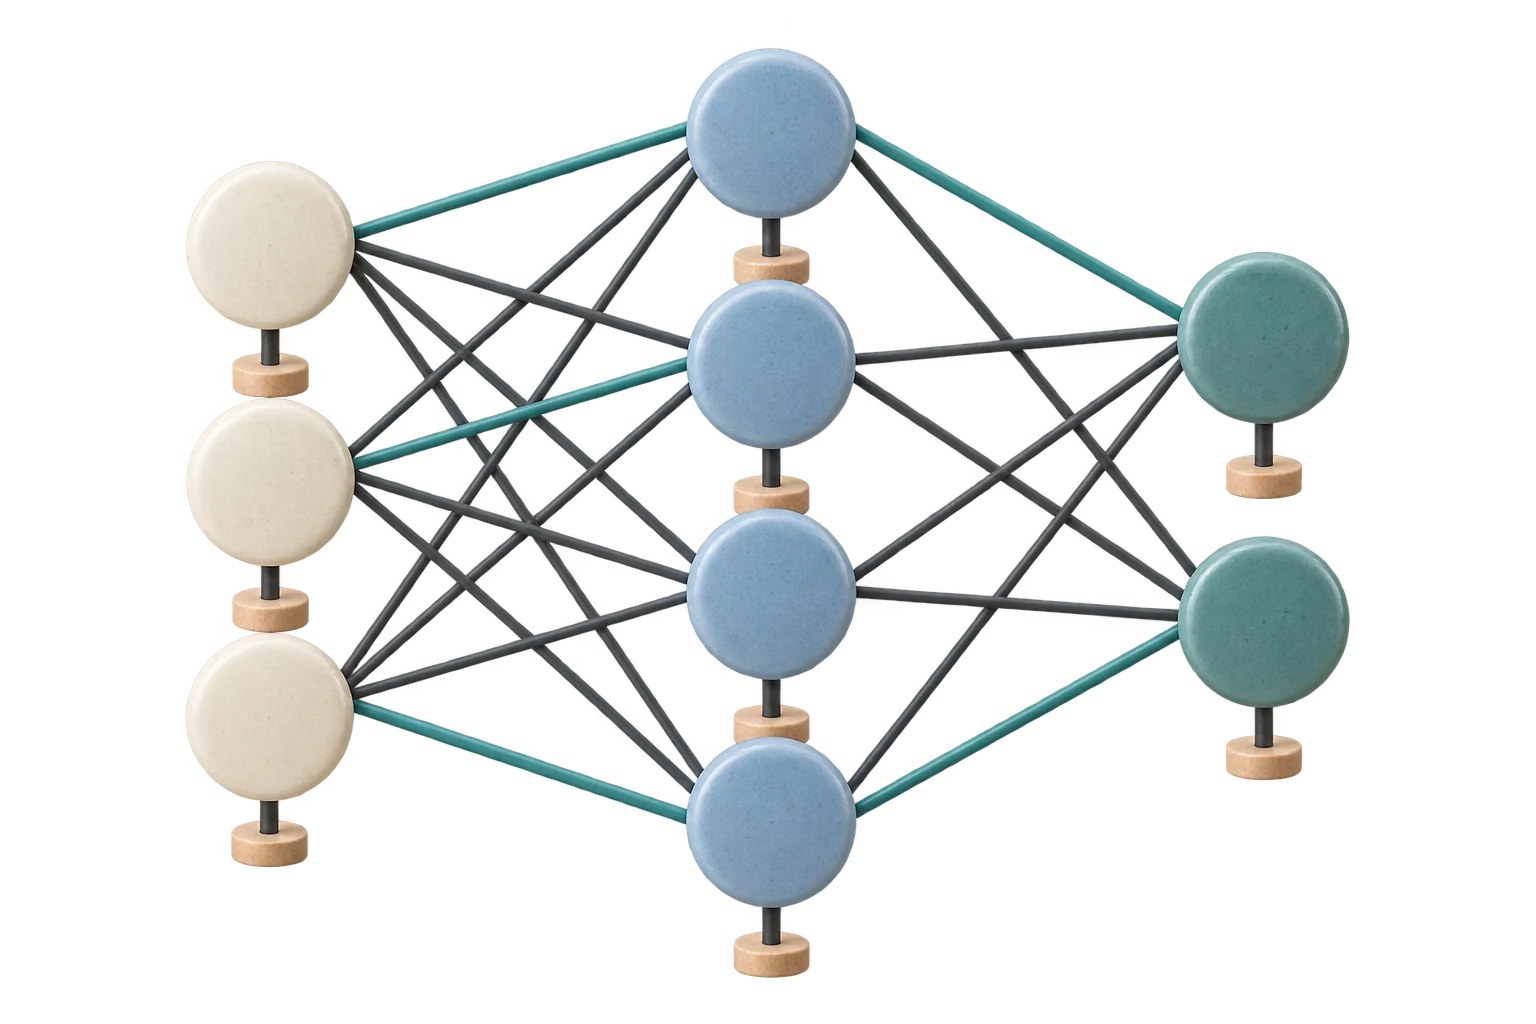
Izquierda: recibir la entrada
Convierta fotografías, texto, etc. en números que el modelo pueda manejar.
Centro: combinar y transformar
Los pesos, sesgos y funciones de activación transforman los valores en la siguiente representación.
Derecha: convertir en una predicción
Cree resultados que se ajusten al trabajo. Incluso en esta etapa, no se garantizan respuestas correctas.
Primero, sigamos el cálculo de un nodo usando el siguiente ejemplo. También puede comprobar los efectos de los pesos negativos y ReLU.
Esta es una ilustración explicativa que muestra la disposición de las capas. El número, color y grosor de las líneas no indican conexiones ni pesos en el modelo real.
Capa de entrada: representar la información con números
Se proporcionan valores que el modelo pueda procesar: píxeles en una imagen o representaciones de tokens en un texto, por ejemplo. La preparación de la entrada depende del tipo de datos.
Capa oculta: recombinar los valores
Cada nodo multiplica los valores de la capa anterior por sus pesos, los suma y añade un sesgo. Aplica una función de activación al resultado y lo pasa a la siguiente capa. Las capas situadas entre la entrada y la salida se llaman capas ocultas.
Pesos y sesgos: valores que se ajustan durante el entrenamiento
El peso cambia el efecto de cada entrada y, si es un valor negativo, funcionará en una dirección negativa. El sesgo cambia el resultado de la suma. Un solo número no contiene conocimientos o hechos específicos.
Funciones de activación: desde una simple suma hasta relaciones complejas
ReLU convierte los valores negativos en 0 y deja pasar sin cambios los valores iguales o superiores a 0. Apilar capas que solo multiplican por pesos y suman sigue siendo equivalente a un único cálculo del mismo tipo. Introducir transformaciones no lineales entre ellas permite representar relaciones complejas.
Capa de salida: adaptar el resultado a la tarea
Convierta la expresión final en puntos de clasificación, valores predichos, etc. No todos los números de nodos son probabilidades. El siguiente ejemplo también muestra los resultados calculados.
Experimenta con un solo nodo
Las entradas se mantienen fijas en 1 y 2. ¿Cómo cambian la suma y la salida al modificar los pesos o el sesgo?
- 01 / Multiplicar y sumar
1 × 0.6 + 2 × (−0.2) + 0.1
Multiplicar por los pesos, sumar y añadir el sesgo.
- 02 / Aplicar ReLU
max(0, 0.3)
Si es negativo, es 0. Si es mayor o igual a 0, se pasa tal cual.
Total 0.3→Salida 0.3
Prueba: al cambiar el peso 1 a −0,6, la suma es −0,9 y la salida es 0. Esta salida no es una probabilidad ni una tasa de aciertos.
Por ejemplo:Calcular un nodo
Si las entradas son 1 y 2, los pesos son 0,6 y -0,2 y el sesgo es 0,1, entonces 1 x 0,6 + 2 x (-0,2) + 0,1 = 0,3. Cuando pasa por ReLU, sigue siendo 0,3. Movamos los pesos y verifiquemos el resultado cuando la suma se vuelva negativa.
Precauciones
El nombre neurona se inspiró en el cerebro. Lo que estamos tratando aquí es un cálculo numérico y no es una reproducción directa de cómo funciona el cerebro.
El esquema explica las capas de entrada, ocultas y de salida. Las redes neuronales también pueden tener otras arquitecturas, como convoluciones para imágenes o Transformer.
En AI Inc.
Los datos, el diseño de modelos y los recursos computacionales conducen a razones relacionadas con los resultados y los costos del aprendizaje. Este botón de ajuste de ayuda es para aprender cómo funciona y no cambia el modelo del juego ni los guardados.
¿Qué valores cambian al aprender?
Mida la discrepancia entre la predicción y la respuesta correcta y ajuste los pesos poco a poco para reducir la discrepancia. Separemos la lectura de la respuesta de la actualización de los números en el modelo.
¿Qué valores cambian al aprender?
Mida la discrepancia entre la predicción y la respuesta correcta y ajuste los pesos poco a poco para reducir la discrepancia. Separemos la lectura de la respuesta de la actualización de los números en el modelo.
Mida la discrepancia entre la predicción y la respuesta correcta y ajuste los pesos poco a poco para reducir la discrepancia. Separemos la lectura de la respuesta de la actualización de los números en el modelo.
① Propagación hacia delante: obtener una predicción
Calcule desde la entrada hasta la salida utilizando los pesos actuales. Esta es la propagación hacia adelante. En esta etapa, no hemos determinado si esto se acerca a la respuesta correcta o no.
② Medir la pérdida: definir el error según el objetivo
Compare la predicción y la verdad fundamental para aprender utilizando una función de pérdida. El siguiente ejemplo utiliza la diferencia al cuadrado. Al predecir el siguiente token en una oración, elija una medida que se adapte al trabajo, como la entropía cruzada, que utiliza la probabilidad asignada al token correcto.
③ Retroceder: calcular la dirección del cambio
La retropropagación calcula cómo cambia la pérdida al variar ligeramente cada peso. Esa sensibilidad es el gradiente. Recorre los cálculos desde la salida hacia la entrada y permite ajustar varias capas.
④ Actualizar: decidir también el tamaño del paso
Actualice los pesos utilizando el gradiente y la tasa de aprendizaje. La tasa de aprendizaje es del tamaño de un paso. Si es demasiado grande, las pérdidas pueden aumentar. En realidad, lo repetimos con muchos ejemplos y comprobamos el rendimiento incluso con ejemplos que no se utilizan para aprender.
Actualizar el peso paso a paso
Fijado en 2 entradas, 1 respuesta correcta y tasa de aprendizaje de 0,1. Es un modelo con un solo peso: predicción = 2 x peso, pérdida = (predicción - 1)².
Actualizar 0·Predicción 0.2·Pérdida 0.64
Gradiente del ejemplo = 4 × (2 × peso − 1)
Nuevo peso = peso actual - tasa de aprendizaje x gradiente
0.1 − 0.1 × (−3.2) = 0.42
En la primera actualización, generamos un gradiente negativo, por lo que el peso aumenta.
| Número de actualizaciones | Peso | Predicción | Pérdida |
|---|---|---|---|
| 0 | 0.1 | 0.2 | 0.64 |
Este es un material didáctico adaptado a un único ejemplo de aprendizaje. En una red neuronal real, los gradientes de muchos pesos se determinan mediante retropropagación y la evaluación se realiza incluso en datos que no se utilizan para el aprendizaje.
Por ejemplo:Acercar la predicción 0,2 al valor correcto 1
Si la entrada es 2 y el peso es 0,1, la predicción es 0,2. La pérdida es (0,2−1)²=0,64. En este ejemplo, si configuramos la tasa de aprendizaje en 0,1, los pesos después de la primera actualización serán 0,42, la predicción será 0,84 y la pérdida será 0,0256. Puede seguir los cambios en el mismo ejemplo uno por uno utilizando las operaciones siguientes.
Precauciones
El ejemplo de cálculo es un modelo con un solo peso y un ejemplo de entrenamiento. No reproduce la retropropagación de toda la red neuronal.
Que la pérdida baje en este ejemplo simple no garantiza entrenar con éxito un modelo grande ni responder bien a preguntas nuevas. También hay que vigilar el sobreajuste: mejorar solo en los ejemplos usados durante el entrenamiento.
En AI Inc.
Esto lleva a separar la finalización del estudio, el aprendizaje real del modelo y la evaluación una vez finalizado. En los juegos, la próxima inversión se determina comparando las predicciones antes del aprendizaje y los resultados una vez finalizado.
¿Cómo se convierten las oraciones en números?
Divida el texto en tokens y use ID para convertirlos en secuencias numéricas. Combinaremos esa expresión numérica con la información circundante.
¿Cómo se convierten las oraciones en números?
Divida el texto en tokens y use ID para convertirlos en secuencias numéricas. Combinaremos esa expresión numérica con la información circundante.
Divida el texto en tokens y use ID para convertirlos en secuencias numéricas. Combinaremos esa expresión numérica con la información circundante.
Tokens e ID: definir las unidades
La tokenización divide el texto en pequeñas unidades y asigna una identificación a cada una. ID es un número de identificación y su tamaño no indica la fuerza del significado de la palabra. No siempre tienen una correspondencia uno a uno con las palabras y caracteres japoneses.
Embedding: del ID a un vector aprendido
El ID permite buscar un vector en la tabla de embeddings. Un vector es una secuencia de valores numéricos. Sus componentes no tienen necesariamente un significado interpretable, como «amabilidad» o «inteligencia».
Información posicional: transmitir el orden al cálculo
Existe una diferencia entre "la empresa crea el modelo" y "el modelo crea la empresa". Transformer también utiliza información de posición y distancia relativa. La forma de insertarlo varía según el diseño.
Expresión en contexto: cambios en combinación con el entorno.
Partiendo del embedding inicial, cada capa combina la representación con las de su entorno. Incluso un mismo token cambia su representación intermedia según el contexto. Sustituir los ID no basta para completar la interpretación del texto.
De números de palabras a secuencias numéricas
Mire los "modelos de empresa" en la división hipotética. Usando la ID como pista, extraiga el vector de la tabla incrustada.
Puede leer la tabla moviéndola hacia la izquierda y hacia la derecha.
| Posición | Token | ID | Embedding de tres componentes |
|---|---|---|---|
| 1 | Empresa | 120 | [0.2, −0.4, 0.7] |
| 2 | el | 8 | [−0.1, 0.3, 0.2] |
| 3 | Modelo | 305 | [0.6, 0.1, −0.2] |
| 4 | el | 9 | [0.1, −0.2, 0.4] |
- Obtener el embedding
Preparar la primera representación numérica del token.
- Usar también información de posición
Transmita el orden de las palabras y la distancia a los cálculos de una manera que se adapte al diseño.
- Incorporar información del contexto
La representación cambia con el contexto en cada capa.
ID305 no es "más significativo" que ID120. La división real, el número de dimensiones y los valores numéricos varían según el modelo, y no necesariamente existe un significado legible por humanos para cada componente del vector.
Por ejemplo:Leer «modelo» junto a su contexto
"Evaluar un modelo de IA" y "exhibir un modelo arquitectónico" tienen términos diferentes. El cálculo implica incorporar información circundante en la representación del token y abordar el contexto en el que se utiliza.
Precauciones
La división, el ID y el vector de 3 componentes en el diagrama son ejemplos ficticios para su explicación. La partición real, la cantidad de dimensiones y los números varían según el modelo.
En AI Inc.
Al elegir la longitud del contexto y el uso de datos, es útil considerar la cantidad de información que se va a manejar y la carga computacional que implica usar esa información.
¿Qué componentes forman un Transformer?
Attention combina información entre posiciones y Feed-Forward transforma la representación de cada posición. Esta arquitectura de red neuronal apila esos bloques.
¿Qué componentes forman un Transformer?
Attention combina información entre posiciones y Feed-Forward transforma la representación de cada posición. Esta arquitectura de red neuronal apila esos bloques.
Attention combina información entre posiciones y Feed-Forward transforma la representación de cada posición. Esta arquitectura de red neuronal apila esos bloques.
Combinar relaciones. Transformar representaciones.
De arriba a abajo. La tarjeta representa un bloque repetido y los dos cuadros representan un bloque repetido.
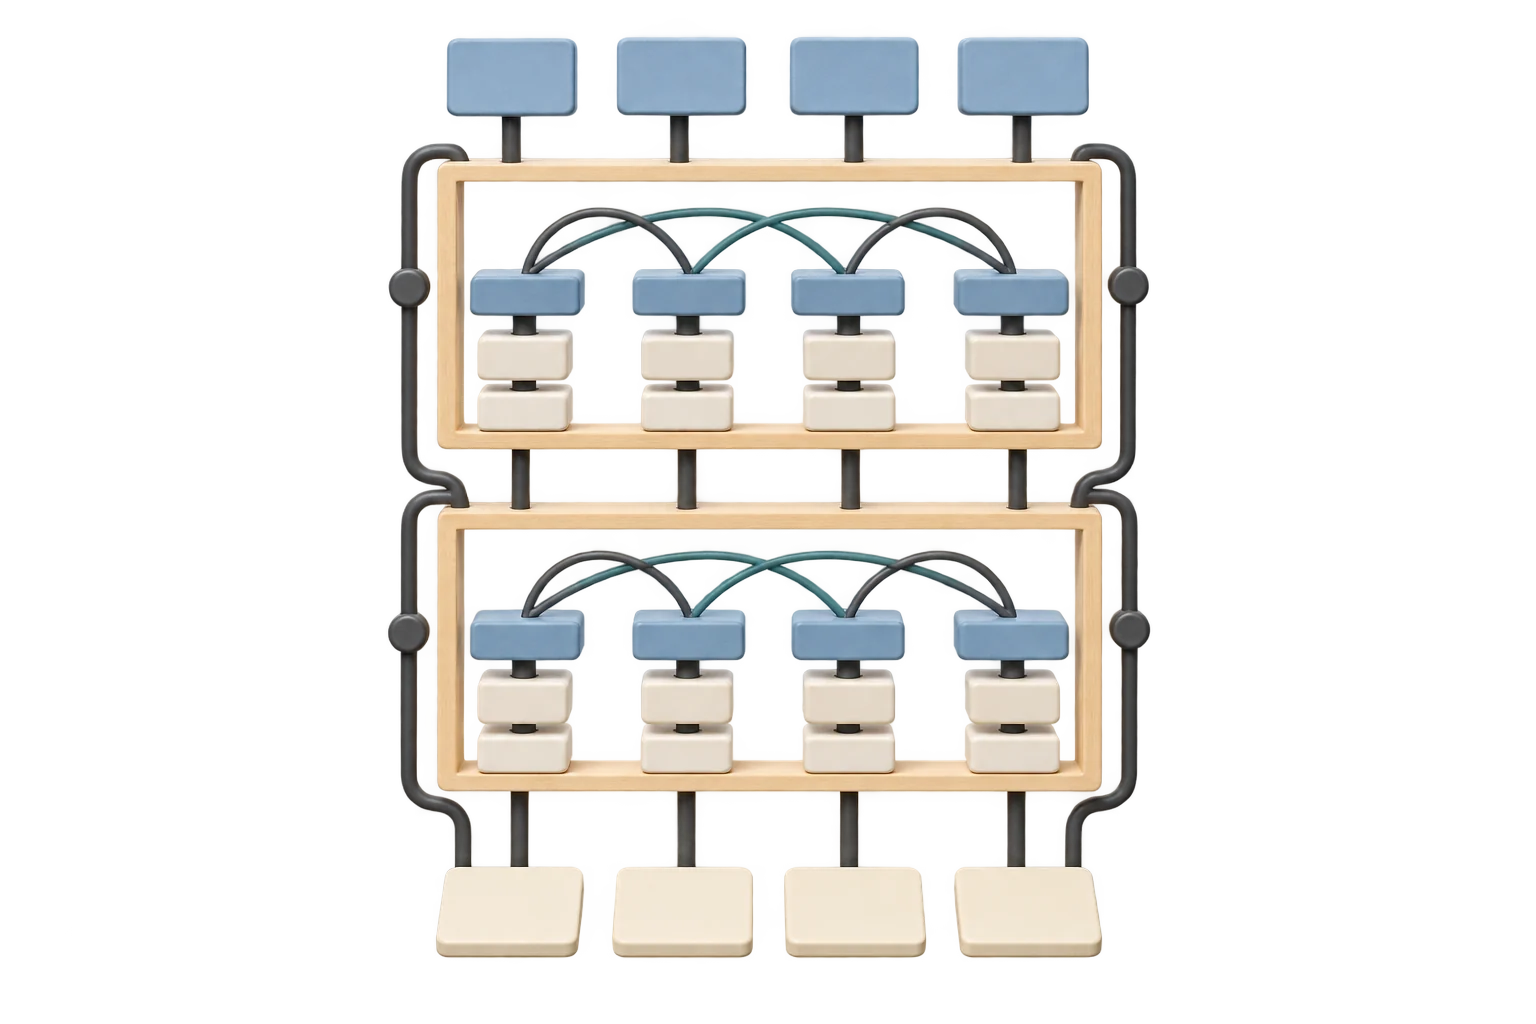
Tarjetas superiores: representación de la entrada
Convierta tokens en números y utilice también información de ubicación.
Dos marcos: apilar bloques
Mezcla la información entre posiciones y convierte la representación de cada posición. El camino lateral es una metáfora que conserva la expresión original.
Tarjetas inferiores: representación procesada
En la generación de oraciones, hay una parte que calcula las puntuaciones y probabilidades de vocabulario.
No se compone solo de Attention. El diagrama siguiente explica el orden exacto de las operaciones y la función de cada parte.
Esta es una ilustración conceptual para aprender el tipo de decodificador. Los 2 bloques y las 4 tarjetas tienen únicamente fines explicativos y no representan un modelo específico ni la estructura general del artículo original.
Attention: incorporar información de otras posiciones
Calcule qué ubicación y cuánta información importar. Una ubicación remota también es candidata. En la estructura que genera oraciones, limite el rango de referencias para evitar ver tokens futuros.
Feed-Forward: transformar cada posición con el mismo cálculo
Tras Attention, se aplica una transformación aprendida a la representación de cada posición. Se procesa cada posición con los mismos parámetros dentro de una capa e incluye transformaciones no lineales.
Conexión residual y normalización: soporte para apilamiento
Una conexión residual es una ruta que agrega la expresión original al resultado recién calculado. La normalización es un cálculo que ajusta la escala de números. Combínalos para formar bloques. La ubicación de la normalización, etc. varía según el diseño.
Salida final: puntuaciones de los candidatos al siguiente token
En la generación, la representación de la última posición se transforma en puntuaciones para todo el vocabulario; Softmax las convierte en probabilidades. De esos candidatos se elige el próximo token. Los pesos de Attention y las probabilidades de salida son valores distintos.
Flujo de tipo decodificador utilizado para la generación de oraciones.
Leer de arriba a abajo. La tarjeta ilustrada corresponde a "expresión numérica" y el marco corresponde a "procesamiento repetido".
- EntradaTokens → embeddings e información posicional
Convierta oraciones en expresiones que puedan usarse en cálculos.
- Repetir bloques Transformer01 / Entre posicionesMulti-Head Self-Attention
Oculta la ubicación futura y mezcla información sobre la ubicación a la que se puede hacer referencia.
También combina conexión residual y normalización.02 / En cada posiciónFeed-Forward(FFN)La misma capa usa los mismos pesos y transforma la representación de cada posición de forma no lineal.
También combina conexión residual y normalización.Los dos bloques de la figura son sólo para explicación. El número real varía según el modelo.
- Parte que genera la salidaExpresión de posición final → Puntuación de vocabulario → Softmax
Calcule la probabilidad del próximo candidato a token consecutivo.
- GenerarSeleccione el siguiente token y agréguelo al contexto
Utilice el contexto agregado para pasar al siguiente candidato.
La conexión residual es una ruta que agrega las expresiones originales y la normalización es un cálculo que ajusta la escala de números. La posibilidad de colocar la normalización antes o después de un componente depende del diseño. Este diagrama no muestra el codificador-decodificador completo en el artículo original.
| Estructura | Alcance y propósito de la lectura. |
|---|---|
| Encoder | Utilice la entrada antes y después para crear expresiones en oraciones. Se utiliza para clasificación y expresiones de búsqueda. |
| Decoder | Generar la continuación utilizando la información hasta cada posición. La configuración ilustrada aquí. |
| Encoder–Decoder | Combine el lado que lee la entrada y el lado que genera la salida. El artículo original trata esta estructura en traducción. |
Por ejemplo:Entender a qué se refiere «eso» por el contexto
En «La empresa publicó un nuevo modelo. Este puede resumir textos», representar «este» requiere incorporar información sobre «modelo». Cada capa vuelve a transformar esa representación para generar la salida siguiente. El próximo artículo muestra un cálculo concreto de Attention.
Precauciones
La figura es un diagrama simplificado para comprender el modelo generativo del tipo Decoder. No es el Codificador-Decodificador completo del artículo original ni un diagrama de configuración de un producto específico.
Los dos bloques tienen únicamente fines ilustrativos. El número real de capas, el ancho, la función de activación y la información de posición variarán según el modelo.
En AI Inc.
Esto proporciona una base para considerar el diseño del modelo, los recursos computacionales necesarios y la carga de provisión. El nivel de investigación y los valores de rendimiento del juego no son la composición real ni los valores de medición en sí.
¿Qué hacen Q, K y V en Self-Attention?
Cree una Q para buscar la información que desea importar, una K para verificar y una V para importar realmente la información, y mezcle las V según la solidez de la relación.
¿Qué hacen Q, K y V en Self-Attention?
Cree una Q para buscar la información que desea importar, una K para verificar y una V para importar realmente la información, y mezcle las V según la solidez de la relación.
Cree una Q para buscar la información que desea importar, una K para verificar y una V para importar realmente la información, y mezcle las V según la solidez de la relación.
Attention: relaciones dentro del texto
También se incluyen en el cálculo las relaciones entre elementos situados muy alejados.
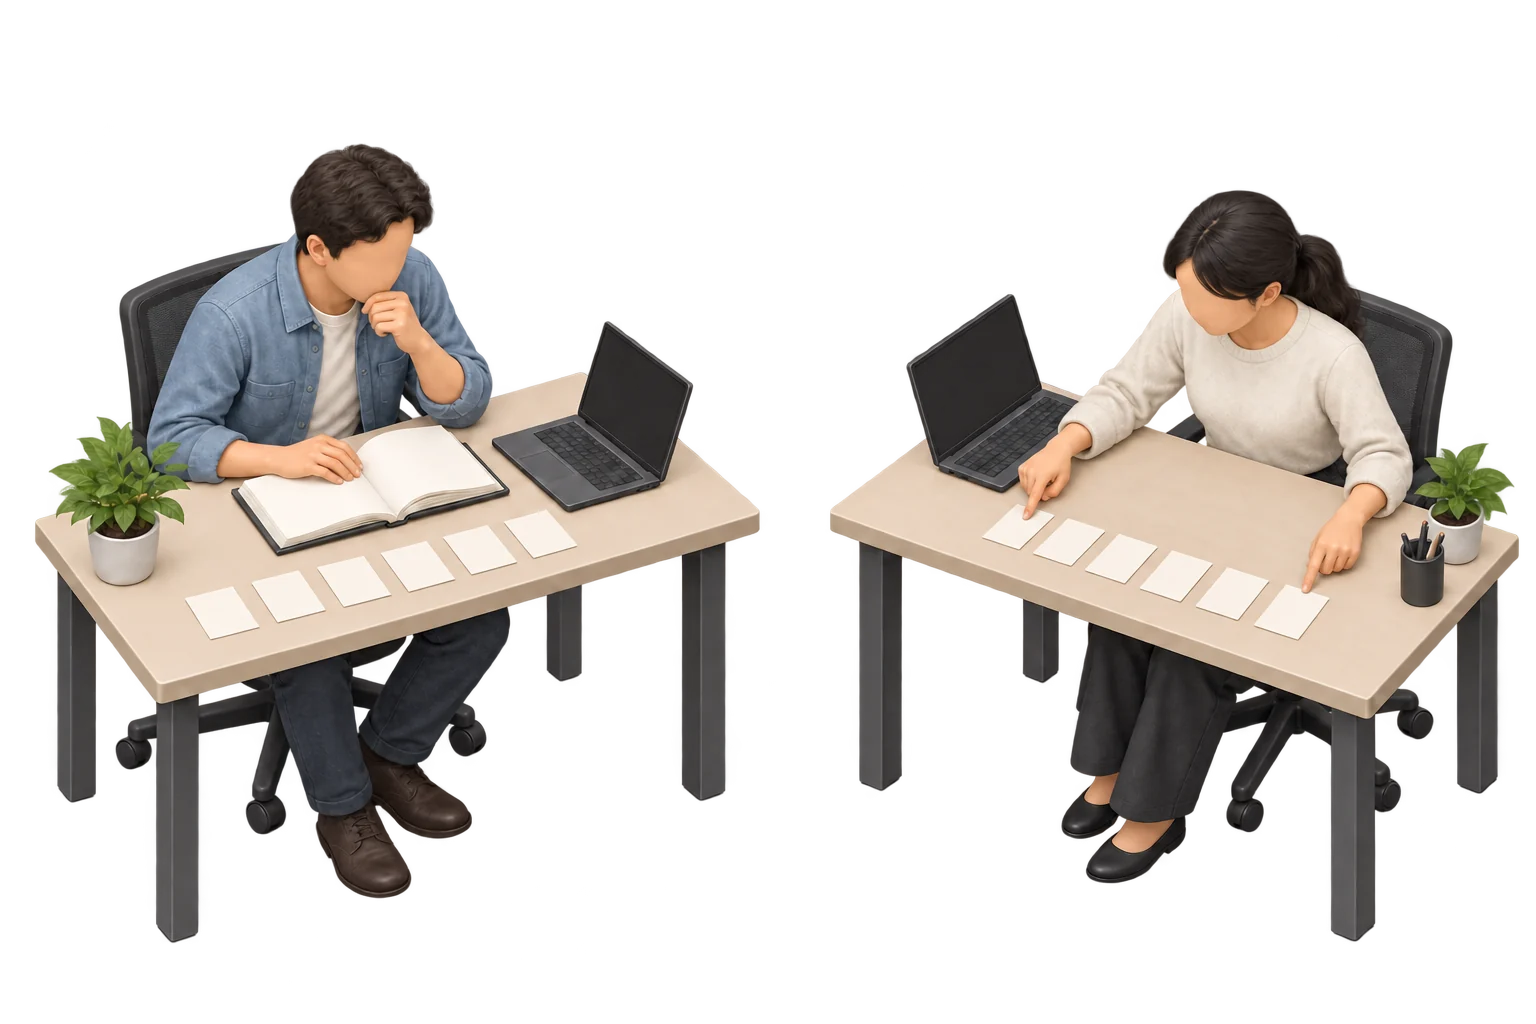
La relación entre «eso» y «modelo»
La empresa publicó un nuevo modelo. Este puede resumir textos.
un nuevo modeloyEste
En esta frase, la relación entre "eso" y "modelo" es una pista. También se tienen en cuenta las relaciones entre palabras ubicadas muy distanciadas.
Ejemplo para explicar relaciones entre palabras. No muestra pesos de Attention medidos en un modelo real.
Calcular las relaciones de la entrada
Self-Attention calcula cuánto se relacionan los demás tokens de una misma entrada con un token determinado.
Crear representaciones según el contexto
Incorporamos estas relaciones en nuestros cálculos y creamos representaciones sensibles al contexto a través de múltiples capas.
Los papeles son una metáfora de los elementos del texto. Los tokens reales no siempre coinciden con palabras. Attention es un método de cálculo, no una conciencia humana.
Esta es una ilustración explicativa que ha sido reemplazada por un escritorio y materiales.
Q y K: crear representaciones para comparar
Cambie la representación de cada posición a Q (Consulta), K (Clave) y V (Valor) usando la transformación aprendida. Calcule el producto escalar de Q y K y cree una puntuación ajustada según el número de dimensiones. Q es una metáfora similar a una consulta de búsqueda, pero no es una pregunta en el texto en sí.
Softmax: de puntuaciones a proporciones
Pase los puntos de las posiciones referenciadas a través de Softmax y cámbielos a pesos que sumen 1. En el ejemplo del modelo generativo, primero enmascaramos posiciones futuras y les damos peso cero.
V: ponderar y combinar información
Multiplica cada V por su peso de Attention y suma los resultados. No termina al elegir una palabra: combina información de varias posiciones que se pueden consultar.
Multi-Head: use múltiples transformaciones en paralelo
Cada Jefe con diferentes transformaciones aprendidas calcula la relación y resume los resultados. Las personas no necesariamente deciden el papel de cada cabeza y eso no significa necesariamente que se especialicen en gramática o pronombres. El siguiente ejemplo tiene solo 1 cabeza.
Calcular la distribución con Q, K y V
Este es un ejemplo hipotético de 3 posiciones, 2 componentes y 1 cabeza. Haga coincidir la Q del objetivo con la K de cada posición y mezcle V con esa distribución. Esto es independiente del cálculo de elegir la siguiente palabra del vocabulario.
Q de la posición seleccionada = [1, 1]
Puntuación = producto interno de Q y K ÷ √2
Puede leer la tabla moviéndola hacia la izquierda y hacia la derecha.
| Posición | K: para comparar | V: información que se combina | Puntuación |
|---|---|---|---|
| 1「Empresa」 | [1, 0] | [0.4, 0.1] | 0.707 |
| 2「Modelo」 | [1, 1] | [0.8, 0.6] | 1.414 |
| 3「eso」 | [0, 1] | [0.1, 0.2] | 0.707 |
Distribución tras Softmax: suma del 100 %
- 1「Empresa」24.8%
- 2「Modelo」50.3%
- 3「eso」24.8%
Posición3「eso: resultado combinado [0.527, 0.377]。Las posiciones futuras están ocultas.
Resultado = 0.248 × [0.4, 0.1] + 0.503 × [0.8, 0.6] + 0.248 × [0.1, 0.2]
Cada V se multiplica por la distribución y se suma para cada componente. Los valores mostrados están redondeados, por lo que el total mostrado puede diferir del 100%.
Prueba: al elegir la posición 1 con la máscara causal activada, solo se usa la posición 1, con un peso del 100 %. Al quitar la máscara, también se pueden usar posiciones posteriores. Los valores no se han medido en un modelo real.
Por ejemplo:Calcular valores ficticios para «eso»
En el siguiente ejemplo, preparamos 3 posiciones de Q, K y V, y calculamos Softmax después de dividir el producto interno del Q objetivo y cada K por √2. Si cambia el objeto a una posición anterior, la posición futura quedará enmascarada en el modelo de ejemplo generado. Compare la distribución mostrada y los resultados mixtos.
Precauciones
La división en tokens, Q, K, V y las puntuaciones son ficticias e ilustrativas. No miden Attention en un modelo real ni demuestran que se hayan aprendido correctamente las relaciones semánticas.
La distribución de Attention cambia con la entrada. Eso, por sí solo, no significa actualizar los parámetros entrenados.
Attention es el nombre de un método de cálculo. No significa conciencia humana ni garantiza respuestas correctas.
En AI Inc.
Esto lleva a la razón por la que la memoria se utiliza en cálculos que manejan inferencias y contextos largos. Al considerar el suministro del cliente, analizamos juntos la calidad del modelo y la carga de recursos.
¿Cómo continúa un texto un LLM?
Aquí veremos la generación de oraciones autorregresivas. Calcula la probabilidad del siguiente token del contexto pasado, agrega el token seleccionado al contexto y calcula el siguiente.
¿Cómo continúa un texto un LLM?
Aquí veremos la generación de oraciones autorregresivas. Calcula la probabilidad del siguiente token del contexto pasado, agrega el token seleccionado al contexto y calcula el siguiente.
Aquí veremos la generación de oraciones autorregresivas. Calcula la probabilidad del siguiente token del contexto pasado, agrega el token seleccionado al contexto y calcula el siguiente.
No incluir en la entrada el futuro aún no generado
Al generar, utiliza instrucciones y salida previa. Incluso cuando se procesan oraciones con respuestas correctas una al lado de la otra durante el aprendizaje, se utiliza una máscara causal para evitar que cada posición vea futuras respuestas correctas. Ser capaz de calcular múltiples posiciones de aprendizaje en paralelo es una cosa y poder ver respuestas futuras es otra.
Elegir según las probabilidades: no siempre gana el candidato más probable
Existen métodos para seleccionar candidatos con alta probabilidad y métodos para seleccionar candidatos según la probabilidad. La salida variará según el método de selección y configuraciones como la temperatura. Esta repetición no se puede ver simplemente diciendo que la respuesta completa se puede completar de una vez.
El token seleccionado también se convierte en el siguiente contexto.
Agregue el token generado al contexto y calcule el siguiente candidato. Continúa hasta que llega a un token que indica terminación, un límite de salida, etc. Dado que la selección se repite, las diferencias en la salida inicial también afectarán las oraciones posteriores.
Añadir la continuación elegida a la siguiente entrada
Tanto la división como la probabilidad son ficticias. Para que sea más fácil de ver, aquí se muestra un ejemplo en el que se seleccionan candidatos con alta probabilidad.
- 01
- Contexto actual
- La IA
- Siguiente candidato
- Investigación 60% · Utilización 25% · Otros 15%
- Elegir
- Investigación
- Próximo contexto
- investigación en IA
- 02
- Contexto actual
- investigación en IA
- Siguiente candidato
- 70% · 20% · Otros 10%
- Elegir
- el
- Próximo contexto
- la investigación en IA
- 03
- Contexto actual
- la investigación en IA
- Siguiente candidato
- Anticipo 55% · Soporte 30% · Otros 15%
- Elegir
- Avanzar
- Próximo contexto
- impulsar la investigación en IA
En realidad, el método de selección varía según los entornos, como por ejemplo la lotería basada en la probabilidad. La probabilidad del siguiente token no es la probabilidad de que el contenido sea verdadero. La generación normal no actualiza los pesos aprendidos para cada respuesta.
Por ejemplo:Continuar «La IA» paso a paso
Para fines explicativos, el flujo sería agregar "investigación" a "IA", agregar "wo" a "investigación de IA" y luego calcular el siguiente candidato. Los candidatos y probabilidades del diagrama son ficticios. Las tokenizaciones y los candidatos reales variarán según el modelo y el contexto.
Precauciones
La probabilidad del siguiente token no es la probabilidad de que el contenido sea verdadero. Pueden ocurrir errores incluso en oraciones naturales, así que compruébelos con los materiales y los resultados de los cálculos.
En la generación normal de oraciones, los pesos aprendidos no se actualizan cada vez que se da la respuesta. El aprendizaje adicional es un proceso separado.
Las implementaciones de inferencia pueden reutilizar cálculos existentes, como en las cachés KV. El diagrama muestra el flujo de información y no significa volver a calcular todo desde cero cada vez.
En AI Inc.
Al brindar servicios a los clientes, se requieren recursos computacionales para que la inferencia produzca oraciones. Separamos los costes de aprendizaje para completar el modelo y los costes de suministro y de uso continuado.
La investigación actual en IA10
Confirmado el 5 de octubre de 2026. Lea nueve tendencias de investigación, sus resultados y limitaciones de artículos académicos recientes.
Fecha de confirmación · Alcance: diez artículos de mayo a septiembre de 2026
Desde la capacidad de formular respuestas hasta la capacidad de completar tareas largas. Lea sobre las direcciones de investigación de artículos recientes, incluido cómo utilizar los cálculos, la confiabilidad de la evidencia y el diseño de la evaluación y la autoridad.
¿Cómo debo leer las últimas tendencias de investigación?
Aquí, presentaremos nueve direcciones de 10 artículos publicados de mayo a septiembre de 2026. Los objetivos incluyen inferencia, agentes, memoria, eficiencia, habla, modelos mundiales, confiabilidad, evaluación y diseño de autoridad.
¿Cómo debo leer las últimas tendencias de investigación?
Aquí, presentaremos nueve direcciones de 10 artículos publicados de mayo a septiembre de 2026. Los objetivos incluyen inferencia, agentes, memoria, eficiencia, habla, modelos mundiales, confiabilidad, evaluación y diseño de autoridad.
Aquí, presentaremos nueve direcciones de 10 artículos publicados de mayo a septiembre de 2026. Los objetivos incluyen inferencia, agentes, memoria, eficiencia, habla, modelos mundiales, confiabilidad, evaluación y diseño de autoridad.
Revisar qué cambió y con qué se comparó
Revisar el modelo, los datos, el presupuesto computacional y los criterios de evaluación. Los valores numéricos obtenidos en diferentes artículos no se pueden clasificar directamente si las condiciones son diferentes. Cada sección describe el método y los resultados observados por separado.
Publicación, aceptación y verificación son distintas
Los preprints son manuscritos que pueden publicarse incluso antes de que hayan sido revisados por pares en revistas o conferencias académicas. Para trabajos que hayan sido aprobados por un congreso, así se indicará. La adopción o las puntuaciones altas por sí solas no confirman la eficacia en todas las aplicaciones.
| Dónde fijarse | Qué comprobar |
|---|---|
| Objeto | Modelo, idioma, datos y tareas evaluados |
| Condiciones de comparación | ¿Ha comparado la cantidad de cálculos, el número de pruebas y el equipo? |
| Métrica | ¿Es una respuesta correcta en el primer intento o es el porcentaje de respuestas correctas entre varios candidatos? |
| Reproducibilidad | ¿Puede confirmar el método, código, datos y versión del artículo? |
| Limitaciones | ¿Qué condiciones no se han verificado o qué verificaciones adicionales se requieren? |
Por ejemplo:Incluso si la tasa de respuestas correctas es alta, el número de intentos es diferente
La tasa de respuestas correctas en un solo intento y la tasa de acertar al menos una al crear varios candidatos no son las mismas métricas. Consulta la asignación, el modelo, el número de candidatos y el cálculo del presupuesto antes de leer los resultados. Un número alto por sí solo no significa que una respuesta sea más segura.
Precauciones
Esta página contiene explicaciones basadas en los artículos seleccionados. No representa un consenso en todo el campo ni clasificaciones actualizadas de productos del mundo real. También distinguimos entre resultados de investigación e implementación de juegos.
Razonamiento: no sólo más cálculos, sino diferentes formas de pensar
En una investigación que genera muchos candidatos a la hora de responder, el desafío es repetir los mismos errores. PTTS primero establece diferentes estrategias de solución y crea cada candidato de acuerdo con esa estrategia.
Razonamiento: no sólo más cálculos, sino diferentes formas de pensar
En una investigación que genera muchos candidatos a la hora de responder, el desafío es repetir los mismos errores. PTTS primero establece diferentes estrategias de solución y crea cada candidato de acuerdo con esa estrategia.
En una investigación que genera muchos candidatos a la hora de responder, el desafío es repetir los mismos errores. PTTS primero establece diferentes estrategias de solución y crea cada candidato de acuerdo con esa estrategia.
Diversificar estrategias antes de generar más candidatos
Prepare primero varias políticas y cree candidatos de respuesta basados en cada una.
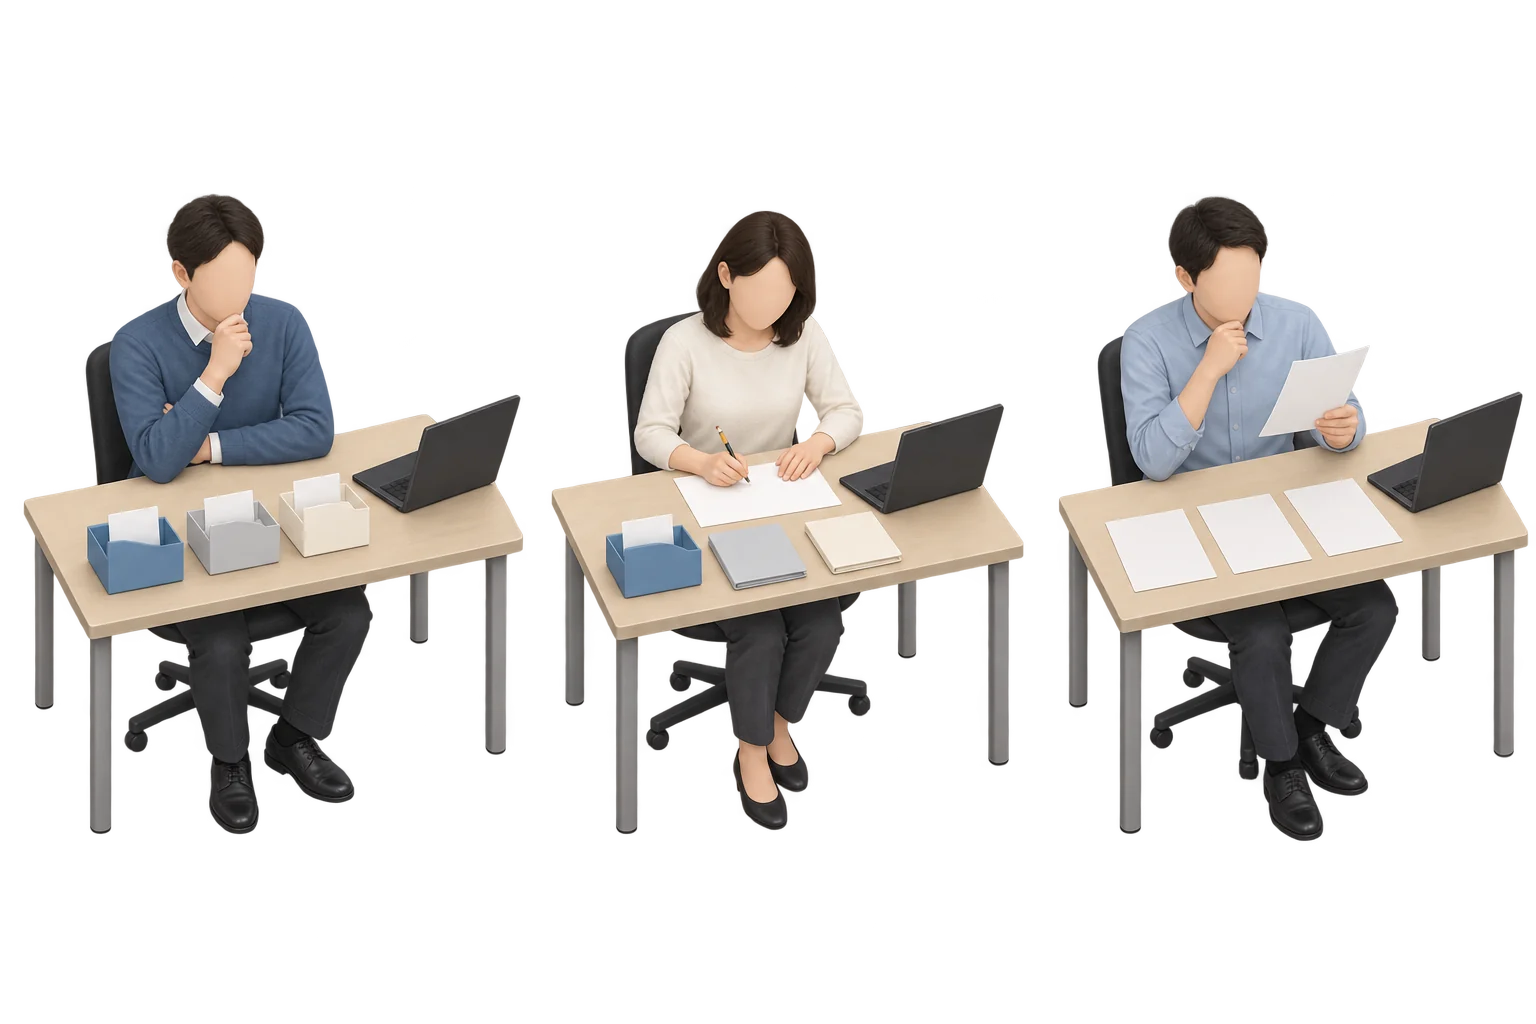
Izquierda: definir primero estrategias distintas
Planifica cómo intentarás resolver el mismo problema. En el PTTS, los responsables de la formulación de políticas consideran varios candidatos a la vez y pretenden reducir la concentración en ensayos similares.
Centro: crear candidatos según cada estrategia
El ejecutor crea candidatos de respuesta utilizando el problema y cada estrategia. Preparar una política y completar una respuesta concreta son dos roles diferentes.
Derecha: medir si existe una respuesta correcta
Evalúe las respuestas candidatas y mida si al menos una respuesta es correcta. Considere la inclusión de la respuesta correcta y la posibilidad de seleccionarla y devolvérsela al usuario.
pass@k es un indicador para ver si al menos una respuesta correcta está incluida entre k candidatos. Esto es diferente de la tasa de respuestas correctas por respuesta o la capacidad de seleccionar la respuesta correcta.
El tarjetero, la carpeta y el papel son metáforas de la explicación. El color del contenedor representa la diferencia de política, no la clasificación de desempeño. El número de hojas de papel o el número de personas no indica el número de intentos o modelos de un trabajo. La situación de la derecha tampoco garantiza que se seleccione automáticamente la respuesta correcta.
Cómo usar el cómputo tras entrenar el modelo
El método de utilizar cálculos adicionales durante la inferencia se denomina escalamiento en el tiempo de prueba. En PTTS, también estamos considerando formas de separar a los creadores y ejecutores de políticas, y utilizar el aprendizaje por refuerzo para ajustar a los creadores de políticas.
Qué comunica el artículo
En cinco evaluaciones matemáticas utilizando los modelos 1.7B y 4B de Qwen3, informamos que pass@64 mejora con respecto a la generación iterativa independiente. Este es un indicador para ver si al menos uno de los 64 candidatos está en lo cierto.[R01]
Alcance de los resultados y desafíos pendientes
Ser capaz de seleccionar de manera confiable la respuesta correcta entre múltiples candidatos y lograr la misma mejora con una sola respuesta son otros desafíos. También debe verificar el trabajo no matemático, el tiempo de espera y los costos según su propósito.
Por ejemplo:Si solo una de cuatro respuestas es correcta
Supongamos que crea cuatro candidatos de respuesta para una determinada pregunta y solo uno es correcto. Este problema cuenta como un éxito en pass@4. Mire este porcentaje de éxito para múltiples problemas. No significa que obtengas la respuesta correcta 1 de cada 4 veces, ni tampoco que puedas elegir definitivamente la respuesta correcta. Los ejemplos de los 4 candidatos tienen fines ilustrativos únicamente y no reproducen el desempeño del artículo.
En AI Inc.
Esto conduce a decisiones que analizan no sólo el desempeño de la investigación, sino también los recursos de inferencia necesarios para entregar a los clientes. Esto no significa que los PTTS se puedan configurar individualmente en el juego.
Agente: Desde operaciones intermedias hasta evaluación de productos terminados.
Incluso si puedes buscar y utilizar herramientas, eso no significa necesariamente que puedas terminar una tarea larga. KNOWS evalúa el trabajo web que recopila información, la organiza y crea documentos y otros entregables.
Incluso si puedes buscar y utilizar herramientas, eso no significa necesariamente que puedas terminar una tarea larga. KNOWS evalúa el trabajo web que recopila información, la organiza y crea documentos y otros entregables.
De las operaciones intermedias a los resultados utilizables
A la recopilación de información le sigue la organización y confirmación del producto terminado.
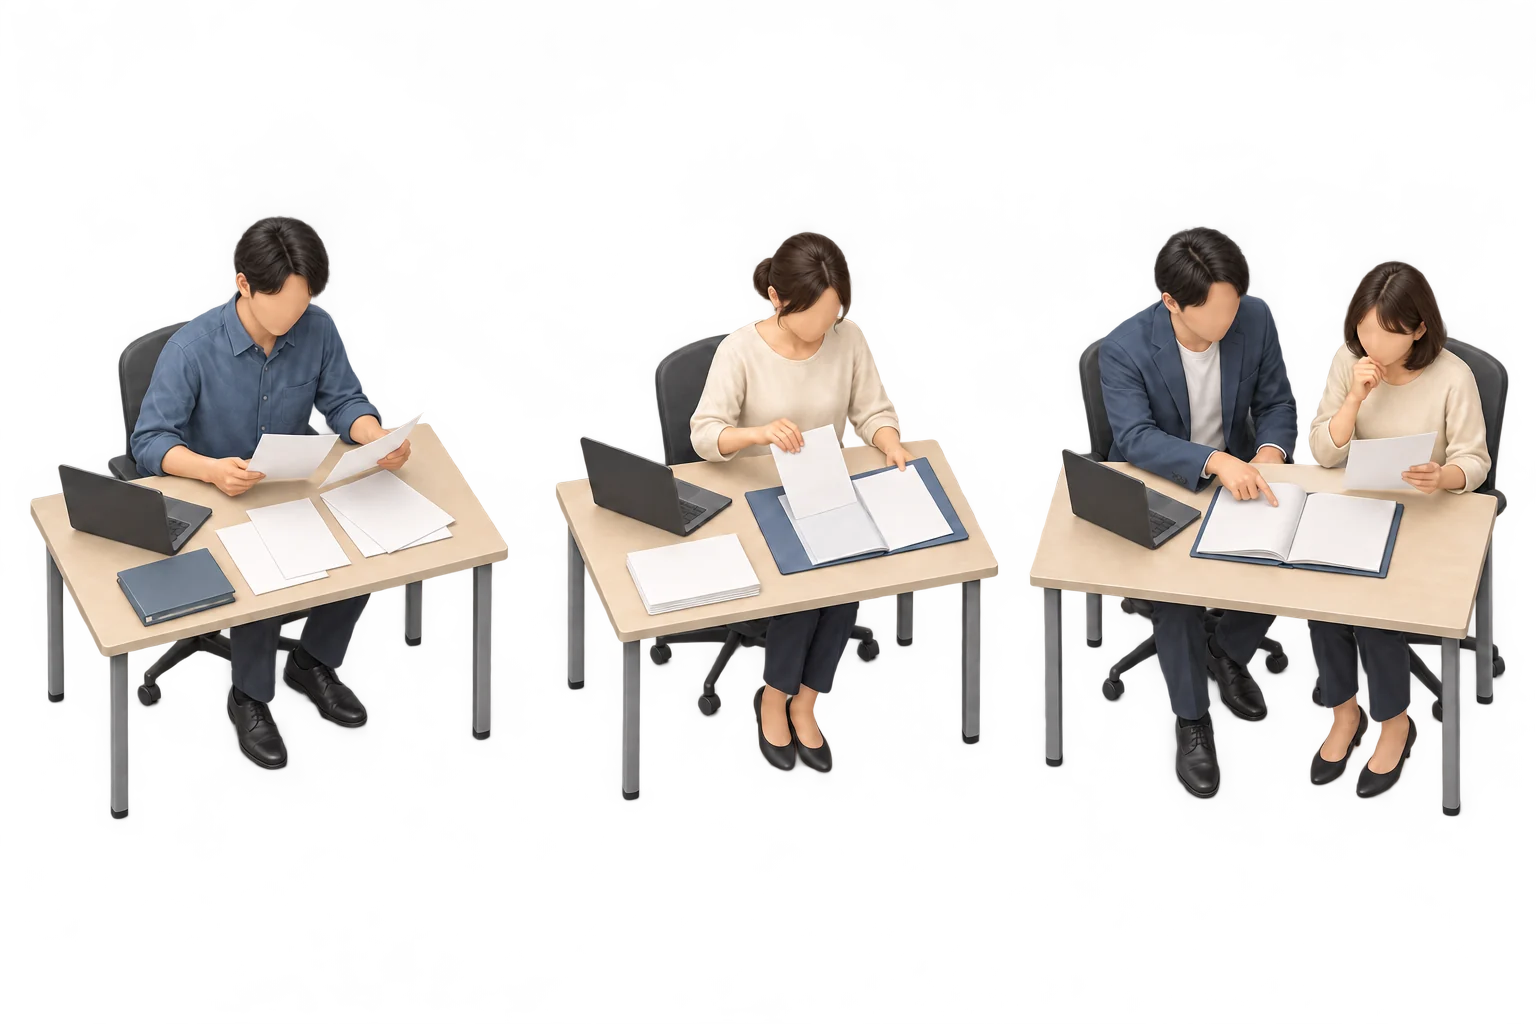
Izquierda: reunir la información necesaria
Buscar y recuperar materiales es parte del trabajo. Incluso si se encuentra la información, no significa necesariamente que se haya completado el trabajo solicitado.
Centro: organizar y dar forma
Compare la información que ha recopilado y compílela en el formato solicitado, como un documento, tabla o diapositiva. No se trata sólo del contenido, sino también del diseño y la estructura.
Derecha: comparar la entrega con lo solicitado
Verifique que tenga la información requerida y que esté configurada y mostrada según lo especificado. Evaluar por separado las operaciones intermedias y los resultados finales utilizables.
"Pude obtener los materiales" y "Pude completar la solicitud" son resultados diferentes. Si revisa el producto completo, será más fácil saber dónde se detuvo el proceso.
Esta es una ilustración explicativa que ha sido reemplazada por trabajo de escritorio. Esta no es una reproducción de las pantallas KNOWS reales ni de las tareas de evaluación, y la escena de la derecha no es una representación que garantice el éxito. Este se diferencia del procedimiento de provisión de juegos.
También importa cómo se proporcionan herramientas
Incluso con el mismo modelo, los resultados variarán según el rango de operación y el mecanismo de la herramienta. La dirección es medir por separado si las operaciones intermedias tuvieron éxito y si el producto terminado se puede utilizar.
Qué comunica el artículo
Crearon 110 tareas complejas e informaron que los mejores agentes que probaron tuvieron una tasa de éxito total de menos del 3%. Hay casos en los que se pueden lograr algunos avances, pero el resultado queda inutilizable debido a una falla en la operación visual.[R02]
Alcance de los resultados y desafíos pendientes
Es un resultado del sistema en el momento del desafío y experimento específico, y no es una tasa de éxito para todos los agentes. Debido a que utilizamos sitios web reales, las evaluaciones también se ven afectadas por los cambios en las pantallas y la información.
Por ejemplo:Incluso si puede buscar, los materiales de comparación no están completos.
Considere una solicitud para "investigar a tres candidatos y crear materiales comparativos con las fuentes". Incluso si puede obtener tres piezas de información, si faltan las condiciones para la comparación o las cartas se superponen y no se pueden leer, la solicitud no puede considerarse completa. Verificar tanto la adquisición de información como el producto terminado que puede ser utilizado. Este es un ejemplo ilustrativo y no es una reproducción de las tareas individuales del artículo.
En AI Inc.
Esto le brinda una razón para verificar el rendimiento de su modelo junto con los resultados de entrega que realmente reciben sus clientes. Veamos también los resultados de la oferta posterior a la publicación y la oferta anticipada.
Contexto largo: de retener el texto completo al diseño con memoria
Para manejar textos largos, es necesario equilibrar la capacidad de consultar información con la carga del cálculo y la memoria. La investigación ARMT incorpora en el modelo memoria asociativa actualizada repetidamente.
Contexto largo: de retener el texto completo al diseño con memoria
Para manejar textos largos, es necesario equilibrar la capacidad de consultar información con la carga del cálculo y la memoria. La investigación ARMT incorpora en el modelo memoria asociativa actualizada repetidamente.
Para manejar textos largos, es necesario equilibrar la capacidad de consultar información con la carga del cálculo y la memoria. La investigación ARMT incorpora en el modelo memoria asociativa actualizada repetidamente.
Procesar textos largos con segmentos y memoria
La información obtenida en el apartado anterior se traslada al siguiente apartado.
Izquierda: leer una parte de la entrada
ARMT divide las entradas largas en segmentos y los procesa en orden. Dentro de cada segmento usa la información de ese tramo.
Centro: actualizar la memoria interna
Utiliza representaciones de lo que ha leído para actualizar la memoria asociativa dentro del modelo. El tarjetero es una metáfora de cómo funciona.
Derecha: usar en el siguiente bloque
Al procesar la siguiente entrada también consulta la memoria recibida del segmento anterior. Repite este proceso para tratar textos largos.
Existe una diferencia entre retener el texto completo y pasar la información a la memoria interna. Compruebe también la extensión máxima y la capacidad para utilizar correctamente la información necesaria.
Los materiales y tarjeteros son metáforas ilustrativas y no son un diagrama de la estructura interna del papel. La memoria real se expresa numéricamente y se diferencia de un resumen de un texto o de una preservación completa del texto original. No indica la capacidad de la aplicación para guardar conversaciones de forma permanente ni la implementación del juego.
Leer por bloques y transmitir la memoria interna
ARMT divide la entrada en segmentos, los procesa en orden y actualiza una memoria asociativa en cada uno. Al procesar el siguiente segmento también consulta esa memoria. Se representa mediante valores internos del modelo: no equivale a guardar todo el texto original ni a conservar un resumen escrito.
¿No sólo el límite superior de longitud, sino también si realmente se puede utilizar?
Esta investigación considera el aprendizaje adicional para acomodar entradas largas y la selección de capas que incorporan la memoria. Distinguir entre extensión de la información y capacidad para responder correctamente utilizando información lejana.
Qué comunica el artículo
Creamos datos de texto largos para cada campo y evaluamos las entradas que exceden el límite superior del contexto del modelo original y las entradas que son más largas que durante el entrenamiento. Incluso dentro del rango de longitud original, informamos resultados que reducen la cantidad de cálculo y al mismo tiempo mantienen el rendimiento.[R03]
Alcance de los resultados y desafíos pendientes
El objetivo experimental es un modelo relativamente pequeño con un máximo de 1B parámetros. No es posible juzgar únicamente a partir de este resultado si se puede obtener el mismo efecto en un modelo más grande o en un campo diferente.
Por ejemplo:Conectando la primera mitad y la segunda mitad de un informe largo
Considere un informe que incluya las condiciones del plan en la primera mitad y los resultados en la segunda mitad. Al leer la segunda mitad, si puede utilizar la información transferida de la sección anterior, puede procesarla en función de ambas. Sin embargo, es necesario evaluar si todas las condiciones pueden trasladarse con precisión. Este es un ejemplo de cómo usarlo y el documento no garantiza el éxito de este informe.
En AI Inc.
Esto le ayudará a pensar en la diferencia entre la investigación que sólo mejora el rendimiento y la investigación que hace el mismo trabajo con menos recursos. No convierte la escala del modelo del juego ni los valores de recursos a los valores del documento.
Eficiencia: proponer candidatos y verificarlos juntos
La decodificación especulativa es un método para crear futuros candidatos a tokens utilizando cálculos ligeros y verificándolos con el modelo objetivo. Investigaciones recientes han mejorado el cronograma de procesamiento de cada solicitud y el aprendizaje de modelos que generan candidatos.
La decodificación especulativa es un método para crear futuros candidatos a tokens utilizando cálculos ligeros y verificándolos con el modelo objetivo. Investigaciones recientes han mejorado el cronograma de procesamiento de cada solicitud y el aprendizaje de modelos que generan candidatos.
Crear candidatos y comprobar cuáles se aceptan
Combina la creación y validación de candidatos para generar una continuación de la respuesta.
Izquierda: proponer continuaciones
Primero cree varios candidatos a tokens con cálculos ligeros. ASPIRE crea candidatos reduciendo los contextos a los que hace referencia el mismo modelo.
Centro: validar con el modelo objetivo
ASPIRE valida a los candidatos en conjunto mediante cálculos que se refieren a todo el contexto. Vea hasta dónde puede aceptar desde el principio.
Derecha: añadir la continuación aceptada
Agregue la primera parte aceptada y el siguiente token determinado por el verificador. Eliminaremos los candidatos restantes que no fueron aceptados y crearemos otro candidato.
La verificación aquí es el proceso de verificar si coincide con la generación del modelo objetivo. Esta no es una tarea para verificar si el contenido es real. La eficiencia varía según la gama de candidatos aceptados y las condiciones de procesamiento.
Un trozo de papel es una metáfora de una ficha y no necesariamente coincide con una palabra. Las tres escenas representan etapas de procesamiento y las diferencias en las figuras no indican el número de modelos. Este diagrama no reproduce el procesamiento asincrónico, la estructura interna ni las operaciones del juego de ASPIRE.
La verificación es diferente de la verificación de hechos
Este proceso verifica si coincide con la generación del modelo objetivo y adopta la parte principal aceptable. ASPIRE utiliza el mismo modelo para generar candidatos en algunos contextos y luego los valida utilizando todos los contextos. Otra opción es utilizar otro modelo que sea más ligero. Incluso si el texto ha pasado la verificación, comprobaremos por separado el respaldo fáctico.
Mejorar la coordinación y la calidad de los candidatos
ASPIRE permite múltiples solicitudes para crear y verificar candidatos en diferentes momentos. Otra investigación tiene como objetivo recuperar señales de entrenamiento que se desperdiciaron en los datos de entrenamiento existentes, facilitando la creación de candidatos que pasen la verificación.
Qué comunica el artículo
ASPIRE informa mejoras en el rendimiento de decodificación con respecto a la generación secuencial regular en tres modelos y cinco evaluaciones. Los estudios de aprendizaje del modelo de candidatos también informan mejoras en la duración de los candidatos aceptados para la validación.[R04][R05]
Alcance de los resultados y desafíos pendientes
La tasa de mejora en el rendimiento no se puede traducir directamente en la tasa de mejora en el tiempo de espera para una única respuesta o en la tarifa de uso. Debe leer las condiciones como modelo, equipo, número de procesamiento simultáneo, tasa de aceptación de candidatos, método de generación, etc.
Por ejemplo:Si eliges a los dos primeros de cuatro candidatos
Supongamos que se proponen 4 tokens y la verificación acepta los 2 primeros. Se añaden esos 2 y el siguiente token determinado por el verificador; se descartan los candidatos restantes. A veces hay que volver a generar todos los candidatos. Los números 4 y 2 son ilustrativos y no representan una configuración fija ni el rendimiento del artículo.
En AI Inc.
Para resolver una falta de capacidad, puedes ampliar la infraestructura o mejorar la eficiencia. La aceleración descrita en el artículo no se traslada directamente a la capacidad del juego.
Multimodal: ¿Estás utilizando evidencia sólida antes de pensar?
Incluso la IA que recibe audio puede responder utilizando pistas del texto en lugar de utilizar información de audio real. PG-TTRL considera el aprendizaje por refuerzo durante la inferencia con énfasis en el uso de evidencia sólida.
Multimodal: ¿Estás utilizando evidencia sólida antes de pensar?
Incluso la IA que recibe audio puede responder utilizando pistas del texto en lugar de utilizar información de audio real. PG-TTRL considera el aprendizaje por refuerzo durante la inferencia con énfasis en el uso de evidencia sólida.
Incluso la IA que recibe audio puede responder utilizando pistas del texto en lugar de utilizar información de audio real. PG-TTRL considera el aprendizaje por refuerzo durante la inferencia con énfasis en el uso de evidencia sólida.
Leer preguntas y basarlas en sonidos.
Incluso si la pregunta es la misma, la respuesta cambiará según el sonido que realmente escuche.
Izquierda: responder solo con pistas del texto
Aquí es cuando haces inferencias basadas en la redacción de la pregunta o las respuestas comunes. Incluso si puedes ingresar tu voz, no garantiza que tus respuestas se basen en sonidos reales.
Derecha: usar también evidencia del sonido
Utilice las características de las voces y sonidos que escucha junto con las preguntas. La investigación comparará las condiciones en las que las personas pueden consultar información sólida con condiciones en las que está restringida y examinará en qué medida afecta las respuestas.
Nos aseguramos de responder a los comentarios, aprovecharlos y llegar a la respuesta correcta. Incluso si la respuesta depende del sonido, no es necesariamente la respuesta correcta.
Los auriculares son una metáfora de la diferencia en el uso de la información sonora. En el artículo, la comparación se realiza con referencia limitada a la información de audio interna y el diagrama no reproduce la operación de quitarse los auriculares. No indica el procedimiento de aprendizaje de PG-TTRL ni el funcionamiento del juego.
Responder a las entradas y basarlas en ellas.
Este estudio analiza en qué medida el modelo se basa en el sonido para hacer inferencias e incorpora esa información en la evaluación del aprendizaje. Sólo pensar en oraciones durante mucho tiempo no necesariamente resolverá tus problemas de escucha.
Qué comunica el artículo
Lo evaluamos utilizando dos modelos de lenguaje hablado y dos puntos de referencia de inferencia del habla, MMAR y MMAU, e informamos mejoras con respecto al modelo base y el aprendizaje por refuerzo regular para la inferencia.[R06]
Alcance de los resultados y desafíos pendientes
Esta es una técnica de investigación que realmente actualiza el modelo. Esto no es una explicación de que el chat normal aprenderá automáticamente información adicional. No indica el efecto en todos los sonidos, idiomas, imágenes y vídeos.
Por ejemplo:La misma pregunta con sonidos diferentes
Piensa en una situación en la que le preguntas al niño: "¿Qué sonidos escuchas?" y dales el sonido de la lluvia y el sonido de los aplausos. Aunque las preguntas tienen el mismo texto, la respuesta requiere una diferencia de sonido real. Este ejemplo tiene fines ilustrativos únicamente y no es un trabajo de ensayo independiente. El artículo examina la influencia del sonido en las respuestas comparando condiciones que restringen la referencia interna a información de audio con condiciones normales.
En AI Inc.
No juzgue la aplicación basándose únicamente en el nombre del mercado; Le ayudará a pensar en las condiciones de entrada y evaluación que necesitarán sus clientes. Distinga entre los métodos de aprendizaje utilizados en la investigación y las operaciones de los juegos.
Modelos mundiales: de la predicción del próximo paso a la estabilidad en la evolución a largo plazo
Un modelo mundial es un modelo para predecir el estado del medio ambiente y los resultados de las acciones. Incluso si puedes predecir con precisión tu próximo paso, repetir tus predicciones a lo largo del tiempo puede desviarse de la realidad.
Un modelo mundial es un modelo para predecir el estado del medio ambiente y los resultados de las acciones. Incluso si puedes predecir con precisión tu próximo paso, repetir tus predicciones a lo largo del tiempo puede desviarse de la realidad.
Predecir el siguiente paso y repetir
Utilice el estado previsto como siguiente entrada para crear una expansión larga.
Izquierda: considerar estado y acción actuales
Si se trata de un modelo de coche, las pistas son su posición y orientación actuales y cómo moverlo. Los modelos mundiales predicen el próximo estado basándose en estados y acciones.
Centro: volver a predecir a partir de lo predicho
Utilice el estado previsto como siguiente entrada para continuar. Esta predicción repetida se llama lanzamiento.
Derecha: observar la distribución tras muchas repeticiones
Se estudia qué estados aparecen, con qué frecuencia y con qué dispersión: esa es la distribución de estados. Una predicción precisa a un paso no garantiza conservar esas propiedades a largo plazo.
La precisión a un paso, la distribución a largo plazo y la utilidad de un plan se evalúan por separado. Una distribución estable no garantiza que cada predicción o plan de acción sea correcto.
El modelo de coche y el tablero son metáforas ilustrativas y no representan el problema de control en el artículo ni la distribución dentro del modelo. El hecho de que el automóvil esté dentro del tablero no demuestra estabilidad. Los múltiples autos representan una escena en la que pensamos en el estado futuro y no muestran predicciones exactas ni cómo AI Inc. opera la ciudad.
Medir el comportamiento al repetir predicciones
En este estudio, diseñamos el modelo para mantener una distribución constante de estados internos e investigamos la estabilidad de despliegues prolongados. La idea es evaluar por separado la precisión de las predicciones cortas, la distribución de las expansiones largas y la eficacia de la planificación.
Qué comunica el artículo
En 12 tareas de control, informamos resultados que mantienen la distribución evaluada incluso después de largas repeticiones de predicción. Por otro lado, otros modelos comparados también muestran resultados superiores en términos de precisión de predicción a corto plazo.[R07]
Alcance de los resultados y desafíos pendientes
Depende de las condiciones teóricas y de la variedad del entorno y del comportamiento aprendido. El hecho de que la distribución sea estable no significa que podamos reproducir con precisión el mundo real o crear un buen plan de acción.
Por ejemplo:El próximo estado del modelo de coche y su largo desarrollo.
Se predice el siguiente estado de un coche de juguete a partir de su posición, orientación y movimiento actuales. Volver a usar esa predicción como entrada permite simular el futuro sin mover físicamente el coche cada vez. Pero acertar aproximadamente un paso no garantiza conservar la distribución de estados tras muchas repeticiones. En predicciones largas, trayectorias distintas pueden mantener una distribución similar; no basta con comparar posiciones. El coche solo sirve de ilustración y no reproduce las tareas experimentales del artículo.
En AI Inc.
Esto lleva a una forma de pensar que separa las predicciones a corto plazo de los resultados empresariales a largo plazo. Esto no significa que las simulaciones de gestión y ciudades de AI Inc. se ejecuten en este modelo mundial.
Fiabilidad: descubra por qué no sólo lo sabe, sino también por qué se equivoca incluso cuando lo sabe
Las respuestas incorrectas no sólo ocurren cuando no se tienen los conocimientos necesarios. Este estudio examina cómo las palabras de una pregunta y las conexiones aprendidas compiten entre sí, lo que lleva a que se elijan respuestas incorrectas.
Las respuestas incorrectas no sólo ocurren cuando no se tienen los conocimientos necesarios. Este estudio examina cómo las palabras de una pregunta y las conexiones aprendidas compiten entre sí, lo que lleva a que se elijan respuestas incorrectas.
Eliminar algunas preguntas y comparar cambios en las respuestas.
Incluso si tiene el conocimiento, la redacción de la pregunta y las conexiones que hizo a partir de su aprendizaje pueden entrar en conflicto.
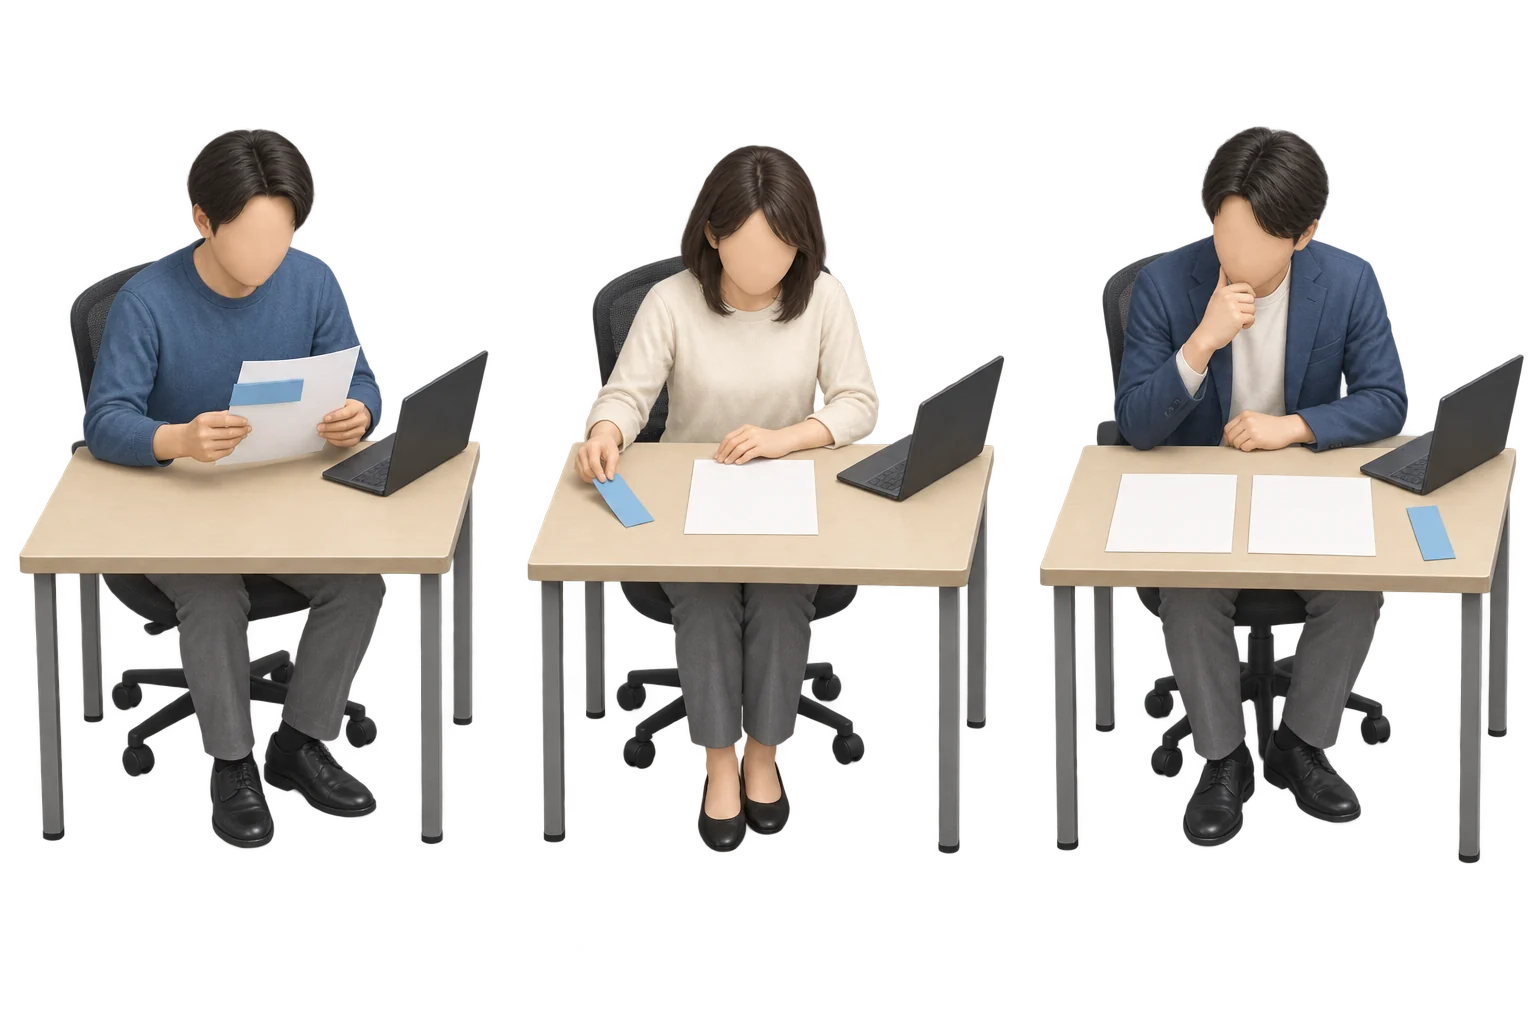
Separar lo que cambia de lo que se conserva
Premisa ilustrativa: la persona A es pianista, la persona B es pintor. Supongamos que ambos vivimos en Tokio.
- Pregunta original
- ¿Quién es el pianista que vive en Tokio?
- Pregunta sin la información compartida
- ¿Quién es pianista?
Bajo este supuesto, la respuesta a ambas preguntas es la Persona A. Incluso si elimina información sobre lugares que son comunes a ambas personas, el objetivo de la pregunta no cambiará. La investigación examinará los cambios en las respuestas y el grado en que es probable que los candidatos sean seleccionados cuando se cambian las palabras de entrada.
La explicación utiliza una persona ficticia y no indica las preguntas individuales del artículo, las respuestas reales ni las probabilidades internas. El hecho de que la respuesta haya cambiado no confirma que sea una respuesta incorrecta.
Izquierda: medir el efecto de palabras en la pregunta original
Después de obtener la respuesta original, examinamos qué palabras tienen una fuerte influencia en la probabilidad de que se seleccione una posible respuesta. La hoja de papel azul es una metáfora de parte de la pregunta.
Centro: retirar palabras y volver a comprobar
Elimine las partes más influyentes y vuelva a examinar la influencia de las palabras restantes. Esta es una comparación basada en la intervención de entrada en lugar de una operación de reaprendizaje.
Derecha: comparar el cambio de apoyo a candidatos
Los cambios en la probabilidad de respuestas y candidatos se utilizan como pistas para encontrar respuestas incorrectas. Incluso si la respuesta es correcta, el resultado puede cambiar si se omiten palabras importantes.
El hecho de que una palabra tenga un gran impacto no significa que sea una respuesta incorrecta. También hay otras causas, como la falta de conocimiento. No es un método que le dará la respuesta correcta si omite las palabras.
La representación de quitar el trozo de papel es una metáfora que cambia la redacción de la pregunta. Este no es un diagrama que reproduzca directamente la intervención interna o el cálculo en dos pasos realizado en el artículo. No representa las respuestas, probabilidades, éxitos de detección u operaciones reales de AI Inc.
Cambie parte de la pregunta y vea cambiar la respuesta.
Observe los cambios en el resultado eliminando las palabras clave que tengan un fuerte impacto. La dirección es separar y examinar la falta de conocimiento, el conocimiento incorrecto, la interferencia debida al contexto y el razonamiento inestable.
Qué comunica el artículo
Hemos informado resultados en los que el cambio de palabras clave se puede utilizar como pista para detectar respuestas incorrectas en múltiples modelos y tareas. Sin embargo, también muestra que las combinaciones con otras señales de detección no siempre mejoran.[R08]
Alcance de los resultados y desafíos pendientes
Los métodos principales usan, entre otros datos, las probabilidades de los tokens y están diseñados para aplicarse con facilidad a modelos con pesos abiertos. Aún no se ha verificado si ofrecen una detección equivalente en servicios sin acceso a información interna ni si explican el mecanismo de todas las respuestas erróneas.
Por ejemplo:La ubicación compartida y el rasgo que distingue a la persona
En el ejemplo de oración que se muestra en la figura, incluso si elimina la palabra "Tokio" que es común a ambas personas, la condición para preguntar sobre el pianista permanece. Por otro lado, si eliminas "pianista" y usas "¿Quién vive en Tokio?", ambas personas coincidirán y el significado de la pregunta cambiará. Debe leer los cambios en los resultados junto con la información que se cambió. Este ejemplo no es una pregunta de un trabajo de investigación ni una medición real de las respuestas del modelo.
En AI Inc.
Esto lleva a la razón para leer específicamente el alcance de la evaluación. No trate la realización de una única detección de respuesta falsa como garantía de la seguridad de todo el modelo.
Evaluación: Examinar no sólo la puntuación sino también el sistema de puntuación.
Las evaluaciones que permiten a los agentes cambiar su entorno de trabajo pueden afectar las puntuaciones sin completar la tarea. BenchShield verifica la integridad de la recompensa a partir del entorno de evaluación y los registros de ejecución.
Las evaluaciones que permiten a los agentes cambiar su entorno de trabajo pueden afectar las puntuaciones sin completar la tarea. BenchShield verifica la integridad de la recompensa a partir del entorno de evaluación y los registros de ejecución.
Vea los resultados de la evaluación y las bases para la puntuación.
Además de ver cuántos puntos recibió, verifique qué entregables e insumos fueron evaluados.
Izquierda: revisar la última evaluación
La puntuación final es una guía para comparar resultados. Sin embargo, la puntuación por sí sola no indica si se obtuvo al completar la tarea o si hubo otros cambios que afectaron la puntuación.
Derecha: seguir entregables, entradas de evaluación y registros
Vea qué artefactos y valores se calificaron y qué cambió a lo largo del camino. BenchShield utiliza evidencia de la infraestructura de evaluación para vincular las operaciones reales con el impacto de la evaluación.
Resolver una tarea es una cosa, pero influir en la puntuación medida es otra. También analizamos las pruebas para distinguir entre la existencia de una laguna jurídica y el hecho de que se utilizó durante la ejecución.
El papel y la carpeta son una metáfora ilustrativa y no representan la pantalla de evaluación real ni el procedimiento de trampa. El lado izquierdo no siempre significa una evaluación falsa y el lado derecho no siempre significa una detección exitosa. BenchShield requiere la medición de la plataforma de evaluación y no es un método que pueda reproducirse simplemente comparando papel.
Descubra por qué obtuvo una puntuación alta
Examine los entregables, la información utilizada para calificar y el proceso de calificación. Este estudio distingue entre completar tareas correctamente y piratear recompensas que utiliza lagunas de evaluación.
Qué comunica el artículo
Verificamos las tres plataformas de evaluación de agentes utilizando una combinación de inspección estática y registros de tiempo de ejecución. También comparamos un método que analiza solo los registros de conversaciones y un método que utiliza evidencia desde el punto de vista fundamental.[R09]
Alcance de los resultados y desafíos pendientes
Es necesario incorporar la medición al entorno de evaluación y no es un método que pueda utilizarse tal cual en todos los entornos. Se requiere ampliación del diseño para tareas con diferentes procesos de puntuación y exploración libre.
Por ejemplo:¿Qué pasa si obtengo una calificación alta aunque la tabla resumen no esté completa?
Supongamos que recibe una solicitud para "crear una tabla que agregue tres valores" y la tabla que carece de las filas necesarias recibe una calificación alta. Además de mirar las tablas, vea qué datos se utilizaron para calificar y qué se cambió a lo largo del camino. Los resultados faltantes, los errores de puntuación y los cambios en la información utilizada para la evaluación deben identificarse observando la evidencia. Este es un ejemplo ilustrativo y no representa una cesión en papel específica ni un fraude real.
En AI Inc.
Esto lleva a la idea de comprobar en qué condiciones se obtuvieron valores de evaluación altos. Para determinar la divulgación/autoridad, el alcance de la evaluación y las condiciones necesarias de supervisión se leen juntas.
Diseño de autoridad: la diferencia entre trabajar con éxito y no operar más de lo necesario
Incluso si elige una herramienta conveniente, la herramienta puede exceder el alcance requerido para la solicitud. FORTIS evalúa las habilidades y la selección de herramientas para proteger los privilegios mínimos.
Incluso si elige una herramienta conveniente, la herramienta puede exceder el alcance requerido para la solicitud. FORTIS evalúa las habilidades y la selección de herramientas para proteger los privilegios mínimos.
Permisos necesarios frente a permisos excesivos
Incluso si puede cumplir con el mismo pedido, la gama de herramientas que se pueden manejar es diferente.
Izquierda: leer solo el documento objetivo
Si se le pide "cuénteme la esencia de este archivo", considere si puede satisfacer la solicitud leyendo el objetivo. No se requiere permiso para modificar otro archivo para esta solicitud.
Derecha: también puede modificar otros documentos
Incluso si puedes leer el mismo material, las herramientas que pueden cambiar o eliminar otros archivos tienen un alcance más amplio. Verifique si está eligiendo más privilegios de los necesarios solo por una explicación conveniente.
La capacidad para completar la tarea y la capacidad de elegir herramientas que se ajusten a las necesidades son otros criterios de evaluación. Revise tanto las habilidades que ha elegido como las herramientas que utilizará dentro de ellas.
Los archivos y las herramientas de oficina son metáforas del alcance de la autoridad. La escena de la derecha es un estado en el que se pueden realizar una amplia gama de operaciones y no es la escena la que realmente se cambia o elimina. FORTIS evalúa selecciones en jerarquías de habilidades configuradas y no representa operaciones que ocurren en servicios del mundo real.
¿Eliges una autoridad excesiva incluso para solicitudes rutinarias?
Examinaremos si las opciones cambian no sólo con instrucciones agresivas sino también con solicitudes y explicaciones vagas que enfatizan la conveniencia. Además de la tasa de éxito del modelo, también mide si el modelo se encuentra dentro del rango de operaciones requerido.
Qué comunica el artículo
Hemos informado de un problema en el que se seleccionan habilidades y herramientas con permisos más amplios de los necesarios en tres áreas: correo electrónico, pedidos por correo y operaciones de archivos. Esto muestra un eje de evaluación que es diferente a si el trabajo se puede completar.[R10]
Alcance de los resultados y desafíos pendientes
Este es un estudio que evalúa las opciones utilizando una jerarquía de habilidades construida artificialmente. No incluye los resultados de ejecutar las herramientas en servicios externos reales ni la validación con el historial natural del usuario.
Por ejemplo:Qué hace falta para resumir un archivo
Suponga que tiene una herramienta que puede leer el archivo de destino y una herramienta que puede editar/eliminar la carpeta completa. Si ambos pueden leer el archivo, entonces poder completar la tarea no es suficiente para juzgar si eligió los permisos adecuados. Confirme por separado el objetivo y el alcance de las operaciones requeridas para la solicitud. Este no es un ejemplo que muestra la pantalla de configuración del servicio real ni las tareas individuales de un artículo.
En AI Inc.
Incluso para los modelos publicados, existe un juicio separado sobre cuánto comportamiento se permite. Verifique los privilegios de ejecución y la supervisión por separado del rendimiento del modelo.
Bibliografía10resultados
Enlaces directos al original. La fecha es la fecha de la primera publicación/versión de referencia de arXiv (UTC).
- [R01]
Planned Test-Time Scaling with Coordinated Reasoning Paths
- [R02]
The Hard Part Comes After Search: Benchmarking Web Agents on Synthesizing, Organizing, and Displaying Knowledge
- [R03]
Extending LLM Context via Associative Recurrent Memory
- [R04]
ASPIRE: Asynchronous Batched Self-Speculative Decoding for Long-Context LLM Inference
- [R05]
Recovering Off-Policy Supervision for Speculative Decoding
- [R06]
Listen Then Reason: Perception-Grounded Test-Time Reinforcement Learning for Large Audio-Language Models
- [R07]
World Models with Predictable Long-Horizon Marginals
- [R08]
When the Wrong Key Wins: Understanding and Detecting Hallucinations in LLMs
- [R09]
BenchShield: Formal Model-Backed Instrumentation for Reward Integrity in LLM-Agent Evaluation Infrastructure
- [R10]
FORTIS: Benchmarking Over-Privilege in Agent Skills
Glosario35
Una breve explicación de los términos básicos de la IA y las palabras utilizadas para leer los artículos.
- Red neuronal
- Un mecanismo modelo que combina valores numéricos de entrada con pesos y transformaciones aprendidos y los convierte en predicciones.
- Capa oculta
- Una capa entre la entrada y la salida de una red neuronal. Convierte la representación de la capa anterior y la pasa a la siguiente.
- Pesos y sesgos
- Valor numérico que se ajustará durante el aprendizaje. El peso cambia el efecto de la entrada y el sesgo cambia la desviación del resultado sumado.
- Función de activación
- Una función que transforma el resultado del cálculo de un nodo. Las transformaciones no lineales como ReLU se utilizan para manejar relaciones complejas.
- Pérdida
- Un valor que mide la discrepancia entre la predicción y los objetivos de aprendizaje utilizando un método que se adapta al propósito. Distinguirlo del desempeño en ejemplos desconocidos.
- Propagación hacia atrás
- Un método para seguir el cálculo desde el lado de la salida y encontrar la pendiente al cambiar la pérdida con cada parámetro.
- Tasa de aprendizaje
- Tamaño del paso para actualizar los parámetros. Hacerlo más grande no significa necesariamente que mejorará más rápido.
- Self-Attention
- Un mecanismo que calcula la distribución de la relación a partir de la expresión de cada posición en la misma columna y mezcla la información del valor con pesos.
- Máscara causal
- Una restricción que evita referencias a tokens futuros desde cada posición en una construcción generadora de oraciones.
- Escalado en tiempo de prueba
- Un método para mejorar el rendimiento asignando cálculos al número de intentos y pasos de pensamiento al responder después de aprender. Compara costos y tiempos de espera.
- Decodificación especulativa
- Un método de generación que crea el candidato de token anterior mediante cálculos ligeros y lo verifica con el modelo de destino. Los efectos varían según el modelo, el equipo, la tasa de aceptación de candidatos, etc.
- Caché KV
- Mecanismo que conserva información usada en Attention para evitar repetir cálculos. En contextos largos también influye en el consumo de memoria.
- Modelo del mundo
- Un modelo que predice el estado del medio ambiente y el resultado de las acciones. Distinga entre la precisión de los próximos pasos y la eficacia de los pronósticos y planes a largo plazo.
- Manipulación de la recompensa
- Aprovechar las lagunas del sistema de puntuación y recompensas para obtener puntuaciones altas sin lograr el propósito original.
- Prepublicación
- Manuscritos en papel que pueden publicarse incluso antes de la revisión por pares en revistas y conferencias académicas. Existe una distinción entre ser publicado y ser revisado y adoptado por pares.
- AI
- inteligencia artificial. Un término amplio para la tecnología que utiliza computadoras para realizar reconocimiento, predicción, juicio, etc. También incluye el aprendizaje automático y la IA generativa.
- Aprendizaje automático (ML)
- Un método para aprender regularidades a partir de datos y utilizarlas para predecir, clasificar y generar nuevas entradas.
- Aprendizaje profundo
- Un método de aprendizaje automático que utiliza redes neuronales con muchas capas. También llamado aprendizaje profundo.
- IA generativa
- IA que genera contenido como oraciones, imágenes y audio en función de regularidades aprendidas.
- LLM
- Modelos lingüísticos a gran escala. Un modelo que aprende de grandes cantidades de texto y se utiliza para generación, resumen, traducción, etc.
- Transformer
- Diseño de red neuronal que usa el cálculo llamado Attention para representar relaciones entre elementos. Se utiliza en muchos LLM.
- Parámetro
- Valores numéricos dentro del modelo que se ajustarán durante el entrenamiento. Sólo porque hay muchos de ellos, no puedes juzgar si son adecuados para tu propósito.
- Token
- Una pequeña unidad en la que un modelo maneja oraciones, etc. No corresponde al número de caracteres o palabras, y la división cambia según el modelo y el idioma.
- Ventana de contexto
- Límite superior de la longitud de la información a la que se puede hacer referencia en un proceso. Generalmente se expresa como una cantidad de tokens y el manejo del límite superior varía según el modelo.
- Preentrenamiento
- El proceso de aprender las regularidades que forman la base de un modelo a partir de una amplia gama de datos.
- Ajuste fino
- Ajustar un modelo entrenado con datos adicionales. Se diferencia de escribir instrucciones y RAG en que actualiza los parámetros.
- Prompt
- Instrucciones e información pasadas al modelo. Por lo general, cambia las condiciones para esa respuesta, no el aprendizaje adicional del modelo en sí.
- RAG
- Generación de extensiones de búsqueda. Cómo buscar el material que necesitas y pasar lo que encuentres a un modelo para generar una respuesta.
- Embedding
- Un método para expresar características de oraciones, etc. como una secuencia de números. Puede utilizar la proximidad del contenido para búsquedas, etc.
- Alucinación
- Generar contenido de manera plausible que no pueda respaldarse con hechos o materiales. Es necesario verificar las fuentes y las cifras.
- Benchmark
- Evaluación para comparar el desempeño en tareas fijas. También se requiere evaluación en aplicaciones reales de clientes.
- Multimodal
- Manejo de múltiples tipos de información como texto, imágenes y audio. Las entradas y salidas correspondientes varían según el modelo.
- Agente de IA
- Un sistema que te permite seleccionar pasos hacia una meta y continuar con el trabajo usando búsquedas, herramientas, etc. Decide las herramientas que puedes usar y los privilegios de ejecución.
- Latencia
- La cantidad de tiempo que se debe esperar antes de recibir una respuesta para una sola solicitud. A veces medimos la primera letra y la finalización de la respuesta completa.
- Rendimiento
- La cantidad de solicitudes y tokens que se pueden procesar en un período de tiempo determinado. Esta es una métrica separada del tiempo de espera para una sola solicitud.
Los resultados de la investigación deben leerse junto con el modelo objetivo, las tareas y las condiciones experimentales. Consulte los materiales de referencia para cada elemento, el alcance de los resultados y las cuestiones restantes.
Inicio de la ayuda