ヘルプ
AI・LLMの基本から、研究のいままで。
3カテゴリ · 30項目 · 35語の用語集
「AIを学ぶ」の中から探します。言葉をスペースで区切ると、両方を含む項目を探せます。
読みたいところから
すべての学習項目
ヘルプ 30項目 · 用語 35語
AI・LLMの基礎14項目
AIが初めてでも、研究・学習・提供の意味がわかる。現実のAIの基本を、身近な例から。
このカテゴリは現実のAIの基本知識です。ゲーム内の性能・費用・日数は、経営を遊ぶための表現です。関連する操作は、各項目の「あわせて読む」から確認できます。
図解から読む
AI・機械学習・生成AIは、何が違う?
AIは、認識・予測・判断などをコンピューターで行う技術の広い呼び名です。機械学習はデータから規則性を学ぶ方法、生成AIは文章や画像などを作るAIを指します。
AI・機械学習・生成AIは、何が違う?
AIは、認識・予測・判断などをコンピューターで行う技術の広い呼び名です。機械学習はデータから規則性を学ぶ方法、生成AIは文章や画像などを作るAIを指します。
AIは、認識・予測・判断などをコンピューターで行う技術の広い呼び名です。機械学習はデータから規則性を学ぶ方法、生成AIは文章や画像などを作るAIを指します。
AI・機械学習・生成AI
同じメールでも、分類と返信づくりでは役割が違います。
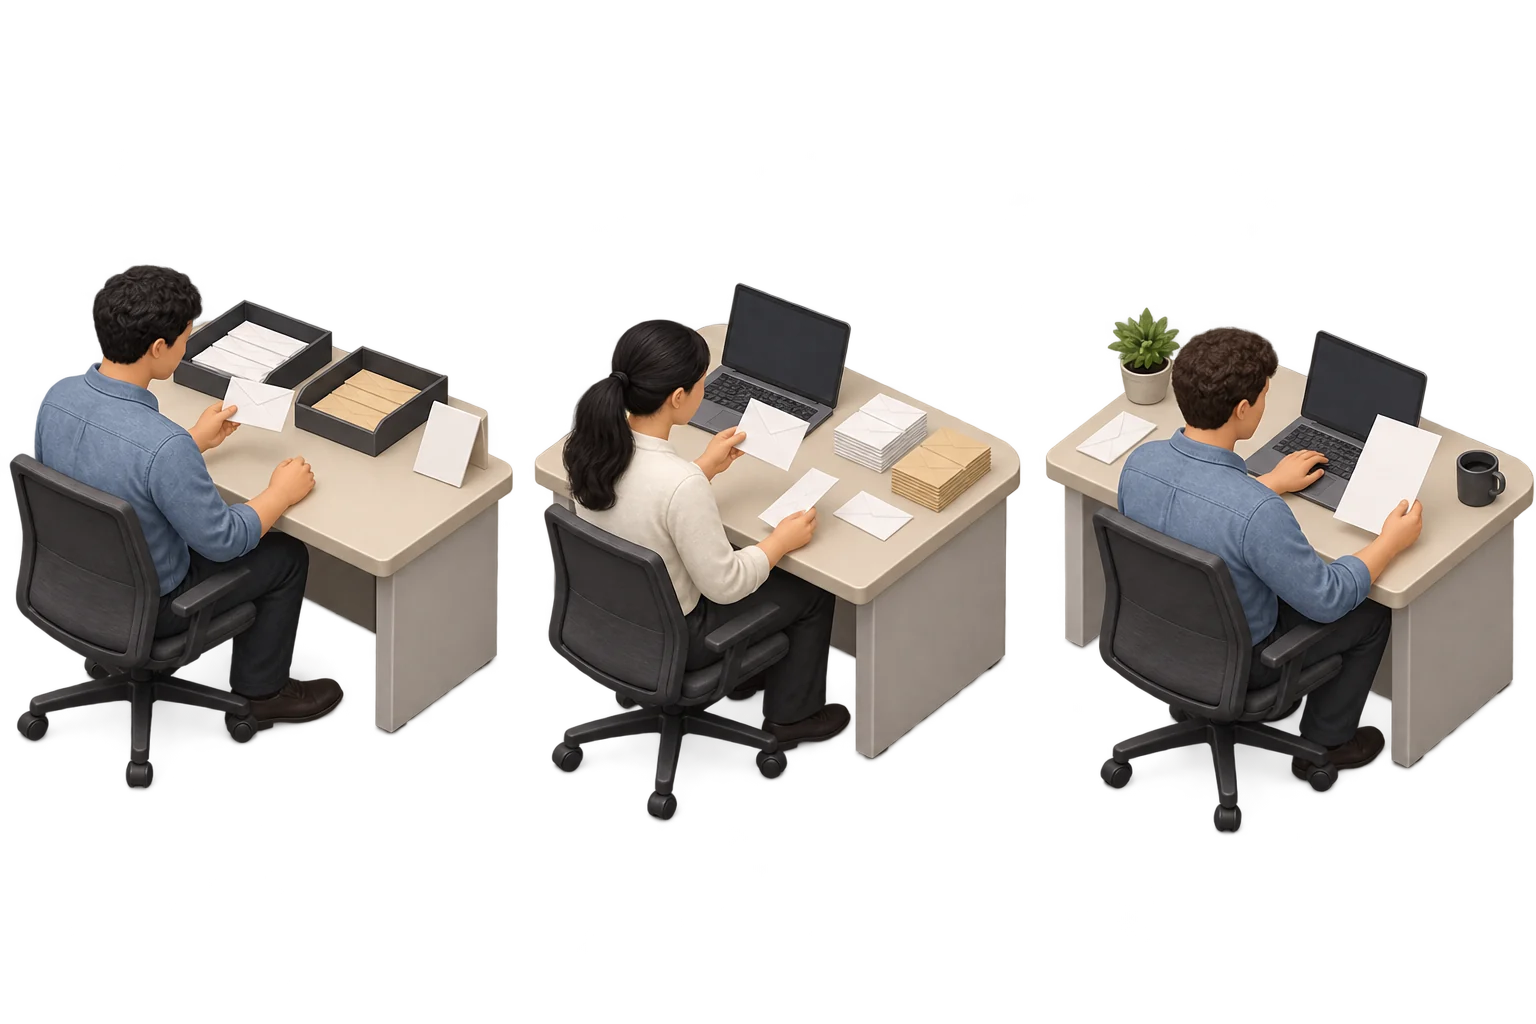
左:ルールで仕分ける
決められた条件で、メールを振り分けます。AIには、データから学ぶ方法以外の仕組みもあります。
中央:例から分類を学ぶ
分類済みのメールなどを使って規則性を学び、新しいメールを分類します。これは機械学習の例です。
右:新しい返信を作る
学んだ規則性を使い、指示に合わせた文章などを生成します。これは生成AIの例です。
機械学習と生成AIは、どちらもAIに含まれます。機械学習は学ぶ方法、生成AIは内容を作るAIの呼び名です。LLMのような生成AIは、機械学習で作られます。
机や資料に置き換えた説明用のイラストです。
深層学習は、機械学習の一種
ニューラルネットワークという計算の仕組みを、多くの層で組み合わせる方法です。LLMなどの基盤になっています。AIすべてが深層学習で作られているわけではありません。
表は左右に動かして読めます。
| 言葉 | 意味 | 例 |
|---|---|---|
| AI | 知的な作業を行う技術全体。決められたルールで動く仕組みも含む。 | ゲームの対戦相手、画像認識 |
| 機械学習(ML) | 例となるデータを使い、予測や分類の規則性を学ぶ。 | 迷惑メールの分類、売上予測 |
| 生成AI | 学んだ規則性を使って、新しい内容を生成する。 | 文章の下書き、画像や音声の生成 |
たとえば:同じメールでも、役割が違う
「迷惑メールかを判定する」は分類、「返信の文章を作る」は生成です。AI企業は、顧客が必要とする作業に合わせて技術を選びます。
AI Inc.で考えると
研究分野を選ぶときは、技術の名前だけでなく、次のモデルでどんな仕事をできるようにしたいかを考えましょう。
LLMとは?どうやって文章を作る?
LLMは「大規模言語モデル」の略です。大量の文章などから言葉の規則性を学び、文章の生成・要約・翻訳などに使われます。
LLMとは?どうやって文章を作る?
LLMは「大規模言語モデル」の略です。大量の文章などから言葉の規則性を学び、文章の生成・要約・翻訳などに使われます。
LLMは「大規模言語モデル」の略です。大量の文章などから言葉の規則性を学び、文章の生成・要約・翻訳などに使われます。
LLM:続きを計算して文章を作る
文脈から次の候補を計算し、続きを重ねます。
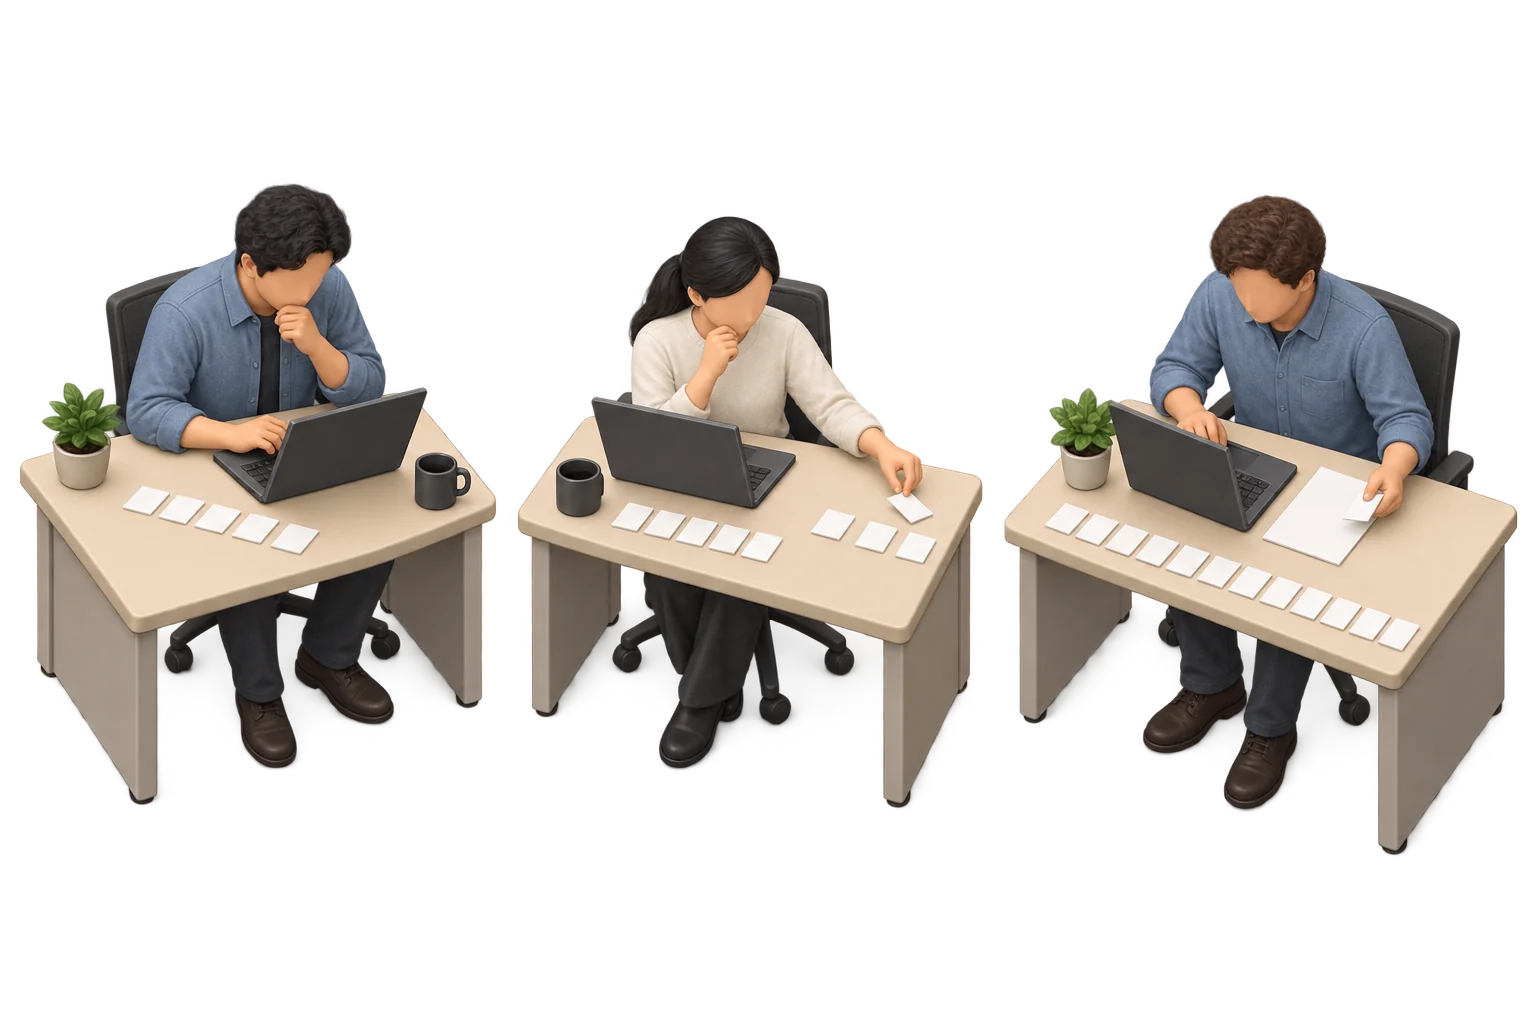
文脈を受け取る
指示や質問、それまでに生成した内容を使います。
次の候補を計算する
次に来るトークンの候補と確率を計算します。
続きを重ねて文章にする
新しく生成した内容も使い、次のトークンを計算する処理を繰り返します。
紙片はトークンを表す比喩です。トークンは文章を扱う小さな単位で、単語と一致するとは限りません。文章の自然さと、事実の正しさは別です。
机や資料に置き換えた説明用のイラストです。
続きの候補を計算する
文章を小さな単位のトークンに分け、入力と、それまでに生成した内容をもとに、次のトークンの候補と確率を計算します。この処理を繰り返して回答を作ります。
モデルと、チャットアプリは別
モデルは入力から出力を計算する部分です。チャットアプリは、会話履歴、検索、ファイル、ツールなどを組み合わせてモデルを使います。どの機能が使えるかはアプリにも依存します。
たとえば:「雨なので、」の続きを考える
「傘を持っていく」「外出を延期する」など、前後の文脈に合う候補があります。LLMは、こうした続きをより長い文章でも計算します。実際の処理は単語単位とは限りません。
気をつけること
自然な文章を書けても、内容が正しいとは限りません。学習した知識、渡された資料、検索した情報の範囲を確認する必要があります。
AI Inc.で考えると
完成したモデルと、顧客へ提供するAPI商品は別の段階です。モデルを作った後に、使い方や料金、供給を整える理由につながります。
トークンとコンテキストウィンドウとは?
トークンは、モデルが扱う文章などの小さな単位です。コンテキストウィンドウは、一度の処理で参照できる情報の長さの上限を表します。
トークンとコンテキストウィンドウとは?
トークンは、モデルが扱う文章などの小さな単位です。コンテキストウィンドウは、一度の処理で参照できる情報の長さの上限を表します。
トークンは、モデルが扱う文章などの小さな単位です。コンテキストウィンドウは、一度の処理で参照できる情報の長さの上限を表します。
コンテキスト:今回使う情報
机の上の資料と、棚にしまった資料を分けて考えます。
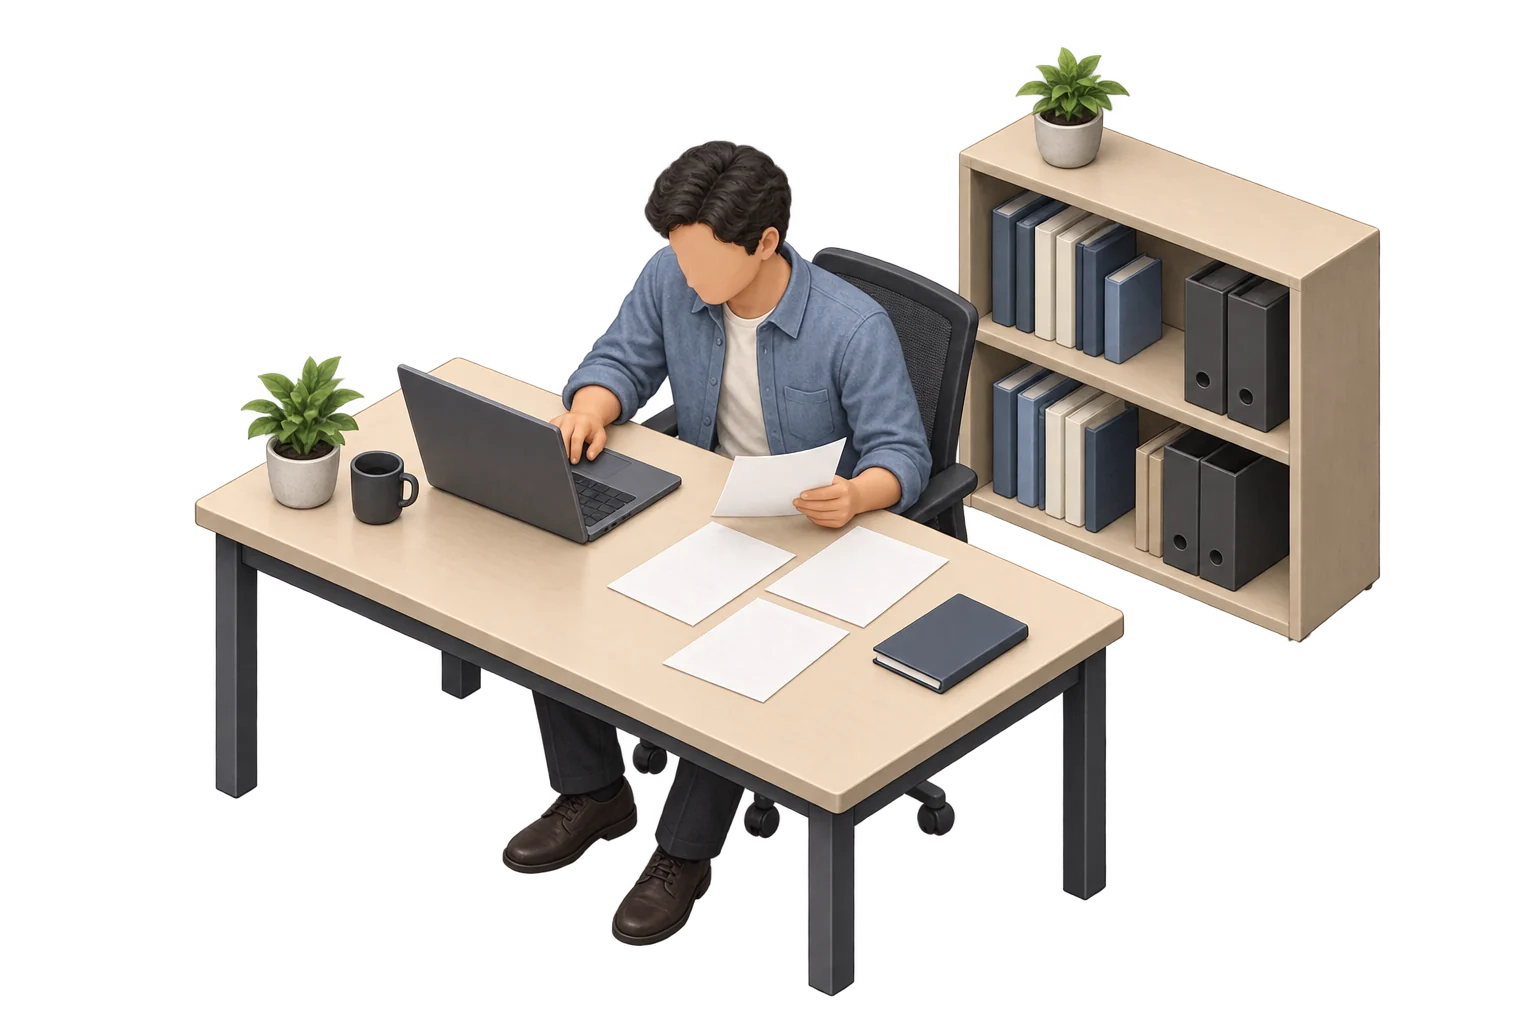
机の上:今回渡された情報
指示・質問・会話履歴・資料のうち、アプリが今回の処理に渡したものがコンテキストに入ります。
棚の中:まだ渡していない資料
保存された資料や過去の会話でも、今回渡されていなければ、参照できるとは限りません。
コンテキストウィンドウは参照できる情報の長さの上限で、通常はトークン数で表します。資料を渡すことは追加学習とは別です。長い資料を渡せても、すべてを正確に使えるとは限りません。
机や資料に置き換えた説明用のイラストです。
文字数・単語数とは一致しない
トークンは単語、単語の一部、文字などになります。分け方はモデルや言語で変わるため、日本語の1文字を常に1トークンと数えることはできません。
会話や資料も、参照する情報になる
アプリが渡す指示、会話履歴、資料などがコンテキストに入ります。入力と出力の上限の扱いはモデルによって異なります。長い資料を入れられても、そのすべてを正確に利用できる保証はありません。
たとえば:資料を机に広げるイメージ
コンテキストは、その回答を作るために机に広げた資料に近いものです。資料を机に置くことと、モデル自体を追加学習することは別です。
AI Inc.で考えると
扱う情報が増えると、現実のサービスでは計算やメモリの負担も変わります。ゲームでは、顧客へ提供するための推論需要と供給を確認しましょう。
パラメータ数が多いほど、よいモデル?
パラメータは、学習で調整するモデル内部の数値です。モデル規模を表す手がかりになりますが、数が多いだけで用途に合うとは判断できません。
パラメータ数が多いほど、よいモデル?
パラメータは、学習で調整するモデル内部の数値です。モデル規模を表す手がかりになりますが、数が多いだけで用途に合うとは判断できません。
パラメータは、学習で調整するモデル内部の数値です。モデル規模を表す手がかりになりますが、数が多いだけで用途に合うとは判断できません。
モデル選び:規模・用途・費用
数の多さだけでなく、使う仕事の条件で比べます。
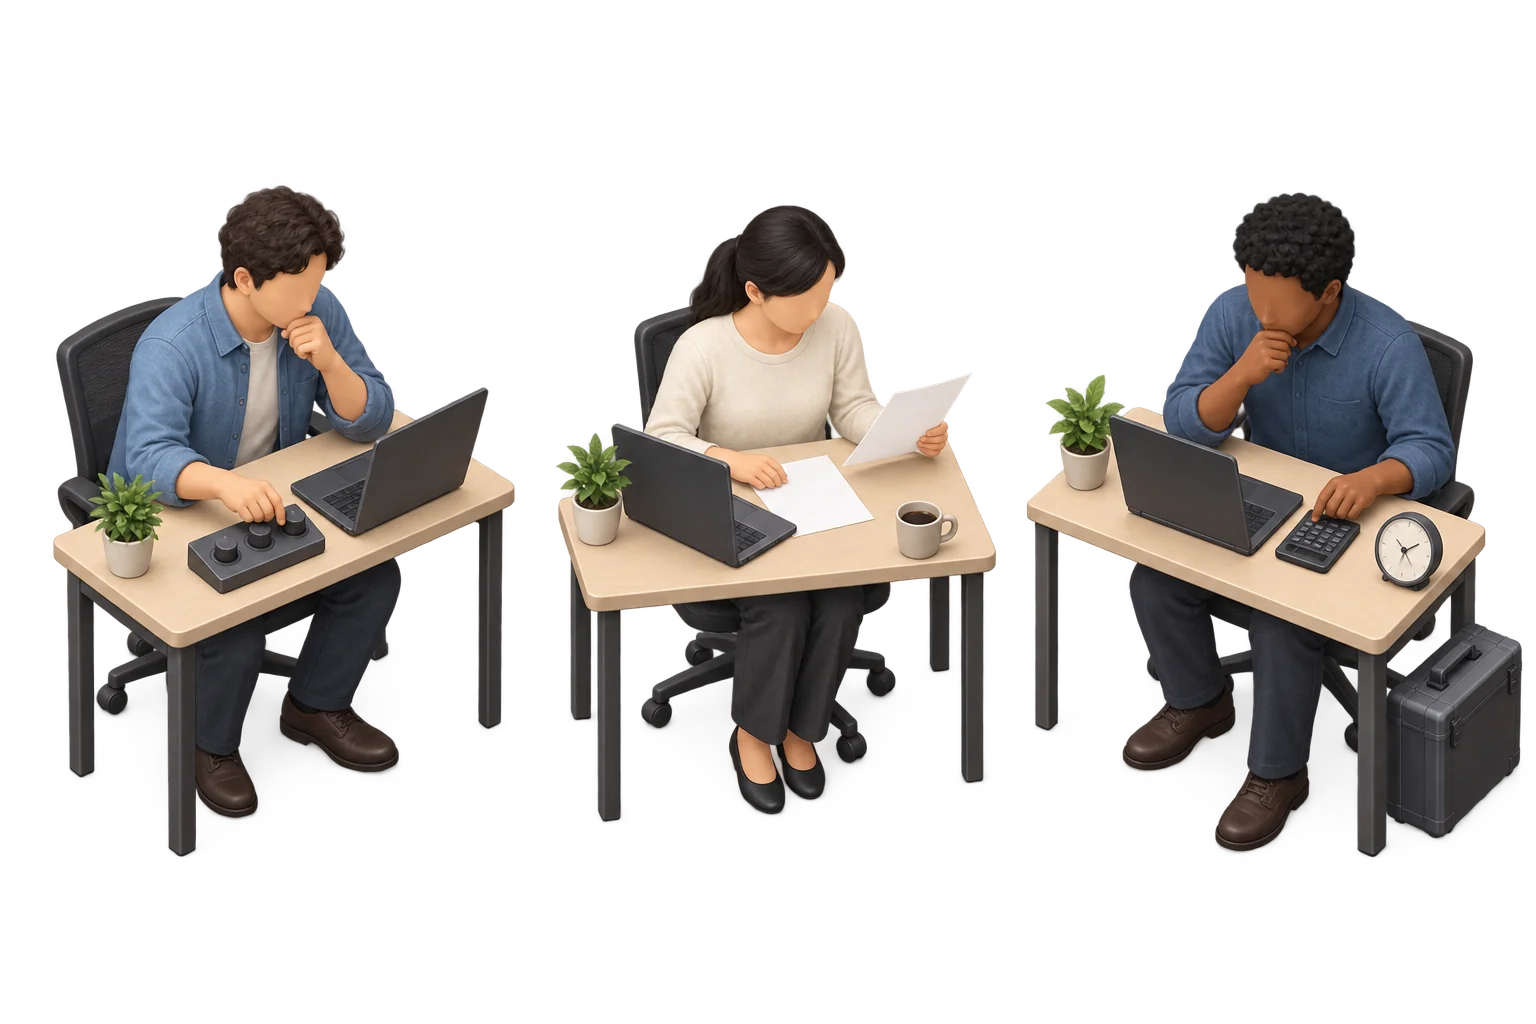
左:学習で調整する数値
パラメータはモデル内部の数値です。数が多いだけでは用途に合うと判断できません。
中央:使う仕事で確かめる
実際の質問や資料で試し、必要な品質を満たすか確かめます。
右:資源と費用も比べる
必要な品質を満たす候補の、速度・費用・計算やメモリの負担を比べます。
つまみは、内部の数値を調整することを表す比喩です。パラメータ数は知っている事実の数ではありません。データ・設計・学習方法も結果に関係します。
机や資料に置き換えた説明用のイラストです。
学習で調整する数値
ニューラルネットワークの重みなどを指します。大量の例から、目的に合う出力を出せるように調整します。パラメータ数は、知っている事実の数を表すものではありません。
性能・資源・用途を一緒に見る
規模に加え、データの質、設計、学習方法が結果に関係します。大きいモデルは一般に多くの計算資源やメモリを必要としますが、構成や最適化でも負担は変わります。実際の用途で比較しましょう。
たとえば:短い分類と、複雑な文章作成
短い問い合わせの分類なら、軽いモデルで十分な場合があります。複雑な文章作成では、より高い能力が必要かもしれません。必要な品質を満たすモデルの速度と費用を比較します。
AI Inc.で考えると
モデル設計では、予測性能だけでなく、学習費用と推論の負荷・速度も見てください。規模を増やす判断と、事業として続けられる判断を合わせます。
学習と推論は、どう違う?
学習はモデルの内部の数値を調整する工程、推論は学習済みのモデルを使って答えを計算する工程です。利用者への回答にも計算資源が必要です。
学習と推論は、どう違う?
学習はモデルの内部の数値を調整する工程、推論は学習済みのモデルを使って答えを計算する工程です。利用者への回答にも計算資源が必要です。
学習はモデルの内部の数値を調整する工程、推論は学習済みのモデルを使って答えを計算する工程です。利用者への回答にも計算資源が必要です。
学習と推論
モデルを作るときも、使うときも計算が必要です。
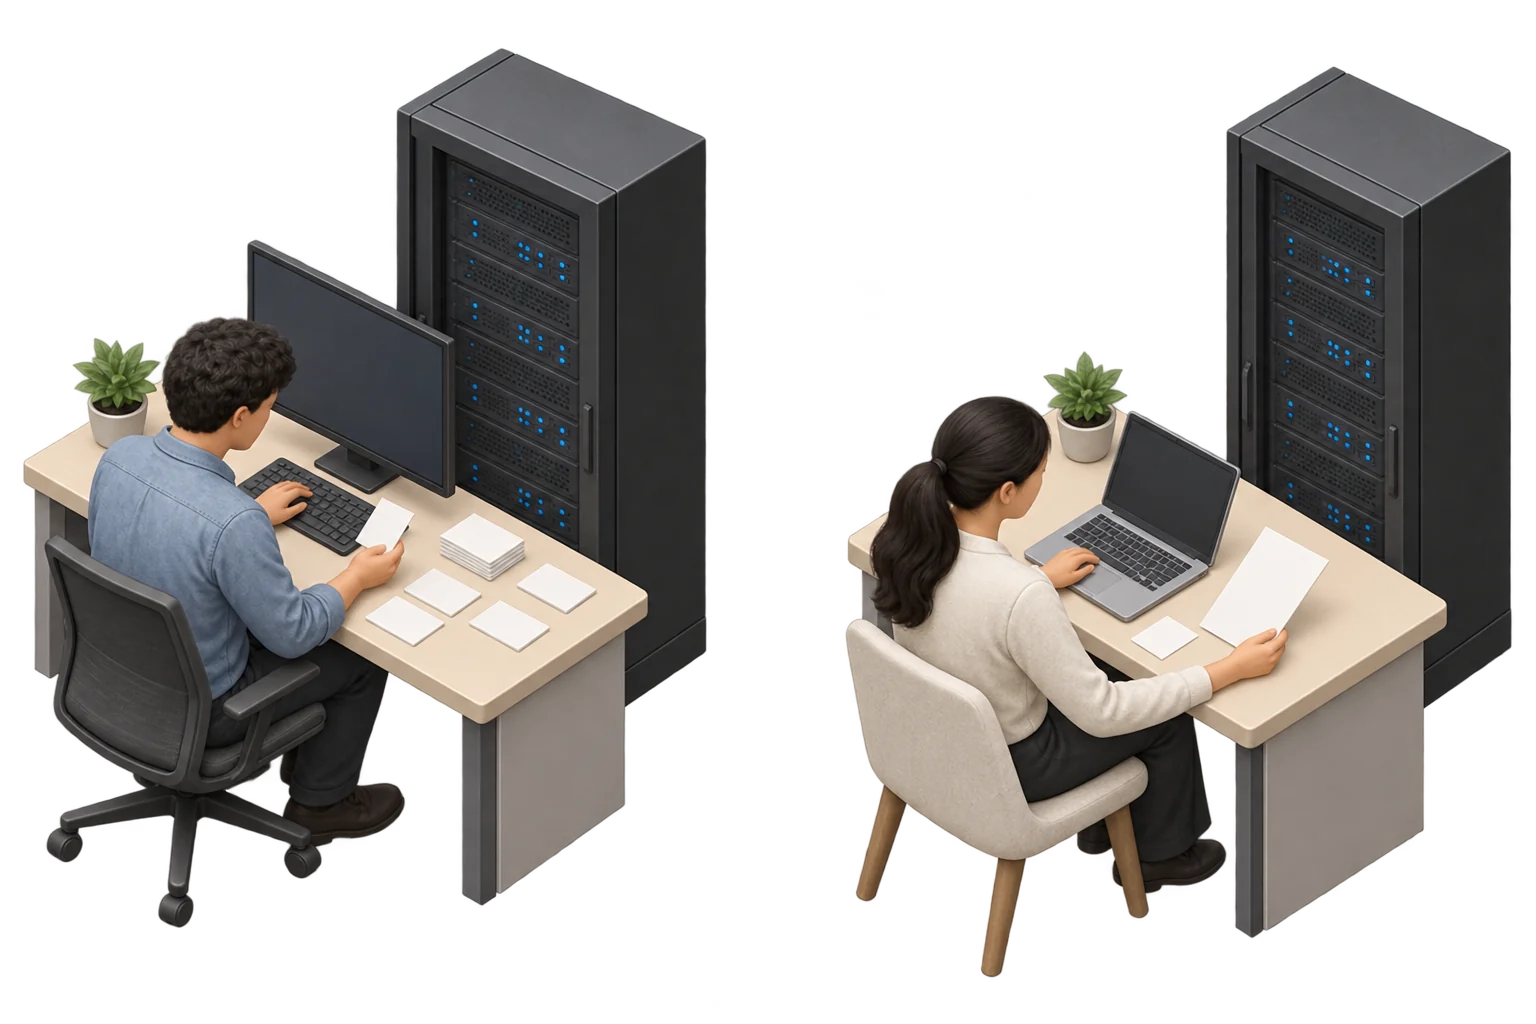
学習:モデルを調整する
例となるデータを使い、モデル内部の数値を調整します。
推論:学習済みモデルを使う
新しい質問などを入力し、答えを計算します。
通常の推論では、モデル内部の数値は更新しません。会話を保存することと、追加学習することも別です。
机や資料に置き換えた説明用のイラストです。
学習は、例からモデルを調整する時間
例に対する出力と学習の目標を比べ、内部の数値を調整します。モデルを作る工程と、作ったモデルを利用する工程を分けて考えると、資源と費用の違いを理解しやすくなります。
推論は、いまの依頼に答えを出す時間
学習済みの数値を使い、入力から出力を計算します。通常の推論は、回答するたびに内部の数値を学習し直す処理ではありません。会話や資料を今回の入力として参照することは、追加学習とは別です。
表は左右に動かして読めます。
| 確認すること | 学習 | 推論 |
|---|---|---|
| 目的 | 例からモデルのパラメータを調整する | 新しい入力に対して出力を計算する |
| 入力の例 | 学習用の文章、質問と回答の例 | 利用者の質問、参照する資料 |
| 内部の数値 | 学習によって更新する | 通常の推論では更新しない |
| 資源の使い道 | モデルを作る・改良するための計算 | 顧客の依頼を処理するための計算 |
たとえば:作った後も、運用費がかかる
問い合わせに答えるモデルを完成させても、利用者が質問するたびに推論が必要です。同時に使う人が増えると、必要な提供能力も増えます。
気をつけること
会話の保存や、入力を将来の学習に利用するサービス方針と、いまの回答中にパラメータが更新されることは別です。
AI Inc.で考えると
学習用と推論用の計算資源は、別の役割です。学習が完成しても、推論への配分が不足すれば顧客への供給が足りなくなります。
事前学習とファインチューニングとは?
事前学習は広いデータから基本となる規則性を学ぶ工程、ファインチューニングは学習済みモデルを追加のデータで調整する工程です。
事前学習とファインチューニングとは?
事前学習は広いデータから基本となる規則性を学ぶ工程、ファインチューニングは学習済みモデルを追加のデータで調整する工程です。
事前学習は広いデータから基本となる規則性を学ぶ工程、ファインチューニングは学習済みモデルを追加のデータで調整する工程です。
事前学習と追加学習
土台を作り、使う仕事に合わせて調整します。
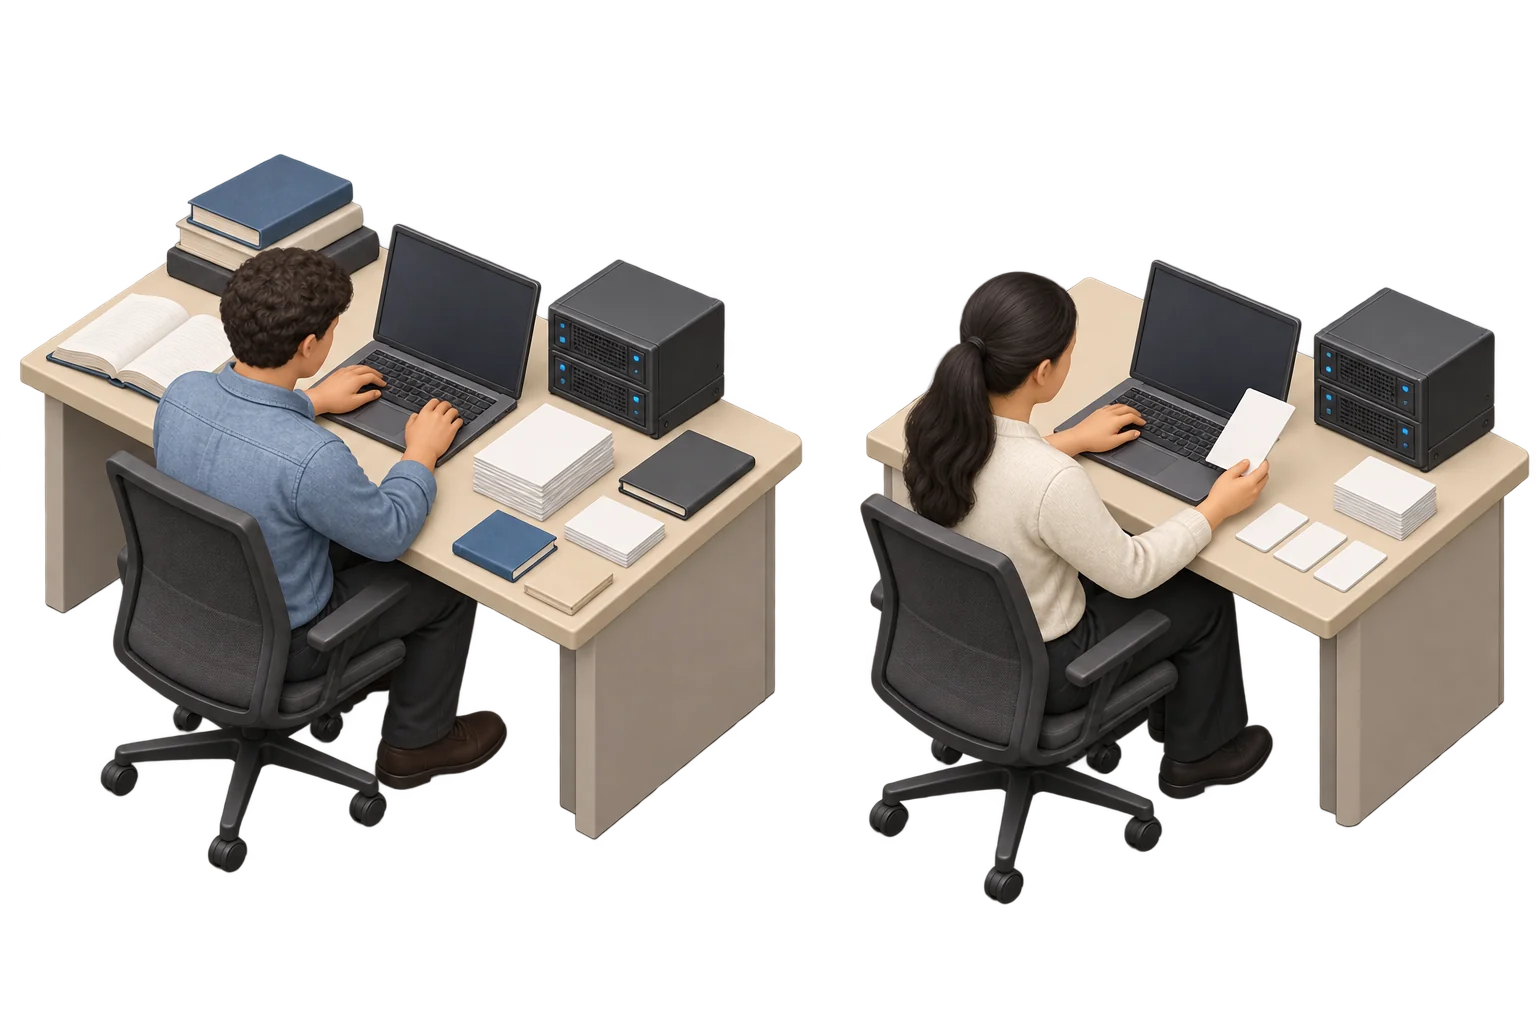
左:幅広い例で土台を作る
多くの文章などを使い、基本となる規則性を学びます。モデル内部の数値を調整する工程です。
右:用途に合う例で調整する
学習済みモデルを出発点に、仕事や出力形式に合う例で追加学習します。ファインチューニングでは内部の数値を更新します。
プロンプトで指示することやRAGで資料を渡すことは、追加学習とは別です。学習で改善したかは、学習に使っていない例で確認します。
机や資料に置き換えた説明用のイラストです。
事前学習で、土台を作る
多くの言語モデルは、文章の続きを予測するなどの課題を大量に解き、言葉の規則性を学びます。学習済みの土台を利用すれば、毎回ゼロからモデルを作る必要はありません。
追加学習で、用途へ寄せる
質問と望ましい回答の例で指示に従いやすくしたり、特定の仕事や出力形式に合わせたりします。指示への対応や人の評価を使う学習は、事前学習後のポストトレーニングに含まれます。
たとえば:問い合わせの分類形式を揃える
問い合わせ文と「請求」「契約」「操作」の分類例を使い、決まった形式で出力しやすくする追加学習が考えられます。改善したかは、学習に使わなかった例で確認します。
気をつけること
追加学習は、資料を検索するRAGとは異なります。新しい事実を確実に記憶させる方法として、無条件に選ぶものではありません。
AI Inc.で考えると
親モデルを使った派生開発は、既存の土台を活かす考え方につながります。ゲームで引き継ぐ性能や費用の条件は、対象の確認画面を読んでください。
学習データは、量だけ増やせばいい?
データには量だけでなく、正確さ、多様さ、用途との近さが必要です。学習で見た例にだけ強く、新しい例に弱い状態を「過学習」と呼びます。
学習データは、量だけ増やせばいい?
データには量だけでなく、正確さ、多様さ、用途との近さが必要です。学習で見た例にだけ強く、新しい例に弱い状態を「過学習」と呼びます。
データには量だけでなく、正確さ、多様さ、用途との近さが必要です。学習で見た例にだけ強く、新しい例に弱い状態を「過学習」と呼びます。
学習データ:量・質・確かめ方
例を増やすだけでなく、整えて、別の例で確かめます。
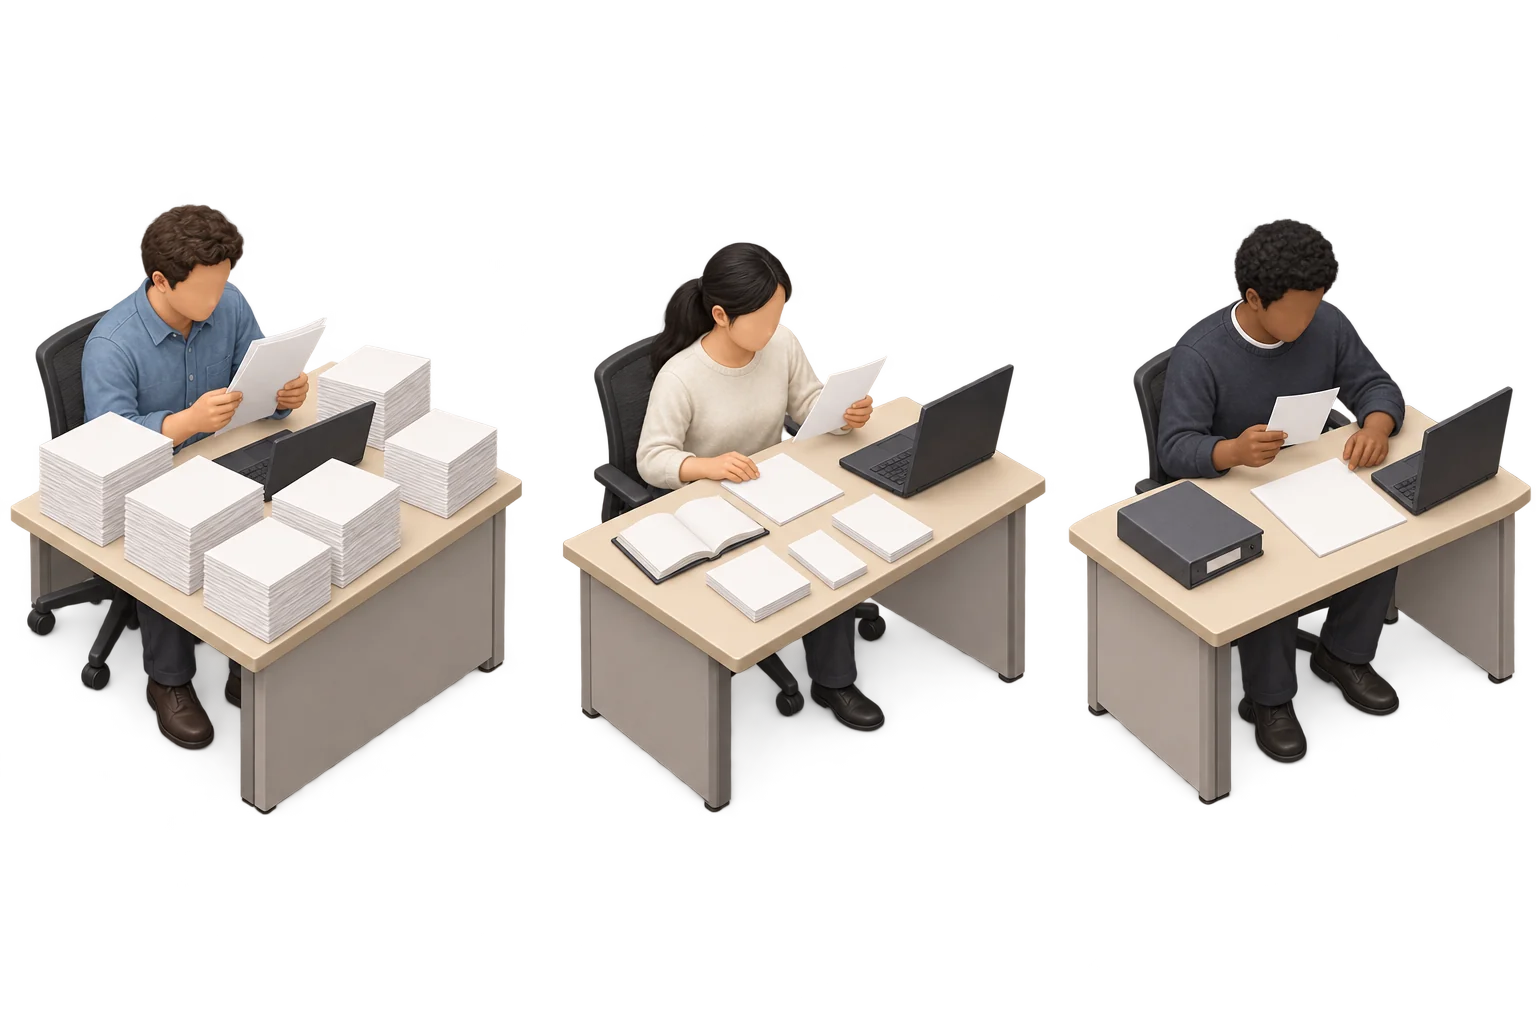
量:似た例ばかりになっていないか
例の数を増やしても、重複や偏りが多ければ、使う場面を十分にカバーできません。
質:使う場面に合う例を整える
誤りや重複を見直し、実際の質問・言語・利用者に近い、幅のある例を用意します。
評価:使っていない例で確かめる
学習用・調整のための検証用・最後のテスト用を分けます。学習に使わなかった例で確認します。
学習で見た例にだけ強く、新しい例に弱い状態が過学習です。データの量・品質・用途との近さを合わせて見ます。
机や資料に置き換えた説明用のイラストです。
使う場面に近い例を整える
誤りや重複、偏りの多いデータは、結果にも影響します。どんな質問、言語、利用者を想定するかを決め、実際の利用を代表する例を用意します。
学習と評価のデータを分ける
学習で覚えた例だけで評価すると、新しい入力にも対応できるかを判断しにくくなります。調整に使う検証用データと、最後に確かめるテスト用データも区別します。
たとえば:短い質問だけで学習した場合
短い定型文に強くても、長い相談や言い回しの違う質問に弱いかもしれません。利用者が実際に書く例も含めて、未使用のデータで確かめます。
AI Inc.で考えると
データの許諾取得、整備、学習への選択は別の段階です。現実のデータ品質の考え方を知ると、ゲームで整備を行う目的もつかみやすくなります。
プロンプトを書くことは、学習なの?
プロンプトは、モデルへ渡す指示や情報です。通常は、その回答の条件を変えるもので、モデルのパラメータを更新する学習とは異なります。
プロンプトを書くことは、学習なの?
プロンプトは、モデルへ渡す指示や情報です。通常は、その回答の条件を変えるもので、モデルのパラメータを更新する学習とは異なります。
プロンプトは、モデルへ渡す指示や情報です。通常は、その回答の条件を変えるもので、モデルのパラメータを更新する学習とは異なります。
プロンプト:目的・資料・出力形式
何をしてほしいか、何を使うか、どう返すかを伝えます。
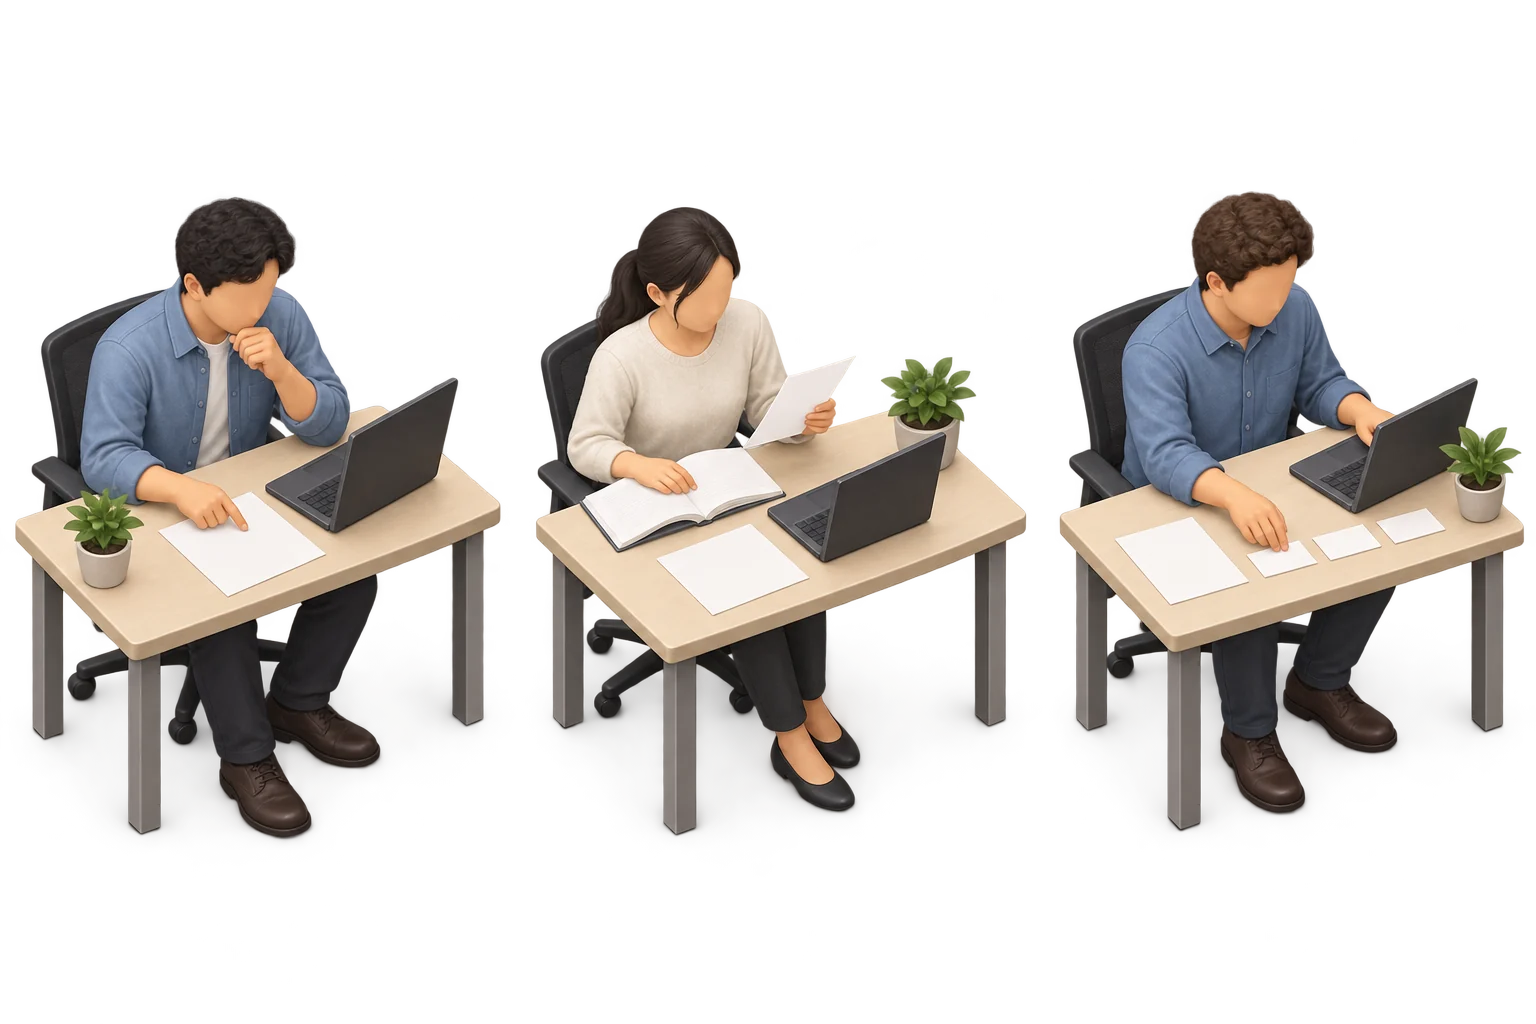
目的:してほしいことを伝える
「議事録を要約する」など、依頼する作業を具体的に書きます。
資料:使う範囲を伝える
参照してほしい議事録を渡し、「この資料だけを使う」と範囲を示します。
形式:答えの形を伝える
「決定事項を3つの箇条書きにする」など、出力の形を指定します。
指示や資料を渡すことは、通常、モデルの追加学習とは別です。指示を具体的にしても誤りは起こるため、回答を資料と照合します。
机や資料に置き換えた説明用のイラストです。
目的・資料・出力形式を伝える
何をしてほしいか、どの情報を使うか、どんな形で答えてほしいかを具体的に書きます。必要なら、望ましい出力の例も渡します。
会話の続きは、参照する情報の続き
過去の発言を使えるのは、アプリがそれをモデルへ渡すなどの仕組みがあるためです。会話中に新しい情報を使えたことだけでは、モデルが恒久的に学習したとは言えません。
たとえば:「要約して」を具体的にする
「次の議事録だけを使い、決定事項を3つの箇条書きにしてください。資料にないことは補わないでください。」のように、目的と範囲、形式を伝えます。
気をつけること
指示を詳しく書くことは助けになりますが、誤りをなくす保証にはなりません。出力を実際の資料と照合しましょう。
AI Inc.で考えると
ゲーム内のモデル設計や学習開始と、現実のチャットで指示を書く操作は異なります。設計を保存しただけでは、本学習の費用と進捗は発生しません。
RAGと埋め込みとは?追加学習と何が違う?
RAGは、回答に必要な資料を検索し、見つけた内容をモデルへ渡して生成する方法です。検索する資料は、モデルのパラメータとは別に管理します。
RAGと埋め込みとは?追加学習と何が違う?
RAGは、回答に必要な資料を検索し、見つけた内容をモデルへ渡して生成する方法です。検索する資料は、モデルのパラメータとは別に管理します。
RAGは、回答に必要な資料を検索し、見つけた内容をモデルへ渡して生成する方法です。検索する資料は、モデルのパラメータとは別に管理します。
RAG:資料を探してから答える
検索した資料を、回答のためにモデルへ渡します。
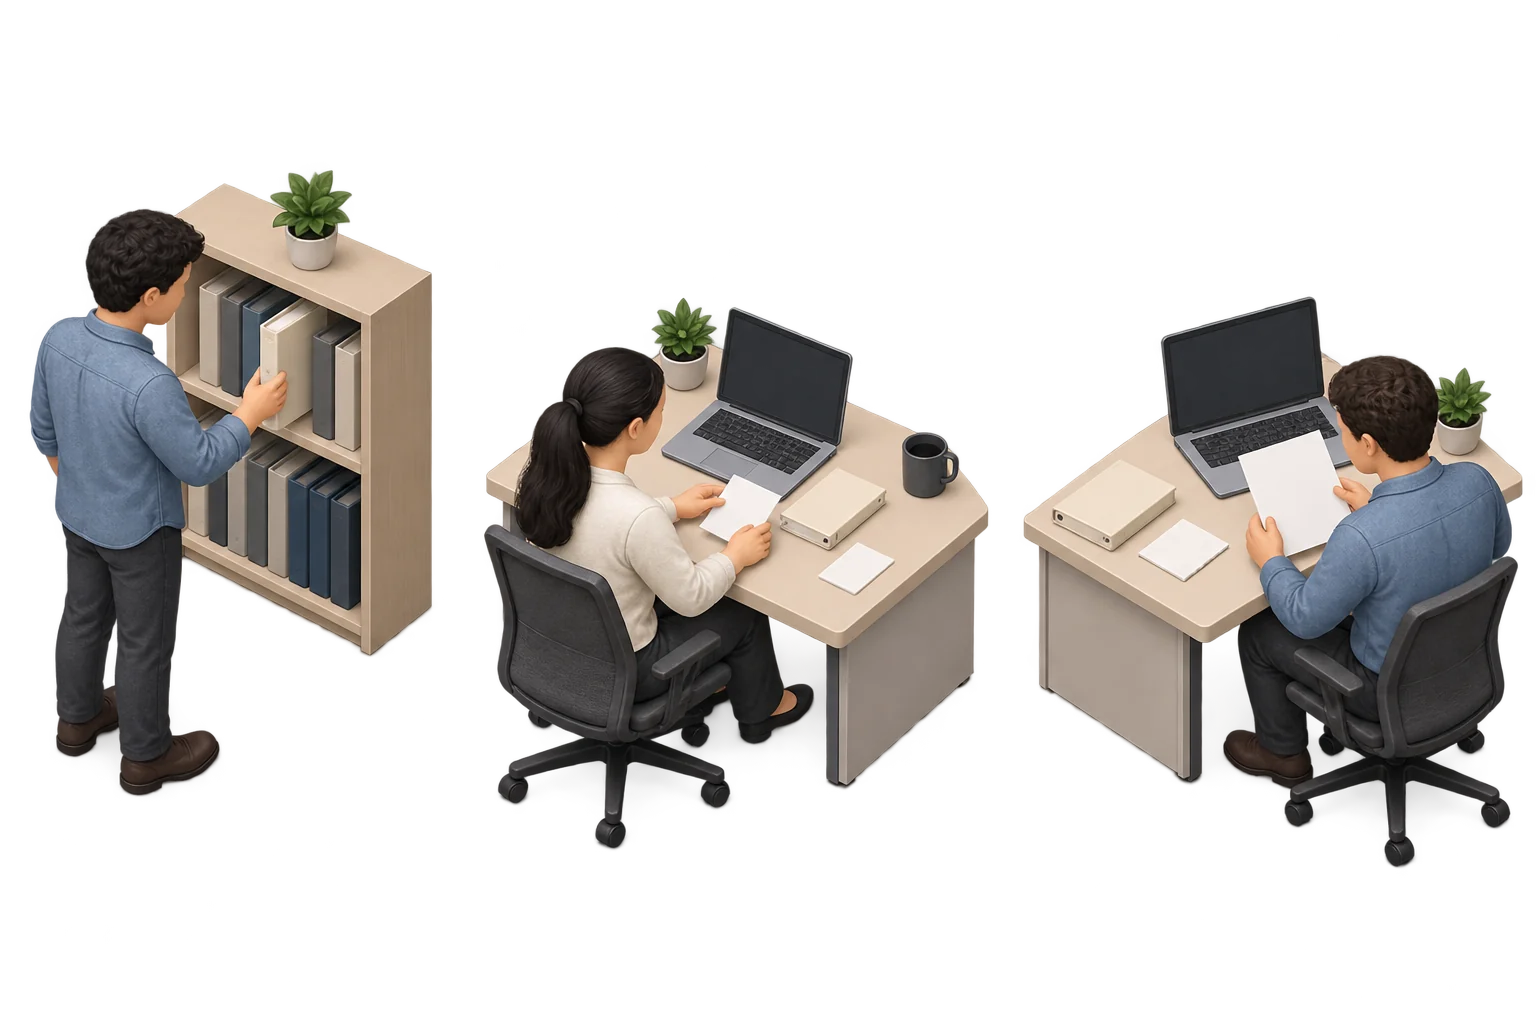
関係する資料を探す
質問に合うマニュアルなどから、必要な部分を検索します。
質問と一緒に渡す
見つけた資料を、回答で参照する情報としてモデルに渡します。
資料を参照して答える
モデルが回答を生成します。資料が答えを支えているかも確認します。
資料を渡すことと、モデルの追加学習は別です。資料が古い場合や、回答が資料から外れる場合もあるため、RAGだけで正しさは保証されません。
机や資料に置き換えた説明用のイラストです。
探す → 資料を渡す → 答える
質問に関係する社内マニュアルなどを探し、該当部分を質問と一緒に渡します。更新された資料を参照させるために、モデル全体を再学習する必要はありません。
埋め込みで、近い内容を探す
埋め込み(Embedding)は、文章などの特徴を数値の並びで表す方法です。その近さを検索に利用できます。RAGには、キーワード検索や両者を組み合わせる方法もあります。
情報を使わせる方法の違い
問い合わせ対応を例に、今回渡す情報と、学習で調整する数値を分けます。
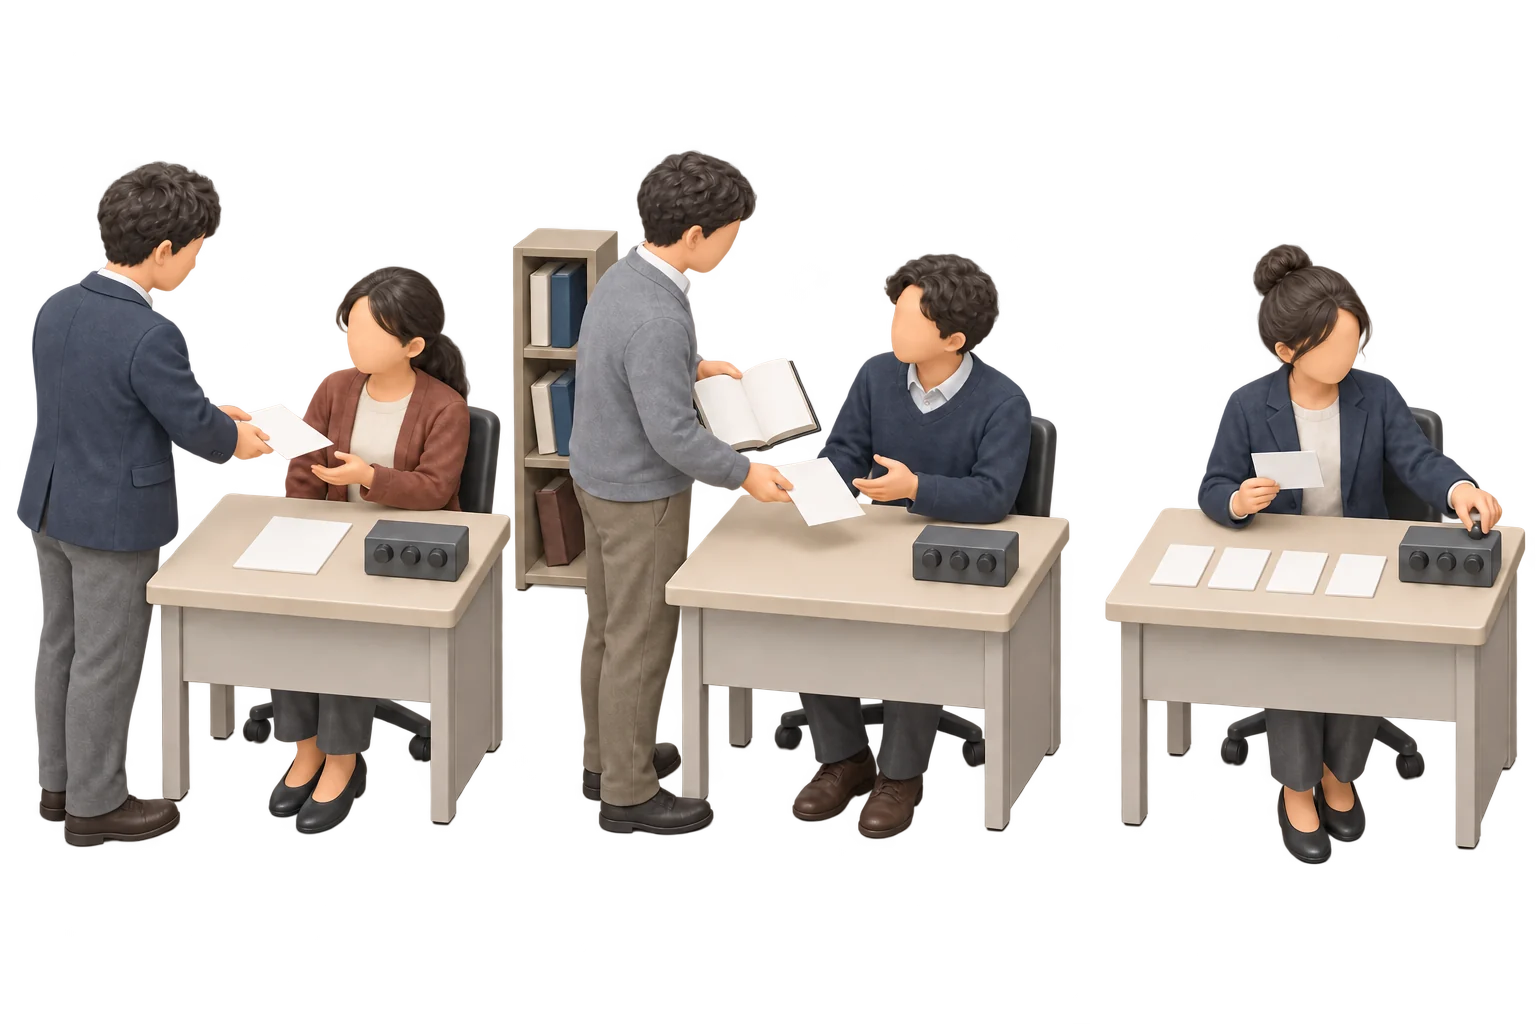
左:プロンプト
「返信を2文にする」など、今回の指示や資料を渡します。通常の回答では、モデル内部の数値を更新しません。
中央:RAG
質問に合うマニュアルを検索し、必要な部分を指示と一緒に渡します。資料を探して渡す処理自体は、モデル内部の数値を更新しません。
右:ファインチューニング
問い合わせと望ましい分類の例で、学習済みモデルの内部の数値を調整します。「請求・契約・操作」の分類形式に合わせる用途などです。
3つは併用できます。RAGでは、検索した資料をプロンプトに含めます。更新される資料を使いたいのか、出力の形式を調整したいのかを考え、実際の質問で確かめます。
つまみはモデル内部の数値を表す比喩です。3つの場面は方法の比較で、作業の順番ではありません。
たとえば:営業時間が変わったとき
新しい営業時間が載った資料を検索し、回答の根拠として渡します。古い資料を検索してしまえば、RAGでも古い答えになり得ます。
気をつけること
資料の取り違えや、資料にない情報の生成は起こり得ます。検索結果と出力の両方を評価し、参照元が実際に答えを支えているか確認します。
AI Inc.で考えると
これは現実のAIサービスの基本知識です。ゲームでRAGを個別設定できるという意味ではありません。用途に合ったモデルとデータを選ぶ考え方につながります。
ハルシネーションとは?なぜ答えを確認する?
ハルシネーションは、事実や資料に裏付けられない内容を、もっともらしく生成することです。存在しない情報や出典が、自然な文章に混ざる場合があります。
ハルシネーションとは?なぜ答えを確認する?
ハルシネーションは、事実や資料に裏付けられない内容を、もっともらしく生成することです。存在しない情報や出典が、自然な文章に混ざる場合があります。
ハルシネーションは、事実や資料に裏付けられない内容を、もっともらしく生成することです。存在しない情報や出典が、自然な文章に混ざる場合があります。
ハルシネーションと根拠の確認
読みやすい回答でも、出典を開いて確かめます。
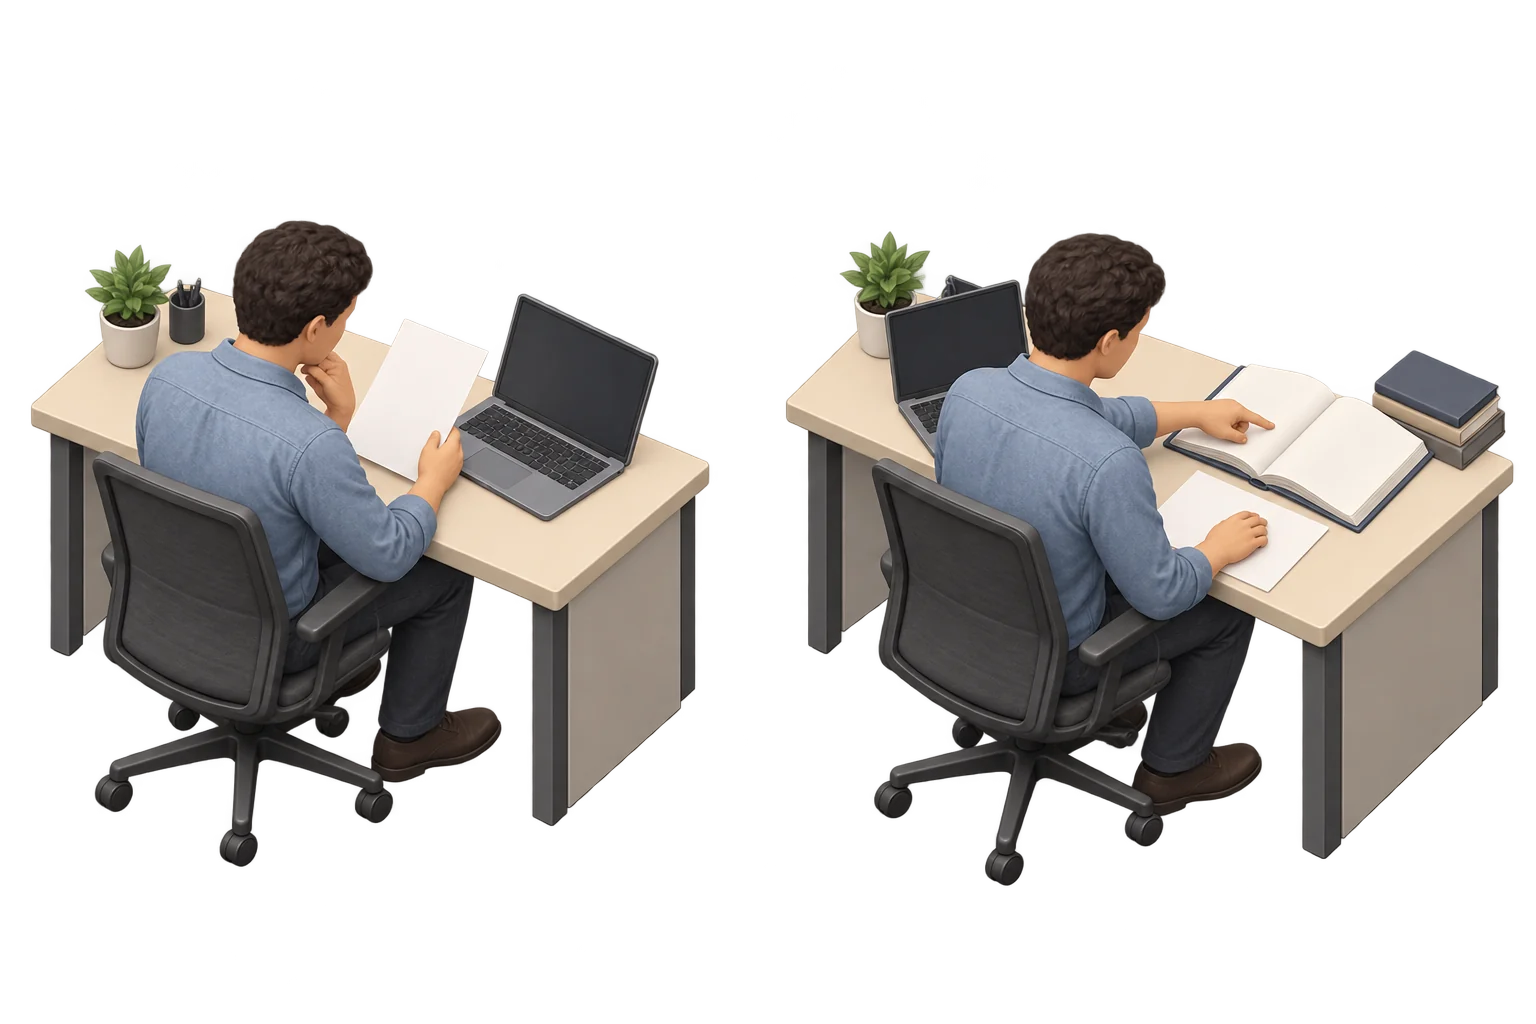
左:自然な回答を読む
詳しい説明や具体的な資料名だけでは、事実の裏付けがあるとは判断できません。
右:原本と照合する
出典を実際に開き、回答を支える箇所があるか、数値・日付・人物名が合うかを確認します。
出典が実在していても、回答を支えているとは限りません。根拠が見つからない内容は、そのまま事実として扱わず、別の資料も確認します。
机や資料に置き換えた説明用のイラストです。
文章の自然さと、事実の正しさは別
LLMは、文脈に合う出力を計算します。自信のある表現や詳しい説明だけでは、根拠があると判断できません。モデルが検索や計算を使ったかも、アプリの仕組みによります。
根拠を、実際に開いて確認する
資料の該当箇所、数値、日付、人物名などを照合します。引用先が存在していても、回答を支えているとは限りません。わからないと答えるかも、評価に含めます。
たとえば:ありそうな資料名を作ってしまう
「この機能の出典を教えて」と尋ねた際に、実在しない説明書を挙げることがあります。資料名が具体的でも、原本があるかを確認します。
気をつけること
検索やRAG、追加学習などは誤りを減らす助けになりますが、正しさを保証しません。生成のばらつきを抑えても、誤った答えが固定される場合があります。
AI Inc.で考えると
外部評価は、何をどこまで確認したかを読む資料です。高い性能や評価結果だけで、すべての用途の安全性が保証されるわけではありません。
ベンチマークが高ければ、そのまま提供できる?
ベンチマークは、決まった課題で性能を比べるための評価です。顧客の実際の用途で役立つかは、別に確かめる必要があります。
ベンチマークが高ければ、そのまま提供できる?
ベンチマークは、決まった課題で性能を比べるための評価です。顧客の実際の用途で役立つかは、別に確かめる必要があります。
ベンチマークは、決まった課題で性能を比べるための評価です。顧客の実際の用途で役立つかは、別に確かめる必要があります。
評価:共通の課題と、実際の用途
共通の課題と、仕事の条件を分けて確認します。
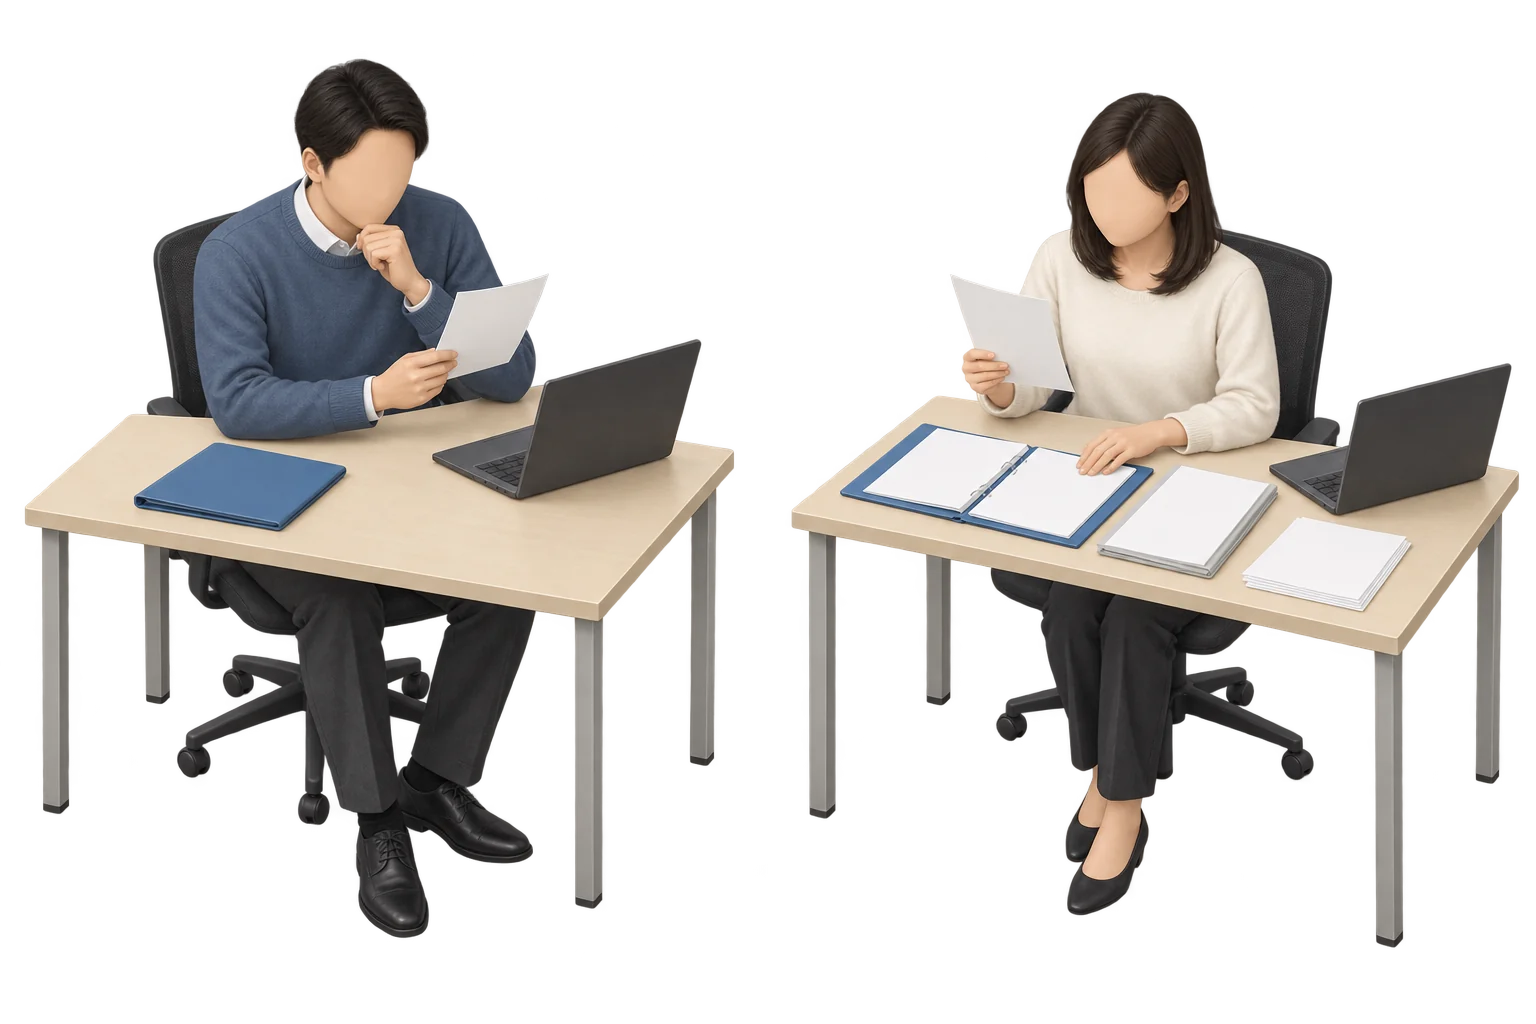
左:共通の課題の結果を読む
同じ問題や採点条件を使い、モデルの性能を比べます。結果用紙は、試した課題の範囲を確かめて読み取ります。
右:使う仕事の条件で試す
実際の資料や質問を使い、必要な数値や期限が残るかを確認します。応答速度や費用も合わせて見ます。
ベンチマークの結果だけで、どの仕事にも役立つとは判断できません。顧客の用途に合う条件を先に決め、モデルや資料を変えた後も確かめます。
紙とフォルダーは、共通課題の結果と実際の用途での確認を説明する比喩です。左右は工程の順番ではなく、どちらも合格・安全性・提供の成功を保証しません。人物や資料の数はテスト数を表しません。
実際の仕事に近い条件で試す
利用する言語、資料、質問の長さ、必要な形式などを揃えて比較します。学習に使っていない例や、答えられない質問も含めます。
モデルだけでなく、サービス全体を見る
正答率や根拠だけでなく、応答速度、費用、検索の失敗、ツールの動作なども確認します。平均点だけでは、特定の条件に弱いモデルを見落とす場合があります。
たとえば:要約が上手でも、数字を落とすかもしれない
読みやすい要約でも、請求額や期限が抜けていれば用途に合いません。何を残す必要があるかを先に決め、その条件で評価します。
気をつけること
評価結果は、試した条件と時点での観測です。未評価の用途まで保証するものではありません。モデルや資料を変更した後も、結果を確認します。
AI Inc.で考えると
モデルの評価、公開、先行提供、顧客移行を分けて判断する理由につながります。試験の結果と、実際の供給や売上の結果を合わせて見ましょう。
GPU・メモリ・応答速度は、どう関係する?
LLMは多くの数値を計算するため、GPUなどの並列計算が得意な設備を利用します。処理能力だけでなく、メモリや同時利用、回答の長さも提供に影響します。
GPU・メモリ・応答速度は、どう関係する?
LLMは多くの数値を計算するため、GPUなどの並列計算が得意な設備を利用します。処理能力だけでなく、メモリや同時利用、回答の長さも提供に影響します。
LLMは多くの数値を計算するため、GPUなどの並列計算が得意な設備を利用します。処理能力だけでなく、メモリや同時利用、回答の長さも提供に影響します。
推論:待ち時間と処理量
1件に速く答えることと、多くの依頼を扱うことを分けます。
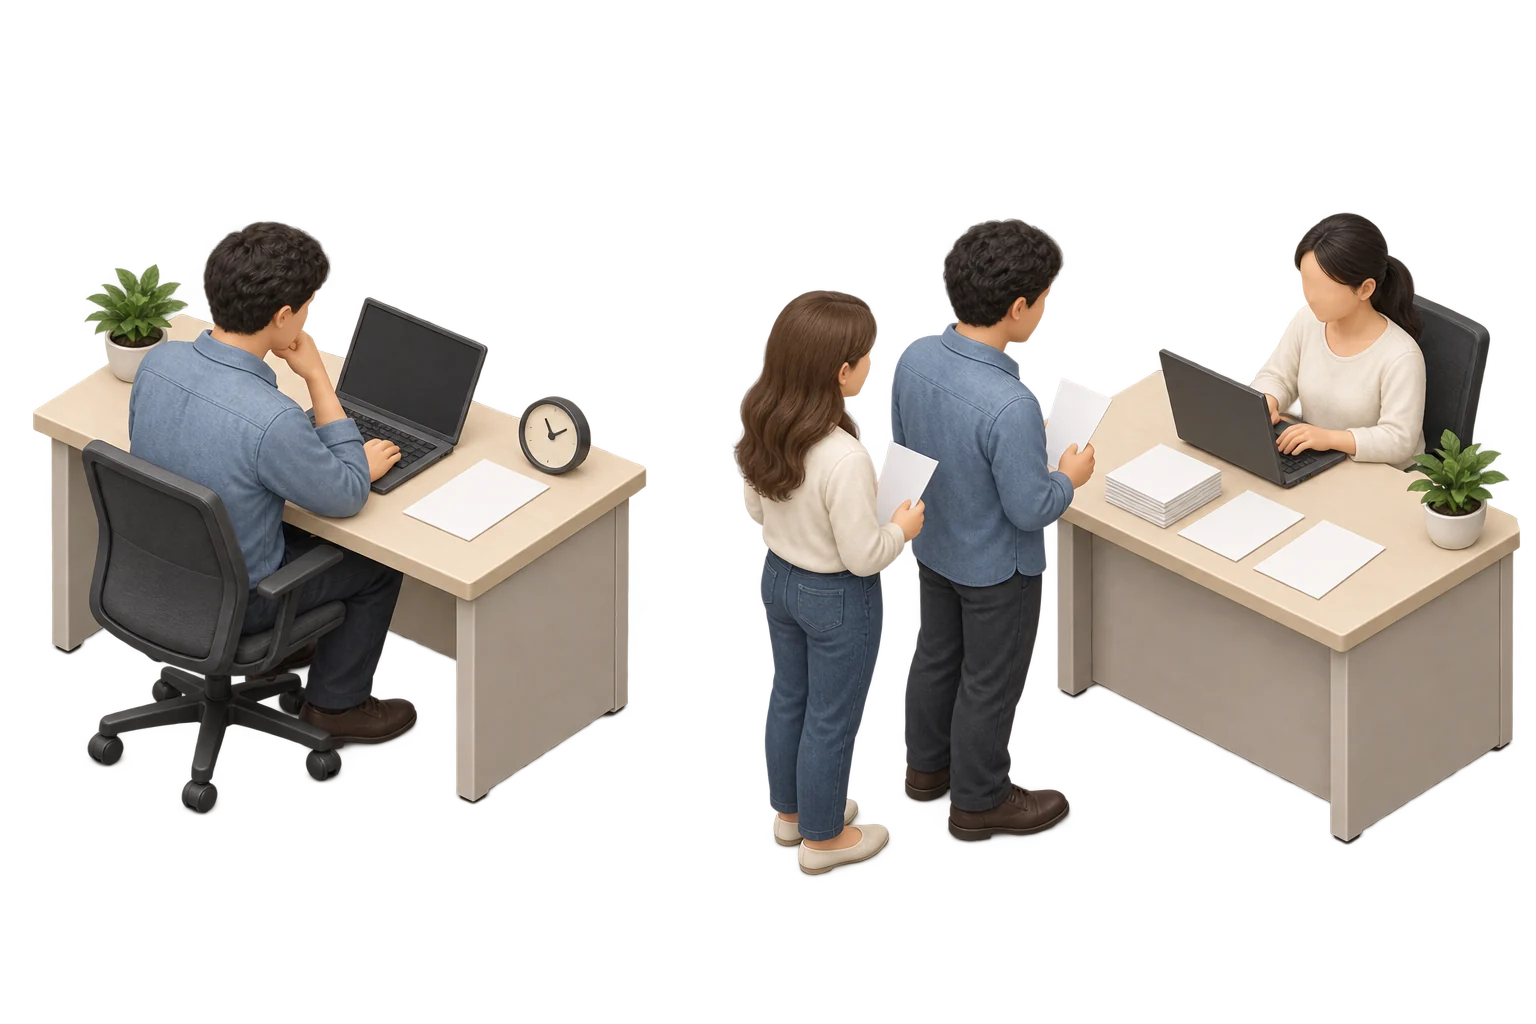
左:1件の待ち時間
レイテンシーは、依頼してから応答を受け取るまでの時間です。最初の文字までと、回答の完成までを区別して測ることもあります。
右:一定時間の処理量
スループットは、一定時間に処理できる依頼数やトークン数です。同時に使う人が増えたときの処理量と待ち時間も確かめます。
1人で使ったときに速くても、混雑時の待ち時間や処理量は別に確認します。GPUの処理能力だけでなく、メモリ、同時利用、回答の長さでも条件が変わります。
机や資料に置き換えた説明用のイラストです。
計算の速さと、置ける情報の量は別
GPUは計算を担い、メモリはモデルや処理中の情報を置く場所です。作業机に置ける広さと、作業を進める速さを分けるように考えると理解しやすくなります。このたとえは役割の説明で、机の数から実性能を計算するものではありません。
ひとつの回答の待ち時間と、全体で処理する量を見る
レイテンシーは依頼への待ち時間、スループットは一定時間に処理できる量です。最初の文字が出るまでと、長い回答が全部出るまでの時間も違います。同時利用や回答の長さを揃えて測ると、提供条件を比べやすくなります。
| 指標 | 見ること |
|---|---|
| レイテンシー | 1つの依頼で、応答を受け取るまでの待ち時間。最初の文字までと、全文の完成までを区別する。 |
| スループット | 一定時間に処理できる依頼数やトークン数。 |
| メモリ | モデルや処理中の情報を置ける容量。 |
| 費用 | 必要な設備・運用の費用。モデルや提供条件で変わる。 |
たとえば:1人には速くても、混雑すると待つ
1人で使ったときの速さだけでは、100人が同時に使う場合の提供能力はわかりません。待ち時間と、一定時間に処理できる量の両方を測ります。
AI Inc.で考えると
GPUの台数だけでなく、納品・稼働状態と、研究・学習・推論の配分を確認します。ゲームの供給指標は、現実のトークン数や待ち時間への換算値ではありません。
マルチモーダルAIとは?
文章、画像、音声など、複数の種類の情報を扱うAIです。「モダリティ」は情報の種類を指します。扱える入力と出力は、モデルによって異なります。
マルチモーダルAIとは?
文章、画像、音声など、複数の種類の情報を扱うAIです。「モダリティ」は情報の種類を指します。扱える入力と出力は、モデルによって異なります。
文章、画像、音声など、複数の種類の情報を扱うAIです。「モダリティ」は情報の種類を指します。扱える入力と出力は、モデルによって異なります。
マルチモーダル:文章・画像・音声
異なる種類の情報を組み合わせて使います。
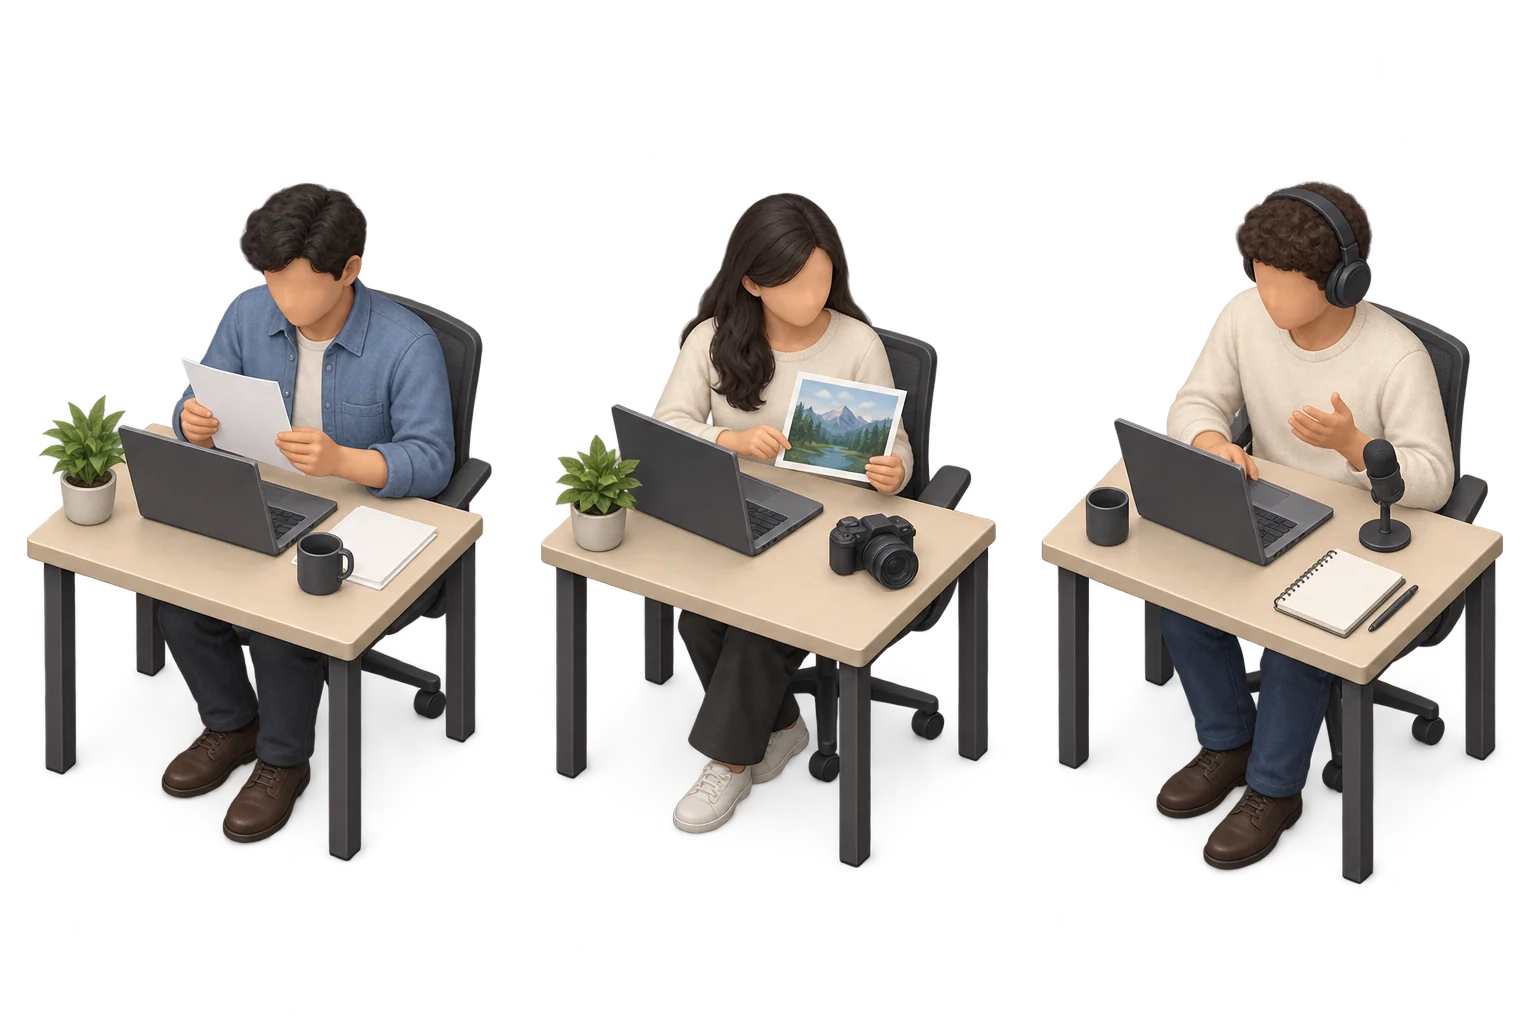
左:文章で伝える
質問や説明、資料などの文章を入力します。
中央:画像も使う
文章と画像を組み合わせ、何が写っているかを説明させる、といった使い方があります。
右:音声も使う
対応するモデルでは、音声を入力し、内容について質問できます。
扱える入力と出力はモデルによって異なります。画像を入力できても、画像を生成できるとは限りません。暗い画像や聞き取りにくい音声では、結果をよく確かめます。
机や資料に置き換えた説明用のイラストです。
異なる種類の情報を組み合わせる
画像に何が写っているかを文章で説明したり、音声を聞いて内容について答えたりします。画像を入力できるモデルが、画像も生成できるとは限りません。
入力の条件でも、結果は変わる
小さい文字、暗い画像、聞き取りにくい音声などは、誤認識の原因になります。複数の情報を扱えても、それぞれの精度を確認する必要があります。
たとえば:写真を添えて、操作を尋ねる
機械の写真と「このボタンは何?」という文章を合わせる使い方です。ボタンの表示が読めない写真なら、モデルが誤って推測する場合もあります。
AI Inc.で考えると
研究分野や市場を選ぶ際に、顧客が文章だけを扱うのか、画像や音声も必要とするのかを考える手がかりになります。対応する機能はゲーム内の説明で確認してください。
AIエージェントと、回答するAIは何が違う?
AIエージェントは、目標に向けて手順を選び、検索やツールなどを使って作業を進める仕組みです。文章を答える能力と、行動できる権限は別です。
AIエージェントと、回答するAIは何が違う?
AIエージェントは、目標に向けて手順を選び、検索やツールなどを使って作業を進める仕組みです。文章を答える能力と、行動できる権限は別です。
AIエージェントは、目標に向けて手順を選び、検索やツールなどを使って作業を進める仕組みです。文章を答える能力と、行動できる権限は別です。
回答するAIとAIエージェント
提案を読むことと、道具で作業することを分けます。
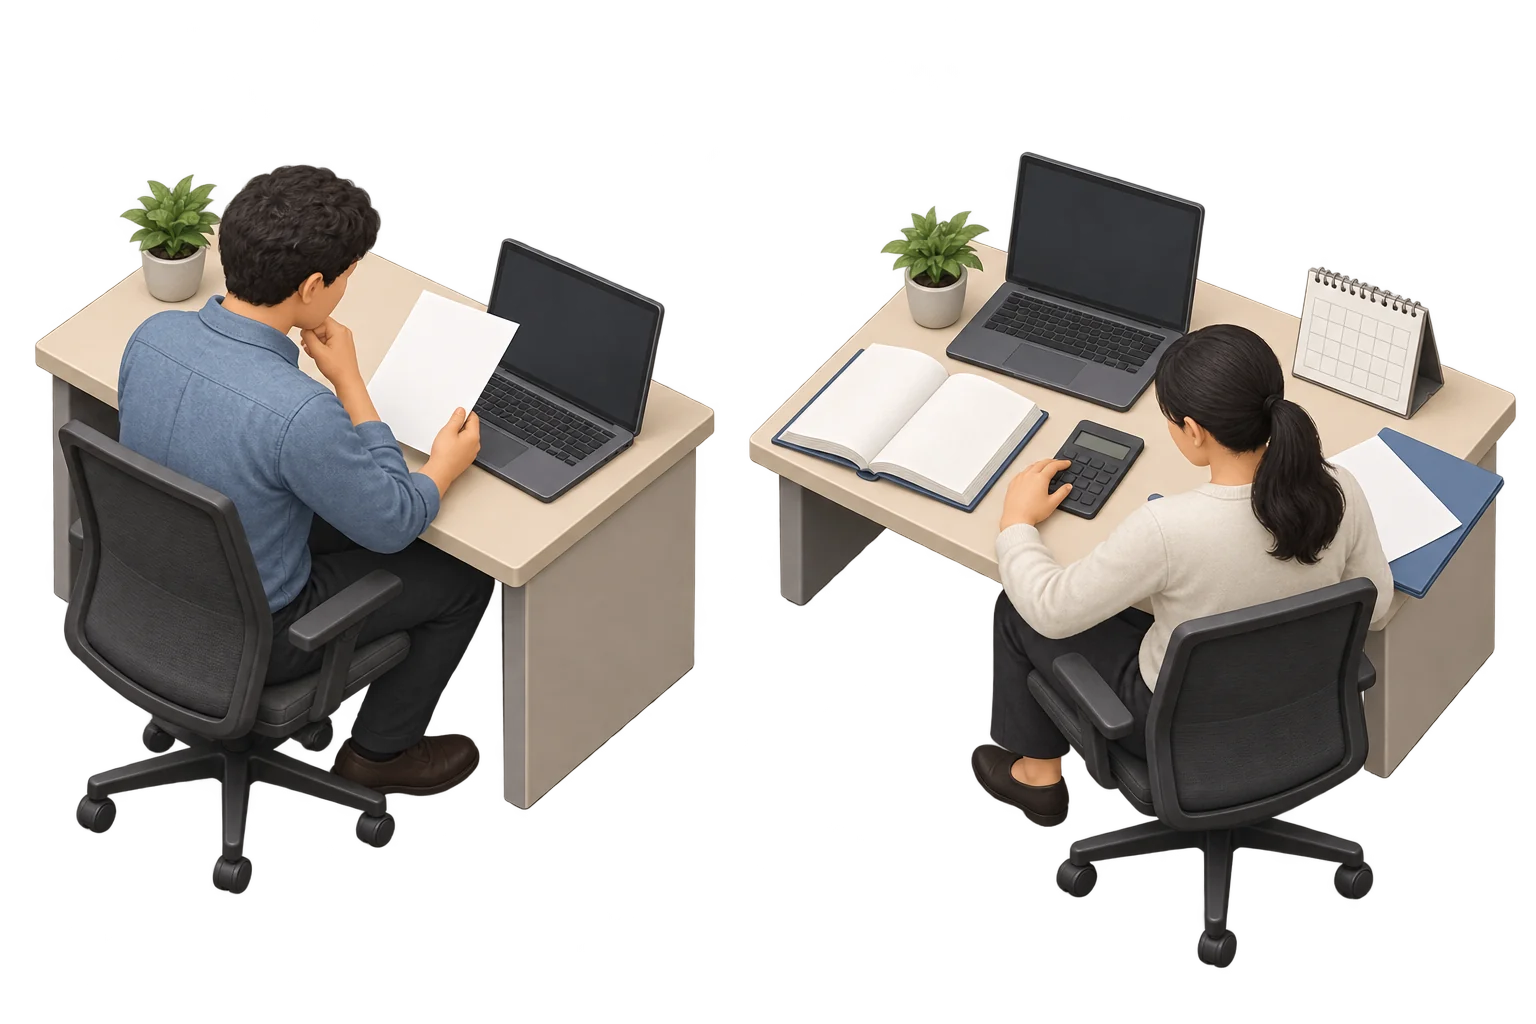
左:提案を文章で受け取る
候補の予定などを文章で提案します。提案を読んだだけでは、予約などは変更されません。
右:道具を使い、結果を確かめる
目的に合わせて手順を選び、検索や計算などの道具で作業を進め、結果を確認します。
接続された道具があることと、操作してよい権限があることは別です。送信・購入・削除などでは、許可する範囲や承認の条件を決めます。
机や資料に置き換えた説明用のイラストです。
道具を使って、結果を確認する
必要な情報を検索する、計算する、記録を更新するなどの操作を組み合わせます。LLMを使う場合も、実際の操作は接続されたツールやシステムを通じて行います。
できることの範囲を決める
読むだけの操作と、送信・購入・削除などの操作では影響が異なります。使えるツール、承認が必要な操作、途中で止める方法、実行記録などを設計します。
たとえば:予定を提案する、予約を確定する
候補の予定を文章で提案するだけなら、予約は変更されません。予約システムへ接続し、確定する権限を与えると、実際の行動ができるようになります。
気をつけること
高い文章生成の性能だけで、任せた作業が安全に完了するとは判断できません。ツールを含む流れ全体を評価します。
AI Inc.で考えると
モデルの公開と実行権限は別の判断です。ゲームでも、評価の範囲、監督、事故の条件を読んでから、認める行動の範囲を決めましょう。
ニューラルネットワークとTransformer6項目
数字の計算が、文章になるまで。6つの図解で順に理解します。
MODEL / MECHANISM
数字の計算が、
文章になるまで。
まず小さな計算を動かして、次に文章を扱う仕組みへ。6つのステップで、見えないモデルの中をたどります。
計算は説明用の小さなモデルです。このページの操作で、ゲームやセーブの内容は変わりません。
ニューラルネットワークは、何を計算している?
入力した数値を、学習で決まった重みと組み合わせ、層を通して予測へ変える仕組みです。ひとつの計算を理解すると、大きなモデルの見方もつかめます。
ニューラルネットワークは、何を計算している?
入力した数値を、学習で決まった重みと組み合わせ、層を通して予測へ変える仕組みです。ひとつの計算を理解すると、大きなモデルの見方もつかめます。
入力した数値を、学習で決まった重みと組み合わせ、層を通して予測へ変える仕組みです。ひとつの計算を理解すると、大きなモデルの見方もつかめます。
入力から、予測へ。
左の3つ、中央の4つ、右の2つ。数値を層ごとに組み合わせる立体教材です。
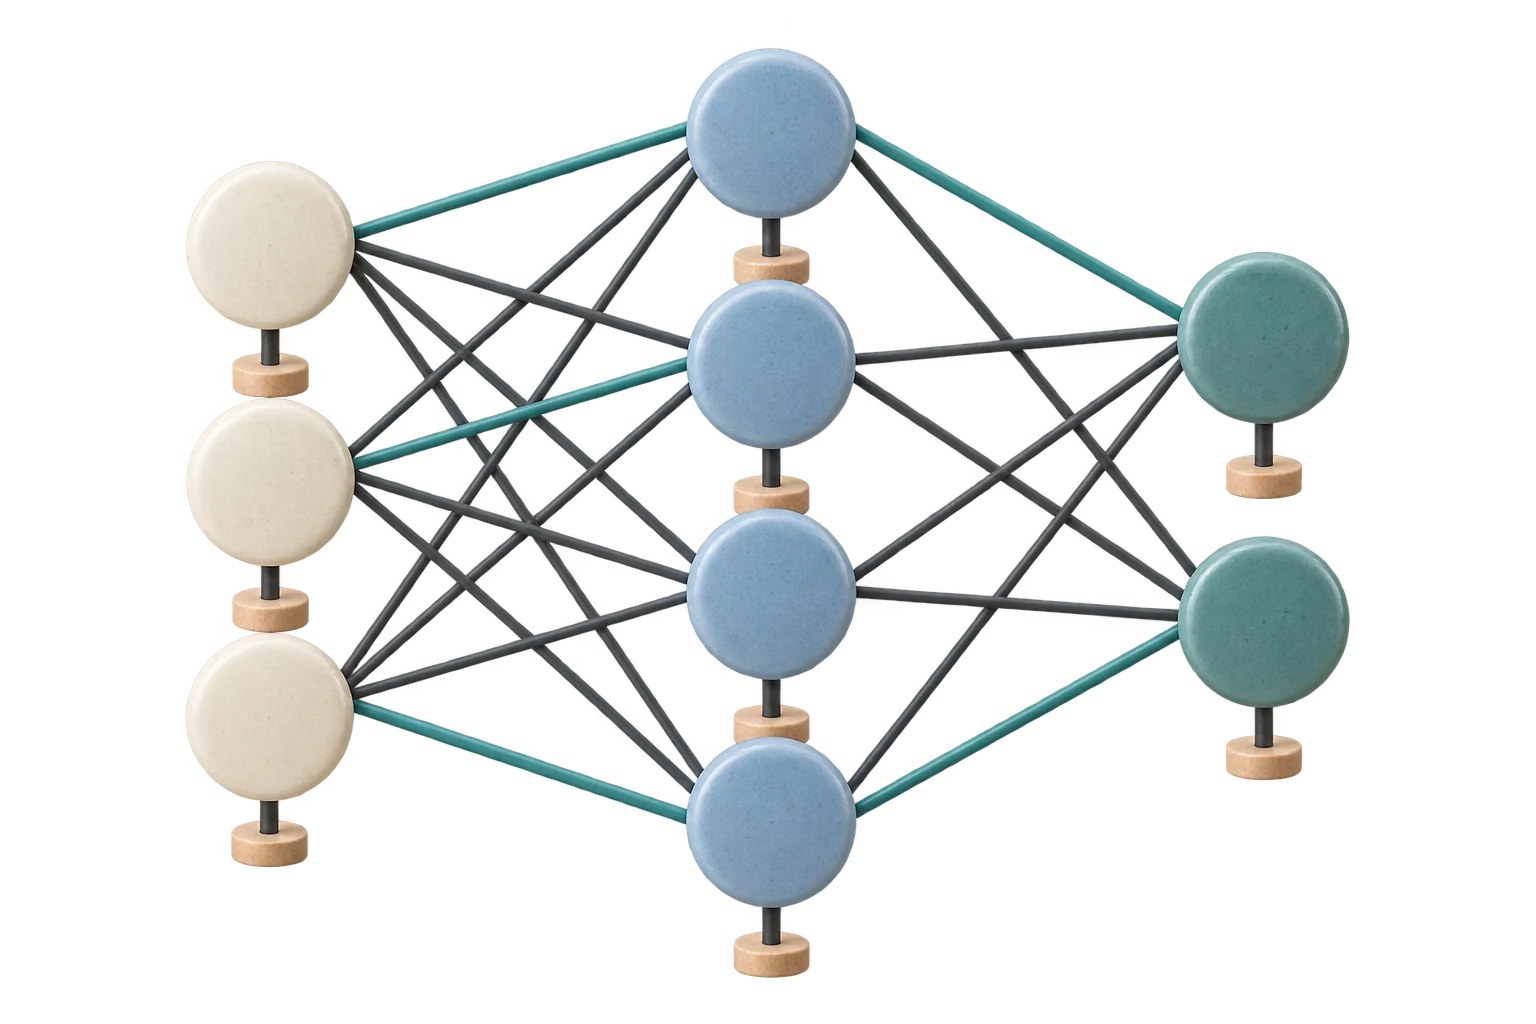
左:入力を受け取る
写真や文章などを、モデルが扱える数値にします。
中央:組み合わせて変換する
重み・バイアス・活性化関数を使い、次の表現へ変えます。
右:予測へ変える
仕事に合う出力を作ります。この段階でも、正解は保証されません。
まずは、ひとつのノードの計算を下の例で追ってみましょう。負の重みやReLUの働きも確かめられます。
層の配置を表す説明用のイラストです。線の本数・色・太さは、実在モデルの接続や重みを示しません。
入力層:扱う情報を数値にする
写真なら画素、文章ならトークンの表現など、モデルが計算できる数値を渡します。入力の作り方は、扱うデータによって変わります。
隠れ層:数値を組み合わせ直す
各ノードは、前の層の数値に重みを掛けて足し、バイアスを加えます。その結果に活性化関数を適用して、次の層へ渡します。隠れ層は、入力と出力の間にある層の呼び名です。
重みとバイアス:学習で調整する数値
重みは各入力の効き方を変え、負の値なら引く方向に働きます。バイアスは足し合わせた結果をずらします。ひとつの数値に、特定の知識や事実がひとつずつ入っているわけではありません。
活性化関数:単純な足し算から、複雑な関係へ
ReLUは負の値を0にし、0以上の値はそのまま通します。重みを掛けて足すだけの層を重ねても、全体は1回の同じ種類の計算にまとめられます。途中に非線形の変換を入れることで、複雑な関係を扱えるようになります。
出力層:仕事に合う形へ変える
最後の表現を、分類の点数や予測値などへ変換します。すべてのノードの数値が確率になるわけではありません。下の例も、計算結果を示す値です。
ひとつのノードを、動かしてみる
入力は1と2で固定します。重みやバイアスを変えると、足し合わせた値と出力がどう変わるでしょう。
- 01 / 掛けて、足す
1 × 0.6 + 2 × (−0.2) + 0.1
重みを掛けて足し、バイアスを加える。
- 02 / ReLUに通す
max(0, 0.3)
負なら0。0以上なら、そのまま通す。
合計 0.3→出力 0.3
試してみる:重み1を−0.6にすると、合計は−0.9、出力は0になります。この出力は、確率や正答率ではありません。
たとえば:ひとつのノードを計算する
入力が1と2、重みが0.6と−0.2、バイアスが0.1なら、1×0.6+2×(−0.2)+0.1=0.3です。ReLUに通すと0.3のまま。重みを動かして、合計が負になった時の出力も確かめてみましょう。
気をつけること
ニューロンという呼び名は、脳から着想を得たものです。ここで扱うのは数値の計算で、脳の働きをそのまま再現したものではありません。
図は入力・隠れ層・出力という層の考え方を学ぶための模式例です。ニューラルネットワークには、画像向けの畳み込みやTransformerなど、異なる構成もあります。
AI Inc.で考えると
データ・モデル設計・計算資源が、学習の結果と費用に関係する理由につながります。このヘルプの調整ボタンは仕組みを学ぶためのもので、ゲームのモデルやセーブを変更しません。
「学習する」は、どの数値を変えること?
予測と正解のずれを測り、ずれが減る方向へ重みなどを少しずつ調整します。答えを読むことと、モデルの数値を更新することを分けて考えましょう。
「学習する」は、どの数値を変えること?
予測と正解のずれを測り、ずれが減る方向へ重みなどを少しずつ調整します。答えを読むことと、モデルの数値を更新することを分けて考えましょう。
予測と正解のずれを測り、ずれが減る方向へ重みなどを少しずつ調整します。答えを読むことと、モデルの数値を更新することを分けて考えましょう。
① 前へ計算する:まず予測を出す
今の重みで入力から出力まで計算します。これが順伝播です。正解に近いかどうかは、まだこの段階では判断していません。
② 損失を測る:目的に合うずれの物差し
予測と学習用の正解を、損失関数で比較します。下の例は差の2乗を使います。文章の次トークン予測では、正解トークンに割り当てた確率を使う交差エントロピーなど、仕事に合う物差しを選びます。
③ 逆へたどる:変える方向を求める
逆伝播で、それぞれの重みを少し変えた時に損失がどう変わるかを計算します。この変化の傾きが勾配です。出力から入力側へ計算をたどり、複数の層の調整に使います。
④ 更新する:一歩の大きさも決める
勾配と学習率を使い、重みを更新します。学習率は一歩の大きさです。大きすぎると損失が増えることもあります。実際は多くの例で繰り返し、学習に使っていない例でも性能を確かめます。
一回ずつ、重みを更新する
入力2、正解1、学習率0.1で固定します。予測=2×重み、損失=(予測−1)²という、ひとつの重みだけのモデルです。
更新 0回·予測 0.2·損失 0.64
この例の勾配=4×(2×重み−1)
新しい重み=今の重み−学習率×勾配
0.1 − 0.1 × (−3.2) = 0.42
最初の更新では、負の勾配を引くので、重みが増えます。
| 更新回数 | 重み | 予測 | 損失 |
|---|---|---|---|
| 0回 | 0.1 | 0.2 | 0.64 |
単一の学習例に合わせる教材です。実際のニューラルネットワークでは多くの重みの勾配を逆伝播で求め、学習に使っていないデータでも評価します。
たとえば:予測0.2を、正解1へ近づける
入力2、重み0.1なら予測は0.2。損失は(0.2−1)²=0.64です。この例で学習率を0.1にすると、1回目の更新後の重みは0.42、予測は0.84、損失は0.0256になります。下の操作で、同じ例の変化を1回ずつ追えます。
気をつけること
計算例は、1つの重みだけを持つモデルと1つの学習例です。ニューラルネットワーク全体の逆伝播を再現したものではありません。
この単純な例で損失が下がることは、大きなモデルの学習成功や、未知の質問への正答を保証しません。学習に使った例だけに強くなる過学習にも注意します。
AI Inc.で考えると
研究の完了、モデルの本学習、完成後の評価を分ける理由につながります。ゲームでも、学習前の予測と完成後の結果を見比べ、次の投資を判断します。
文章は、どうやって数値になる?
文章をトークンに分け、IDを使って数値の並びに変えます。その数値表現を、周囲の情報と組み合わせていきます。
文章は、どうやって数値になる?
文章をトークンに分け、IDを使って数値の並びに変えます。その数値表現を、周囲の情報と組み合わせていきます。
文章をトークンに分け、IDを使って数値の並びに変えます。その数値表現を、周囲の情報と組み合わせていきます。
トークンとID:扱う単位を決める
トークン化で文章を小さな単位に分け、それぞれにIDを対応させます。IDは識別番号であり、その大小が言葉の意味の強さを表すわけではありません。日本語の単語や文字と、必ず1対1になるものでもありません。
埋め込み:IDから、学習された数値の並びへ
IDを手がかりに、埋め込み表からベクトルを取り出します。ベクトルは、複数の数値を並べたものです。各成分に「優しさ」「賢さ」のような、人間に読める意味が決まっているとは限りません。
位置の情報:並び方も計算へ伝える
「会社がモデルを作る」と「モデルが会社を作る」では順序が違います。Transformerは、位置や相対的な距離の情報も使います。その入れ方は設計によって変わります。
文脈の中の表現:周囲と組み合わせて変わる
最初の埋め込みを出発点に、各層で周囲の表現と組み合わせます。同じトークンでも、文脈に応じて途中の表現が変わります。IDを置き換えただけで、文章の解釈が完了するわけではありません。
言葉の番号から、数値の並びへ
架空の分割で「会社がモデルを」を見ます。IDを手がかりに、埋め込み表からベクトルを取り出します。
表は左右に動かして読めます。
| 位置 | トークン | ID | 3成分の埋め込み |
|---|---|---|---|
| 1 | 会社 | 120 | [0.2, −0.4, 0.7] |
| 2 | が | 8 | [−0.1, 0.3, 0.2] |
| 3 | モデル | 305 | [0.6, 0.1, −0.2] |
| 4 | を | 9 | [0.1, −0.2, 0.4] |
- 埋め込みを取り出す
トークンの最初の数値表現を用意する。
- 位置の情報も使う
語順や距離を、設計に合う方法で計算へ伝える。
- 周囲の情報を取り込む
各層を通ると、文脈に応じて表現が変わる。
ID305がID120より「意味が強い」わけではありません。実際の分割・次元数・数値はモデルごとに異なり、ベクトルの各成分に人間が読める意味が決まっているとも限りません。
たとえば:「モデル」という言葉を、周囲と読む
「AIのモデルを評価する」と「建築のモデルを展示する」では、周囲の言葉が違います。計算では、トークンの表現に周囲の情報を取り込み、使われている文脈を扱います。
気をつけること
図の分割・ID・3成分のベクトルは説明用の架空例です。実際の分割、次元数、数値はモデルによって変わります。
AI Inc.で考えると
文脈長やデータの用途を選ぶ時に、扱う情報の量と、その情報を使う計算の負担を考える助けになります。
Transformerは、どんな部品でできている?
Attentionで位置どうしの情報を混ぜ、Feed-Forwardで各位置の表現を変換する。このブロックを重ねるニューラルネットワークの設計です。
Transformerは、どんな部品でできている?
Attentionで位置どうしの情報を混ぜ、Feed-Forwardで各位置の表現を変換する。このブロックを重ねるニューラルネットワークの設計です。
Attentionで位置どうしの情報を混ぜ、Feed-Forwardで各位置の表現を変換する。このブロックを重ねるニューラルネットワークの設計です。
関係を混ぜる。表現を変える。
上から下へ。カードが表現、2つの枠が繰り返すブロックを表します。
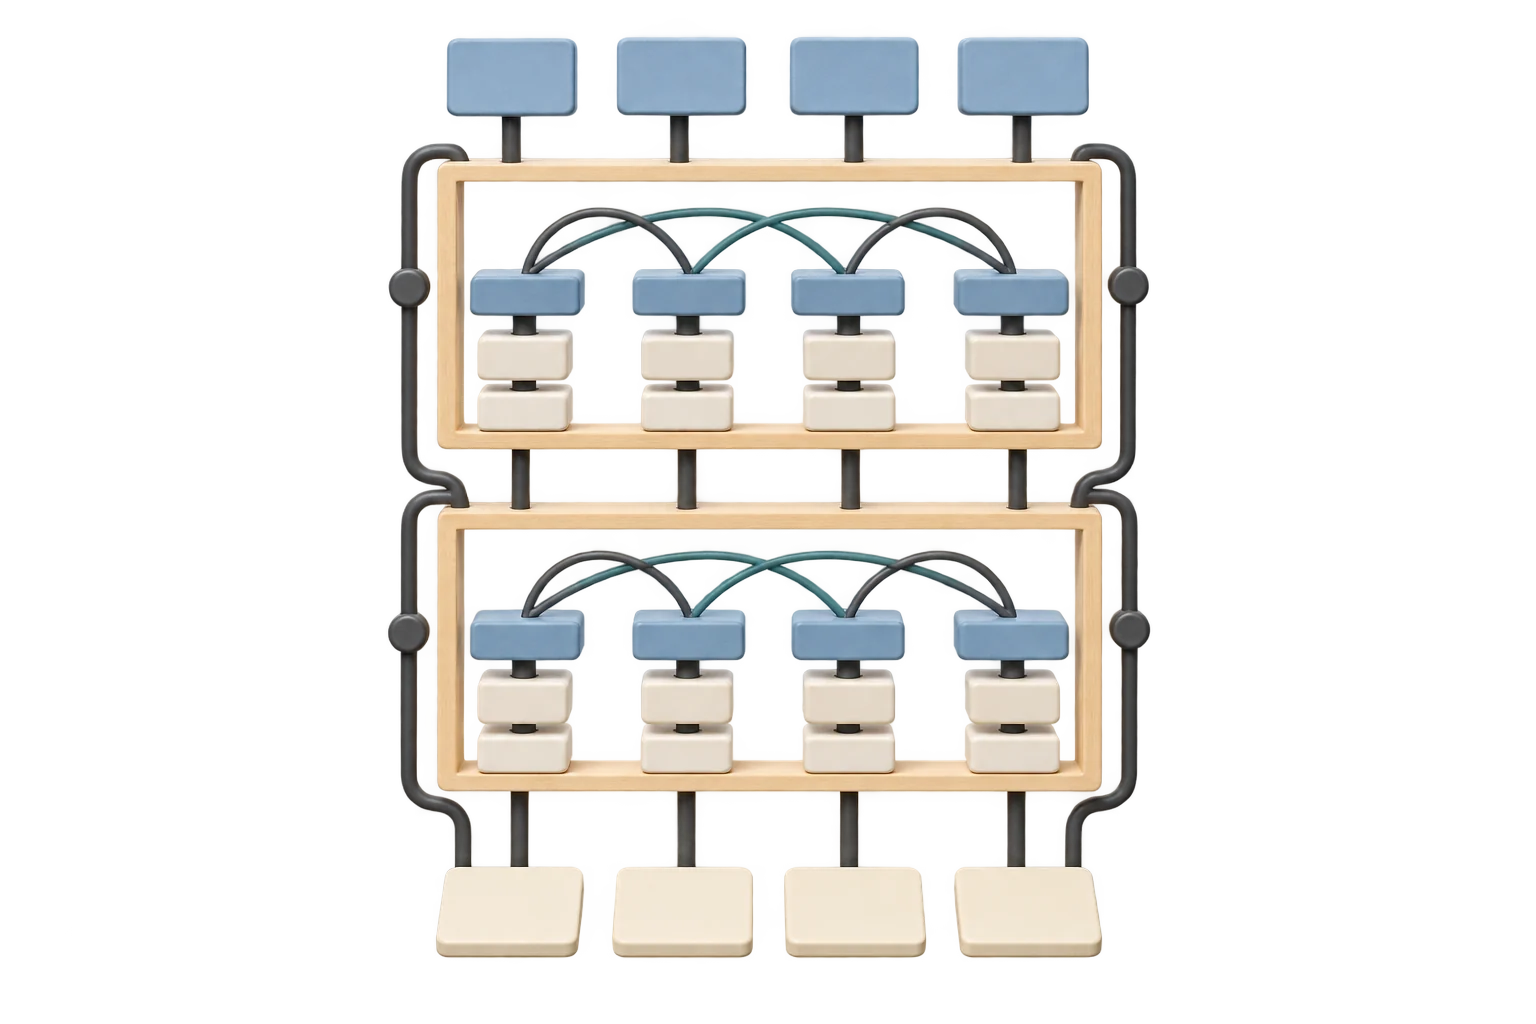
上のカード:入力の表現
トークンを数値に変え、位置の情報も使います。
2つの枠:ブロックを重ねる
位置どうしの情報を混ぜ、各位置の表現を変換します。脇の経路は元の表現を残す比喩です。
下のカード:処理後の表現
文章生成では、この先に語彙の点数と確率を計算する部分があります。
Attentionだけでできているわけではありません。正確な処理の順序と、それぞれの役割は下の日本語の図で確認できます。
Decoder型を学ぶための概念イラストです。2ブロック・4カードは説明用で、具体的なモデルや原論文全体の構成ではありません。
Attention:ほかの位置の情報を取り込む
どの位置の情報を、どれくらい取り込むかを計算します。離れた位置も候補になります。文章を生成する構成では、未来のトークンを見ないように、参照できる範囲を制限します。
Feed-Forward:各位置を、同じ計算で変換する
Attention後の各位置の表現に、学習された変換を適用します。この部分は位置ごとに処理し、同じ層では同じパラメータを使います。非線形の変換も含みます。
残差接続と正規化:重ねるための支え
残差接続は、新しく計算した結果に元の表現を足す経路です。正規化は数値の尺度を整える計算です。これらを組み合わせてブロックを重ねます。正規化の場所などは設計によって異なります。
最後の出力:次のトークン候補の点数へ
文章生成では最後の位置の表現を語彙全体の点数へ変換し、Softmaxで確率の分布にします。その候補から次のトークンを選びます。Attentionの配分と、出力候補の確率は異なる数値です。
文章生成に使うDecoder型の流れ
上から下へ読みます。イラストのカードは「数値の表現」、枠は「繰り返す処理」に対応します。
- 入力トークン → 埋め込み・位置の情報
文章を、計算で扱える表現にする。
- Transformerブロックを繰り返す01 / 位置どうしMulti-Head Self-Attention
未来の位置を隠し、参照できる位置の情報を混ぜる。
残差接続・正規化も組み合わせる02 / 位置ごとFeed-Forward(FFN)同じ層では同じ重みを使い、各位置の表現を非線形に変換する。
残差接続・正規化も組み合わせる図の2ブロックは説明用。実際の数はモデルによって異なります。
- 出力を作る部分最後の位置の表現 → 語彙の点数 → Softmax
次に続くトークン候補の確率を計算する。
- 生成次のトークンを選び、文脈へ足す
追加した文脈を使って、次の候補へ進む。
残差接続は元の表現を足す経路、正規化は数値の尺度を整える計算です。正規化を部品の前後どちらへ置くかなどは設計で異なります。この図は原論文のEncoder–Decoder全体を描いたものではありません。
| 構成 | 読む範囲と用途 |
|---|---|
| Encoder | 入力の前後を使い、文章の表現を作る。分類や検索用の表現などに利用。 |
| Decoder | 各位置までの情報を使い、続きを生成する。ここで図解する構成。 |
| Encoder–Decoder | 入力を読む側と出力を生成する側を組み合わせる。原論文は翻訳でこの構成を扱う。 |
たとえば:「それ」が指すものを、文脈と読む
「会社が新しいモデルを公開した。それは文章を要約できる。」では、「それ」を扱う時に「モデル」の情報を取り込むことが手がかりになります。その表現を各層でさらに変換し、次の出力へ使います。具体的なAttentionの計算は次の記事で見てみましょう。
気をつけること
図はDecoder型の生成モデルを理解するための簡略図です。原論文のEncoder–Decoder全体や、特定の製品の構成図ではありません。
ブロックが2つあるのは説明用です。実際の層数・幅・活性化関数・位置情報の扱いはモデルによって変わります。
AI Inc.で考えると
モデルの設計、必要な計算資源、提供時の負担を一緒に考える背景になります。ゲームの研究レベルや性能値は、現実の構成や測定値そのものではありません。
Self-AttentionのQ・K・Vは、何をしている?
取り込みたい情報を探すQ、照合するためのK、実際に取り込む情報Vを作り、関係の強さに応じてVを混ぜます。
Self-AttentionのQ・K・Vは、何をしている?
取り込みたい情報を探すQ、照合するためのK、実際に取り込む情報Vを作り、関係の強さに応じてVを混ぜます。
取り込みたい情報を探すQ、照合するためのK、実際に取り込む情報Vを作り、関係の強さに応じてVを混ぜます。
Attention:文中の要素の関係
離れた位置にある要素の関係も計算に取り入れます。
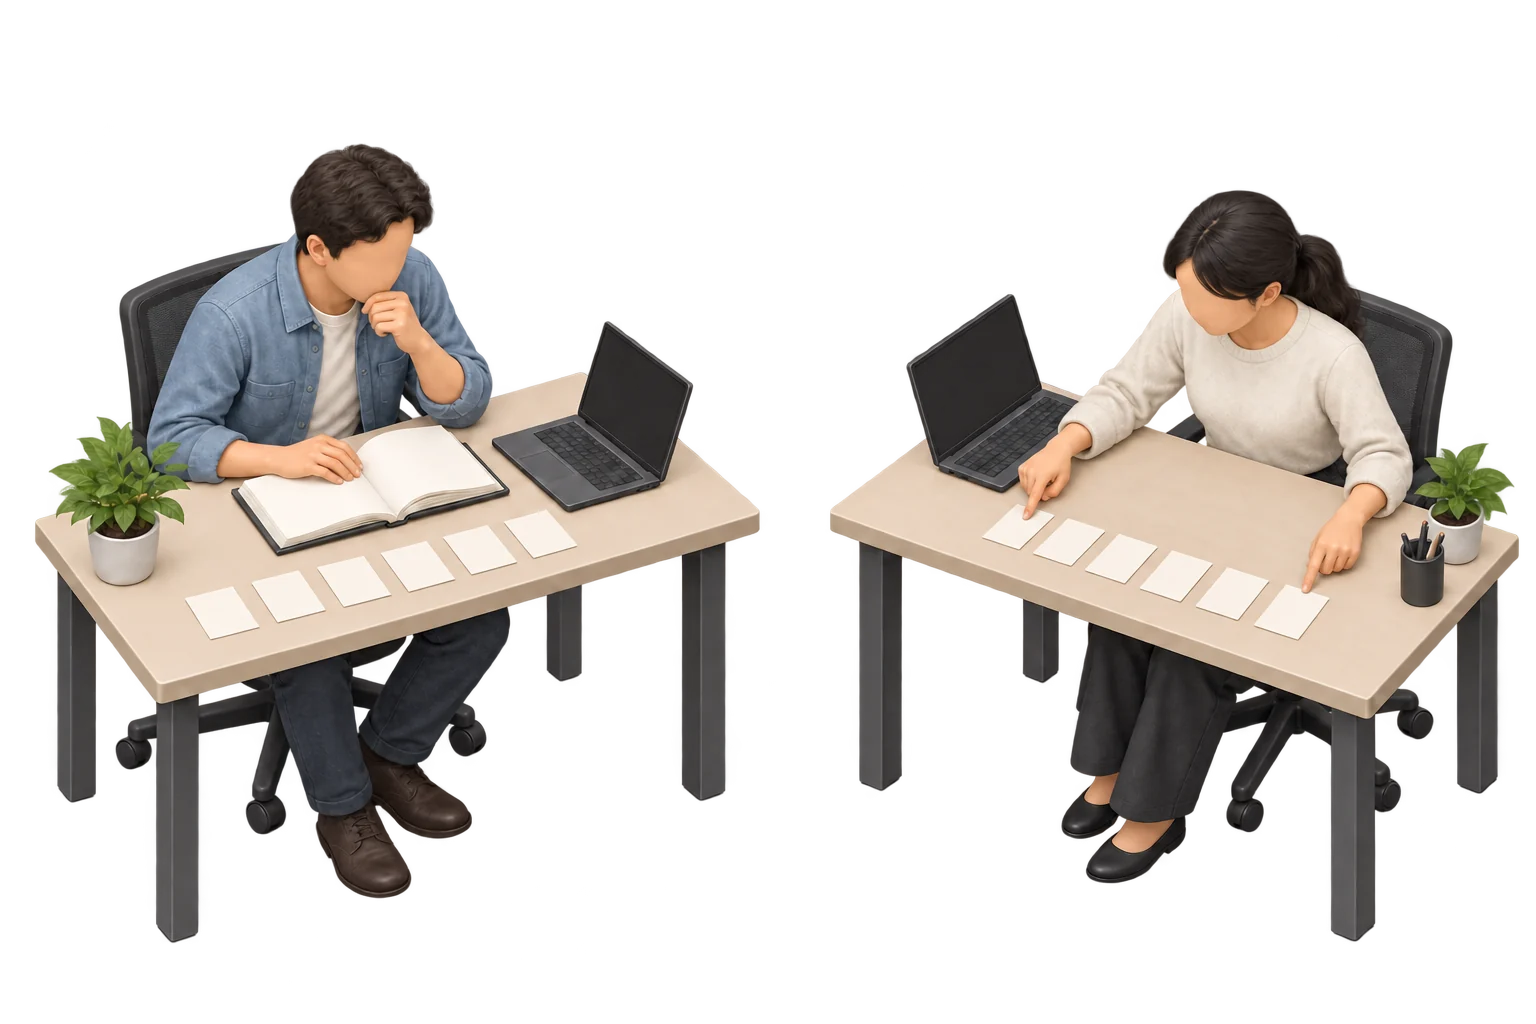
「それ」と「モデル」の関係を見る
会社が新しいモデルを公開した。それは文章を要約できる。
新しいモデルとそれ
この文章では、「それ」と「モデル」の関係が手がかりになります。離れた位置にある言葉の関係も、計算に取り入れます。
言葉の関係を説明する例です。実際のAttentionの重みを示すものではありません。
入力の中の関係を計算する
Self-Attentionは、あるトークンに対して、同じ入力のほかのトークンがどれほど関係するかを計算します。
文脈に応じた表現を作る
こうした関係を計算に取り入れ、複数の層を通して文脈に応じた表現を作ります。
紙片は文章の要素を扱う比喩です。実際のトークンが単語と一致するとは限りません。Attentionは計算方法の名前で、人間の意識を意味しません。
机や資料に置き換えた説明用のイラストです。
QとK:照合用の数値表現を作る
各位置の表現を、学習された変換でQ(Query)、K(Key)、V(Value)へ変えます。QとKの内積を計算し、次元数に応じて調整した点数を作ります。Qは検索の問い合わせに近い比喩ですが、文章の質問文そのものではありません。
Softmax:点数を、配分へ変える
参照できる位置の点数をSoftmaxへ通し、合計が1になる重みに変えます。生成モデルの例では、未来の位置を先にマスクして、その位置への重みを0にします。
V:重みを掛けて、情報を混ぜる
それぞれのVにAttentionの重みを掛け、足し合わせます。ひとつの単語を選んで終わる処理ではなく、参照できる複数の位置の情報を取り込む計算です。
Multi-Head:複数の変換を並行して使う
異なる学習済み変換を持つHeadで、それぞれ関係を計算し、結果をまとめます。Headごとに役割を人が決めているとは限らず、必ず文法や代名詞を専門にするという意味でもありません。下の例は1 Headだけです。
Q・K・Vから、配分を計算する
3位置・2成分・1 Headの架空例です。対象のQを各位置のKと照合し、その配分でVを混ぜます。語彙から次の単語を選ぶ計算とは別です。
対象のQ = [1, 1]
点数 = QとKの内積 ÷ √2
表は左右に動かして読めます。
| 位置 | K:照合用 | V:混ぜる情報 | 点数 |
|---|---|---|---|
| 1「会社」 | [1, 0] | [0.4, 0.1] | 0.707 |
| 2「モデル」 | [1, 1] | [0.8, 0.6] | 1.414 |
| 3「それ」 | [0, 1] | [0.1, 0.2] | 0.707 |
Softmax後の配分:合計100%
- 1「会社」24.8%
- 2「モデル」50.3%
- 3「それ」24.8%
位置3「それ」の混合結果 [0.527, 0.377]。未来の位置を隠しています。
結果 = 0.248 × [0.4, 0.1] + 0.503 × [0.8, 0.6] + 0.248 × [0.1, 0.2]
各Vに配分を掛け、成分ごとに足しています。表示値は丸めているため、表示上の合計は100%からずれることがあります。
試してみる:位置1を選ぶと、因果マスクがある場合は位置1だけを100%使います。マスクを外すと後の位置も候補になります。数値は実在モデルの測定値ではありません。
たとえば:「それ」を対象に、架空の値で計算する
下の例は3位置のQ・K・Vを用意し、対象のQと各Kの内積を√2で割ってからSoftmaxを計算します。対象を前の位置へ変えると、生成するモデルの例では未来の位置がマスクされます。表示された配分と混合結果を見比べましょう。
気をつけること
分割、Q・K・V、点数は説明用の架空例です。実在モデルのAttentionを測定したものではなく、意味の関係が正しく学習された証拠でもありません。
入力に応じてAttentionの配分は変わりますが、そのこと自体は、学習済みパラメータの更新を意味しません。
Attentionは計算方法の名前です。人間の意識や、出力の正しさを保証する仕組みではありません。
AI Inc.で考えると
長い文脈を扱う計算や、推論でメモリを使う理由につながります。顧客への供給を考える時は、モデルの品質と資源の負担を合わせて見ます。
LLMは、どうやって文章の続きを作る?
ここでは自己回帰型の文章生成を見ます。渡された文脈から次のトークンの確率を計算し、選んだトークンを文脈へ足して、次を計算します。
LLMは、どうやって文章の続きを作る?
ここでは自己回帰型の文章生成を見ます。渡された文脈から次のトークンの確率を計算し、選んだトークンを文脈へ足して、次を計算します。
ここでは自己回帰型の文章生成を見ます。渡された文脈から次のトークンの確率を計算し、選んだトークンを文脈へ足して、次を計算します。
まだない続きを、入力に混ぜない
生成時は、指示とこれまでの出力を使います。学習時に正解の文章を並べて処理する場合も、各位置が未来の正解を見ないように因果マスクを使います。複数の学習位置を並行して計算できることと、未来の答えを見てよいことは別です。
確率から選ぶ:毎回最大の候補とは限らない
確率の高い候補を選ぶ方法や、確率に沿って候補を抽選する方法などがあります。選び方や温度などの設定で出力は変わります。1回で答え全体を完成させる、という説明だけではこの繰り返しが見えません。
選んだトークンも、次の文脈になる
生成したトークンを文脈に加え、次の候補を計算します。終了を表すトークンや出力上限などに達するまで続けます。選択を繰り返すので、初めの出力の違いが、その後の文章にも影響します。
選んだ続きを、次の入力へ
分割も確率も架空です。ここでは見やすくするため、高い確率の候補を選んだ例を示します。
- 01
- いまの文脈
- AIの
- 次の候補
- 研究 60% · 活用 25% · その他 15%
- 選ぶ
- 研究
- 次の文脈へ
- AIの研究
- 02
- いまの文脈
- AIの研究
- 次の候補
- を 70% · が 20% · その他 10%
- 選ぶ
- を
- 次の文脈へ
- AIの研究を
- 03
- いまの文脈
- AIの研究を
- 次の候補
- 進める 55% · 支える 30% · その他 15%
- 選ぶ
- 進める
- 次の文脈へ
- AIの研究を進める
実際には確率に沿って抽選するなど、選び方は設定によって異なります。次トークンの確率は、内容が事実である確率ではありません。通常の生成では、回答ごとに学習済みの重みを更新しません。
たとえば:「AIの」を、1つずつ続ける
説明用の分割なら、「AIの」に「研究」を足し、その「AIの研究」に「を」を足し、さらに次の候補を計算する流れです。図の候補と確率は架空です。実際のトークン化や候補は、モデルと文脈によって変わります。
気をつけること
次トークンの確率は、内容が事実である確率ではありません。自然な文章でも誤りは起こるので、資料や計算結果と照合します。
通常の文章生成では、その回答のたびに学習済みの重みを更新しません。追加学習は別の工程です。
推論の実装ではKVキャッシュなどで既存の計算を再利用できます。図は情報の流れを示し、毎回すべてを最初から再計算するという意味ではありません。
AI Inc.で考えると
顧客への提供では、文章を出すための推論に計算資源が必要です。モデルを完成させる学習費用と、使い続けるための供給・費用を分けて考えます。
AI研究のいま10項目
2026年10月5日確認。最近の学術論文から、9つの研究動向と、その成果・限界を読む。
確認日 · 対象:2026年5〜9月の10論文
回答を作る能力から、長い仕事を仕上げる能力へ。計算の使い方、根拠の確かさ、評価と権限の設計まで、最近の論文から研究の方向を読みます。
最新の研究動向を、どう読めばいい?
ここでは、2026年5〜9月に公開された10論文から9つの方向を紹介します。推論・エージェント・記憶・効率化・音声・世界モデル・信頼性・評価・権限設計が対象です。
最新の研究動向を、どう読めばいい?
ここでは、2026年5〜9月に公開された10論文から9つの方向を紹介します。推論・エージェント・記憶・効率化・音声・世界モデル・信頼性・評価・権限設計が対象です。
ここでは、2026年5〜9月に公開された10論文から9つの方向を紹介します。推論・エージェント・記憶・効率化・音声・世界モデル・信頼性・評価・権限設計が対象です。
何を変え、何と比べたかを読む
モデル、データ、計算予算、評価の条件を確認します。別の論文で得られた数値は、条件が違えばそのまま順位にできません。各項目では、方法と観測された結果を分けて説明します。
公開日と、採択・検証は別
プレプリントは学術誌や会議の査読を経る前にも公開できる原稿です。会議採択が原本に記載された論文は、その記載を示します。採択や高いスコアだけで、すべての用途での有効性が確定するわけではありません。
| 見るところ | 確かめること |
|---|---|
| 対象 | どのモデル、言語、データ、課題で試したか |
| 比較条件 | 計算量、試行回数、設備を揃えて比較したか |
| 指標 | 1回での正答か、複数候補のうち1つが正答する割合か |
| 再現性 | 方法、コード、データ、論文の版が確認できるか |
| 限界 | 未検証の条件や、追加で必要な検証は何か |
たとえば:高い正答率でも、試した回数が違う場合
1回で答えた正答率と、複数の候補を作って少なくとも1つが正しかった割合は、同じ指標ではありません。課題・モデル・候補数・計算予算を確認してから結果を読みます。高い数値だけで、1回の回答がより確かになったとは判断しません。
気をつけること
このページは選んだ論文をもとにした解説です。分野全体の合意や、現実の製品の最新ランキングを示すものではありません。研究の成果と、ゲームの実装も区別して読みます。
推論:計算を増やすだけでなく、考え方を分ける
回答時に多くの候補を作る研究では、同じ失敗を繰り返すことが課題です。PTTSは、先に異なる解法の方針を立て、各候補をその方針に沿って作ります。
推論:計算を増やすだけでなく、考え方を分ける
回答時に多くの候補を作る研究では、同じ失敗を繰り返すことが課題です。PTTSは、先に異なる解法の方針を立て、各候補をその方針に沿って作ります。
回答時に多くの候補を作る研究では、同じ失敗を繰り返すことが課題です。PTTSは、先に異なる解法の方針を立て、各候補をその方針に沿って作ります。
候補を増やす前に、解き方の方針を分ける
複数の方針を先に用意し、それぞれに沿って回答候補を作ります。
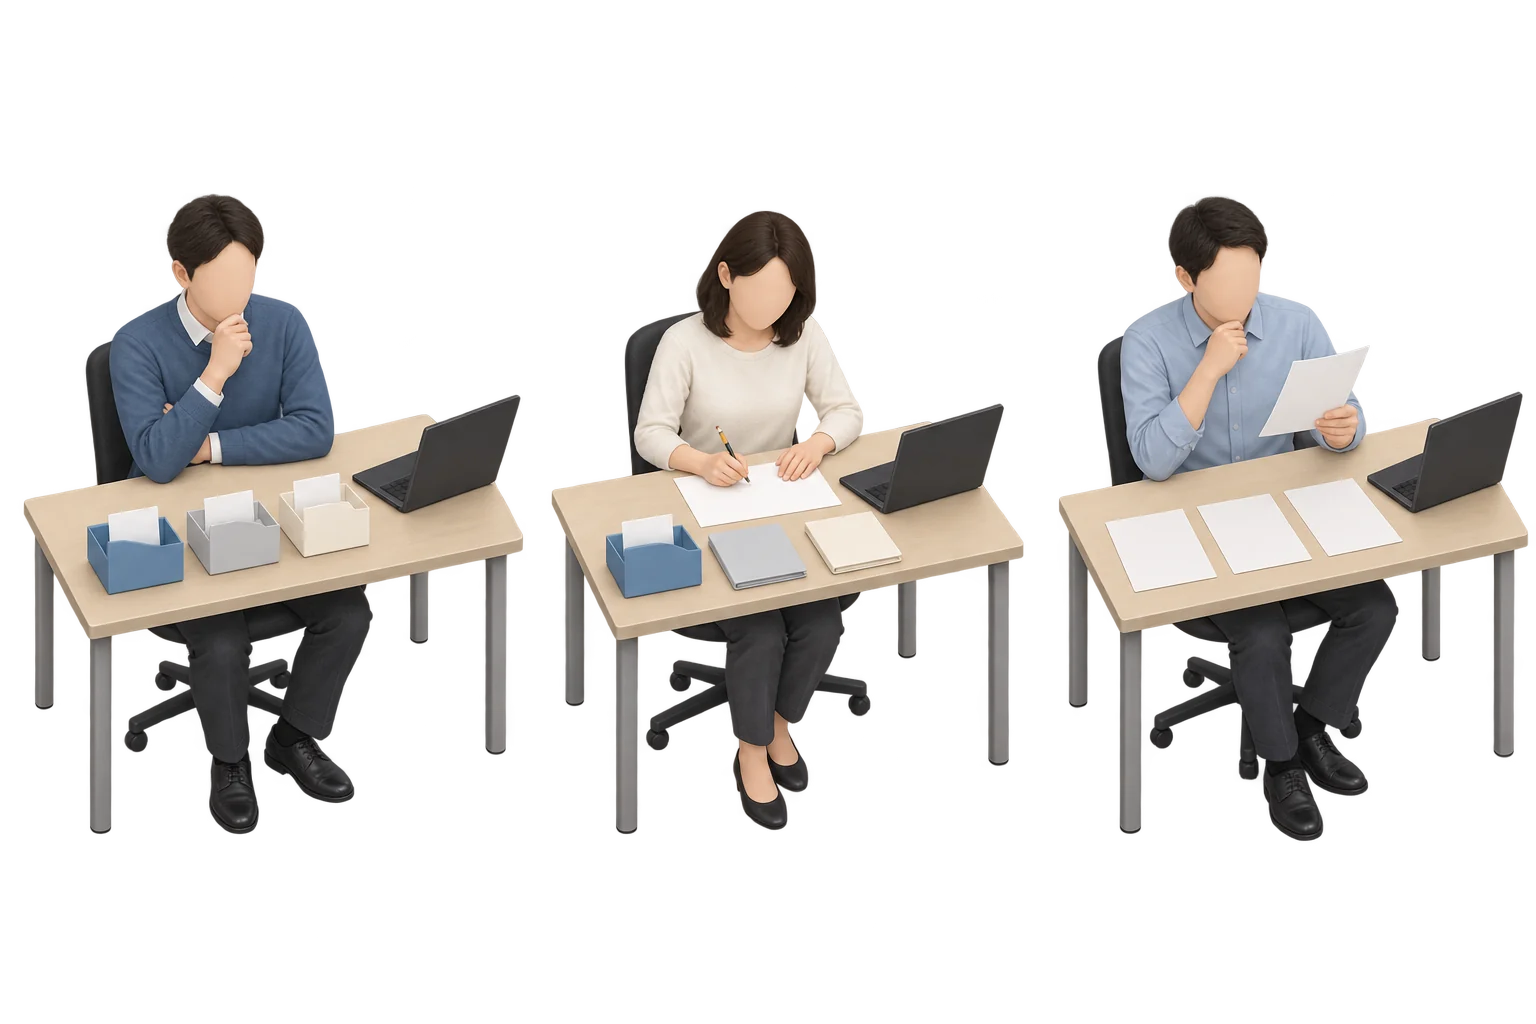
左:異なる方針を先に作る
同じ問題を、どんな解き方で試すかを計画します。PTTSでは、方針を作る側が複数の候補をまとめて考え、似た試行への集中を減らすことを狙います。
中央:方針に沿って候補を作る
実行する側は、問題とそれぞれの方針を使って回答候補を作ります。方針を用意することと、具体的な解答を完成させることは別の役割です。
右:候補に正解があるかを測る
回答候補を評価し、少なくとも1つが正解したかを測ります。正解が含まれることと、それを選んで利用者へ返せることは分けて考えます。
pass@kは、k個の候補に少なくとも1つ正解が含まれるかを見る指標です。1回の回答の正答率や、正解を選び出す能力とは異なります。
カード入れ・ファイル・紙は説明用の比喩です。入れ物の色は方針の違いを表し、性能の順位ではありません。紙の枚数や人物の数は、論文の試行回数やモデルの数を示しません。右の場面も、正解を自動で選べることを保証しません。
学習後のモデルに、計算をどう使うか
推論時の追加計算を使う方法をテスト時スケーリングと呼びます。PTTSでは、方針を作る側と実行する側を分け、方針を作る側を強化学習で調整する方法も検討しています。
論文が報告したこと
Qwen3の1.7B・4Bモデルを用いた5つの数学評価で、独立した繰り返し生成よりpass@64が改善したと報告しています。これは、64候補のうち少なくとも1つが正解するかを見る指標です。[R01]
結果の範囲と、残る課題
複数の候補から正解を確実に選べることや、1回の回答で同じ改善が得られることは別の課題です。数学以外の仕事や待ち時間・費用も、用途に合わせて確認する必要があります。
たとえば:4つの候補のうち、1つだけが正解だったら
ある問題で4つの回答候補を作り、1つだけが正解したとします。この問題はpass@4では成功として数えます。複数の問題について、この成功の割合を見ます。「4回に1回正解する」という指標でも、正解の候補を確実に選べるという意味でもありません。4候補の例は説明用で、論文の成績を再現したものではありません。
AI Inc.で考えると
研究の性能だけでなく、顧客への提供に必要な推論資源も見る、という判断につながります。PTTSをゲームで個別設定できるという意味ではありません。
エージェント:途中の操作から、完成した成果物の評価へ
検索やツール操作ができても、長い作業を最後まで仕上げられるとは限りません。KNOWSは、情報を集め、整理し、文書などの成果物を作るWeb作業を評価します。
エージェント:途中の操作から、完成した成果物の評価へ
検索やツール操作ができても、長い作業を最後まで仕上げられるとは限りません。KNOWSは、情報を集め、整理し、文書などの成果物を作るWeb作業を評価します。
検索やツール操作ができても、長い作業を最後まで仕上げられるとは限りません。KNOWSは、情報を集め、整理し、文書などの成果物を作るWeb作業を評価します。
途中の操作から、使える成果物へ
情報を集めた後に、整理と完成品の確認が続きます。
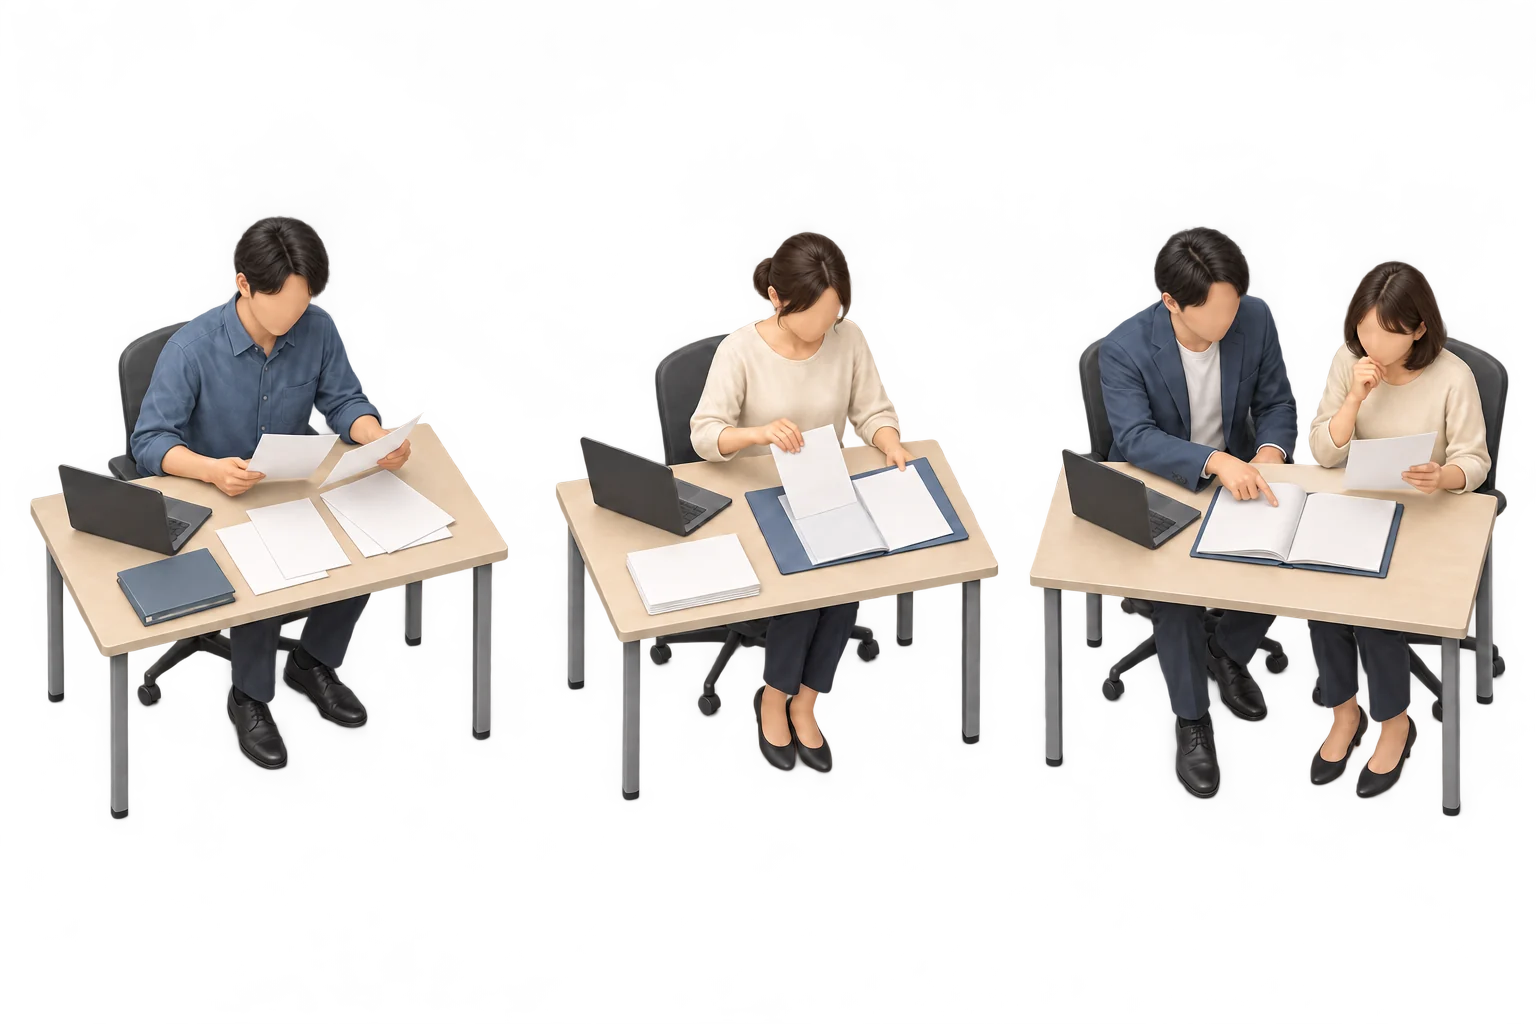
左:必要な情報を集める
検索や資料の取得は、作業の一部です。情報が見つかっても、依頼された成果物が完成したとは限りません。
中央:整理して形にする
集めた情報を比較し、文書・表・スライドなど、依頼された形式へまとめます。内容だけでなく、配置や構成も関わります。
右:完成品を依頼と比べる
必要な情報が揃い、指定された構成や表示になっているかを確かめます。途中の操作と、最後に使える成果物を分けて評価します。
「資料を取得できた」と「依頼を完了できた」は別の結果です。完成した成果物まで確認すると、どの工程で止まったかも見つけやすくなります。
机仕事へ置き換えた説明用のイラストです。KNOWSの実際の画面や評価課題を再現したものではなく、右の場面も成功を保証する描写ではありません。ゲームの提供手順とは区別します。
モデルだけでなく、道具の渡し方も重要
同じモデルでも、操作できる範囲やツールの仕組みで結果は変わります。途中の操作が成功したかと、完成品が利用できるかを分けて測る方向です。
論文が報告したこと
110の複雑な課題を用意し、試したエージェントの最良の完全成功率も3%未満だったと報告しています。部分的には進めても、視覚的な操作の失敗で成果物が使えなくなる例があります。[R02]
結果の範囲と、残る課題
特定の課題と実験時のシステムの結果であり、すべてのエージェントの成功率ではありません。実際のWebサイトを使うため、画面や情報の変化にも評価が影響されます。
たとえば:検索できても、比較資料が未完成の場合
「3つの候補を調べ、出典付きの比較資料を作る」という依頼を考えます。3つの情報を取得できても、比較する条件が欠けていたり、文字が重なって読めなかったりすれば、依頼を完了したとは言えません。情報の取得と、使える完成品の両方を確かめます。これは説明用の例で、論文の個別課題を再現したものではありません。
AI Inc.で考えると
モデルの性能と、顧客が実際に受け取る提供結果を合わせて確認する理由につながります。公開後の供給や先行提供の結果も見ましょう。
長い文脈:全文を保持する方法から、記憶を使う設計へ
長い文章を扱うには、情報を参照する能力と計算・メモリの負担を両立する必要があります。ARMTの研究は、繰り返し更新する連想記憶をモデルへ組み込みます。
長い文脈:全文を保持する方法から、記憶を使う設計へ
長い文章を扱うには、情報を参照する能力と計算・メモリの負担を両立する必要があります。ARMTの研究は、繰り返し更新する連想記憶をモデルへ組み込みます。
長い文章を扱うには、情報を参照する能力と計算・メモリの負担を両立する必要があります。ARMTの研究は、繰り返し更新する連想記憶をモデルへ組み込みます。
長文を、区切りと記憶で読む
前の区切りで得た情報を、次の区切りの処理へ引き継ぎます。
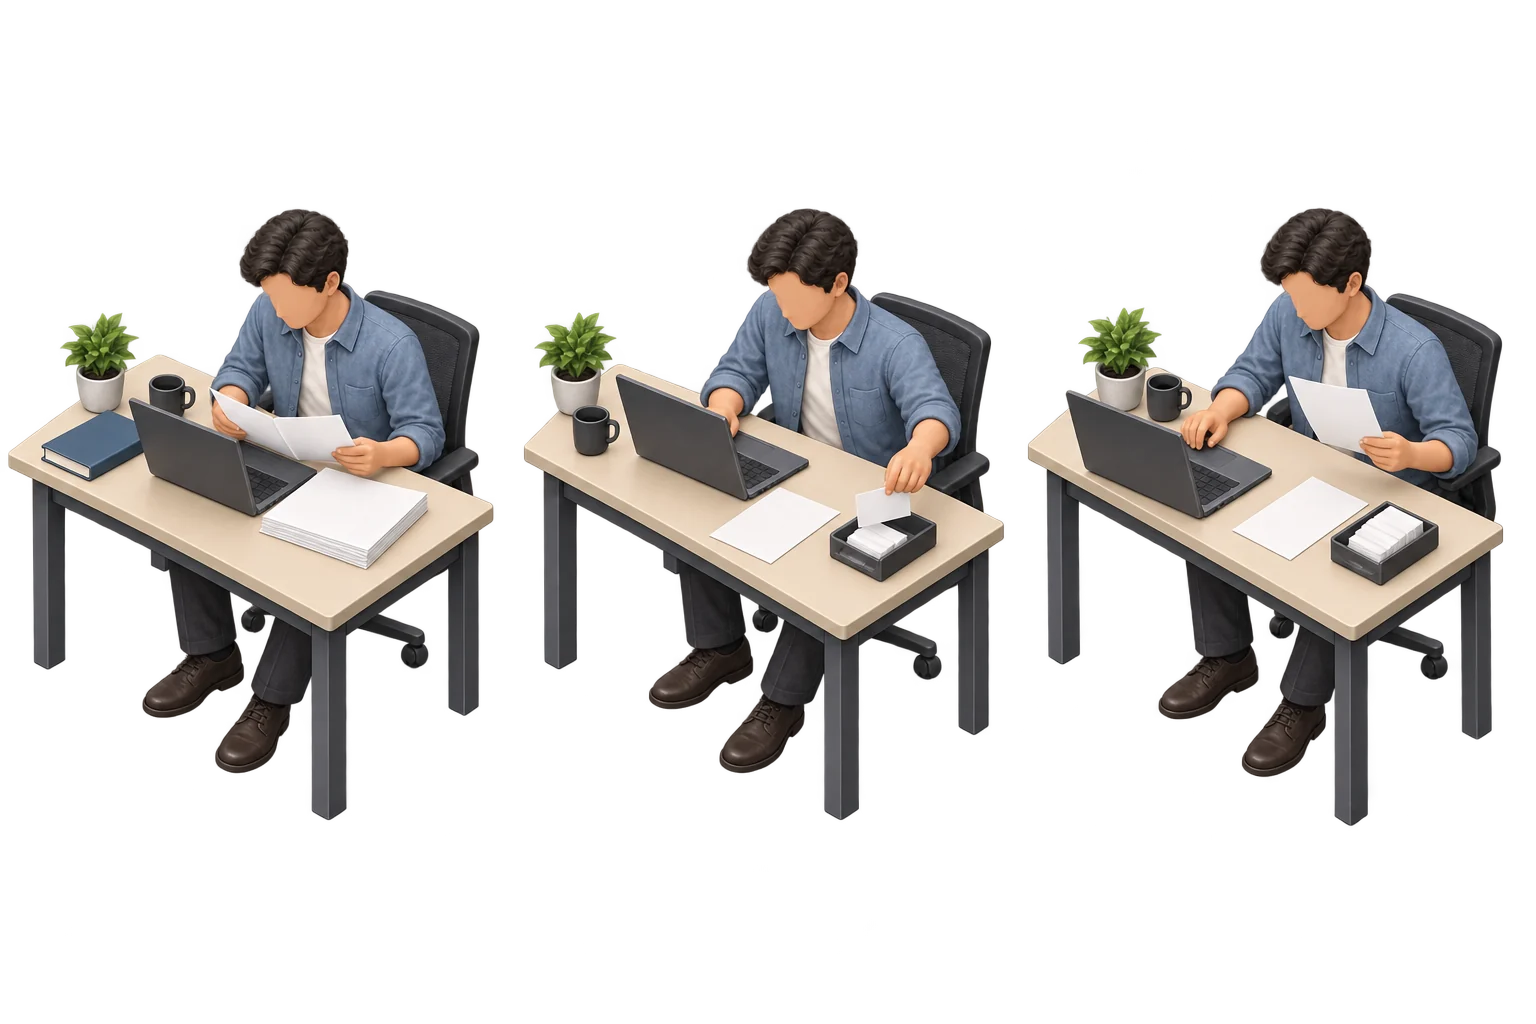
左:入力の一部を読む
ARMTは長い入力を区切り、順番に処理します。区切りの中では、その範囲の情報を使います。
中央:内部の記憶を更新する
読んだ内容の表現を使い、モデル内部の連想記憶を更新します。カード入れは、その仕組みを表す比喩です。
右:次の区切りで使う
次の入力を処理するとき、前の区切りから引き継いだ記憶も参照します。この処理を繰り返して長文を扱います。
全文をそのまま保持することと、内部の記憶へ情報を引き継ぐことは異なります。長さの上限と、必要な情報を正しく使える能力も別に確かめます。
資料とカード入れは説明用の比喩で、論文の内部構造図ではありません。実際の記憶は数値で表され、文章の要約や原文の完全な保存とは異なります。アプリが会話を恒久保存する機能や、ゲームの実装を示すものでもありません。
区切って読み、内部の記憶を引き継ぐ
ARMTは入力を区切って順に処理し、各区切りで連想記憶を更新します。次の区切りでは、その記憶も参照します。記憶はモデル内部の数値で表され、原文を丸ごと保存することや、文章で要約を残すこととは異なります。
長さの上限だけでなく、実際に使えるか
この研究では、長い入力に対応するための追加学習と、記憶を組み込む層の選択を検討しています。情報を入れられる長さと、遠くの情報を使って正しく答える能力は区別します。
論文が報告したこと
分野別の長文データを作り、元のモデルの文脈上限を超えた入力や、学習時より長い入力で評価しています。元の長さの範囲でも、性能を維持しつつ計算量を減らす結果を報告しています。[R03]
結果の範囲と、残る課題
実験対象は最大1Bパラメータの比較的小さいモデルです。より大きなモデルや別の分野で同じ効果が得られるかは、この結果だけでは判断できません。
たとえば:長い報告書の、前半と後半をつなげる
前半に計画の条件、後半に実績が書かれた報告書を考えます。後半を読むとき、前の区切りから引き継いだ情報が使えれば、両方を踏まえて処理できます。ただし、条件をすべて正確に引き継げるかは評価が必要です。これは使い方を考える例で、この報告書での成功を論文が保証するものではありません。
AI Inc.で考えると
性能だけを上げる研究と、同じ仕事を少ない資源で行う研究の違いを考える手がかりになります。ゲームのモデル規模や資源の数値を、論文の値に換算するものではありません。
効率化:候補を先に作り、まとめて検証する
投機的デコーディングは、軽い計算で先のトークン候補を作り、対象モデルで検証する方法です。最近の研究では、依頼ごとの処理予定と、候補を作るモデルの学習を改良しています。
効率化:候補を先に作り、まとめて検証する
投機的デコーディングは、軽い計算で先のトークン候補を作り、対象モデルで検証する方法です。最近の研究では、依頼ごとの処理予定と、候補を作るモデルの学習を改良しています。
投機的デコーディングは、軽い計算で先のトークン候補を作り、対象モデルで検証する方法です。最近の研究では、依頼ごとの処理予定と、候補を作るモデルの学習を改良しています。
候補を先に作り、採用する範囲を確かめる
候補の作成と検証を組み合わせ、回答の続きを生成します。
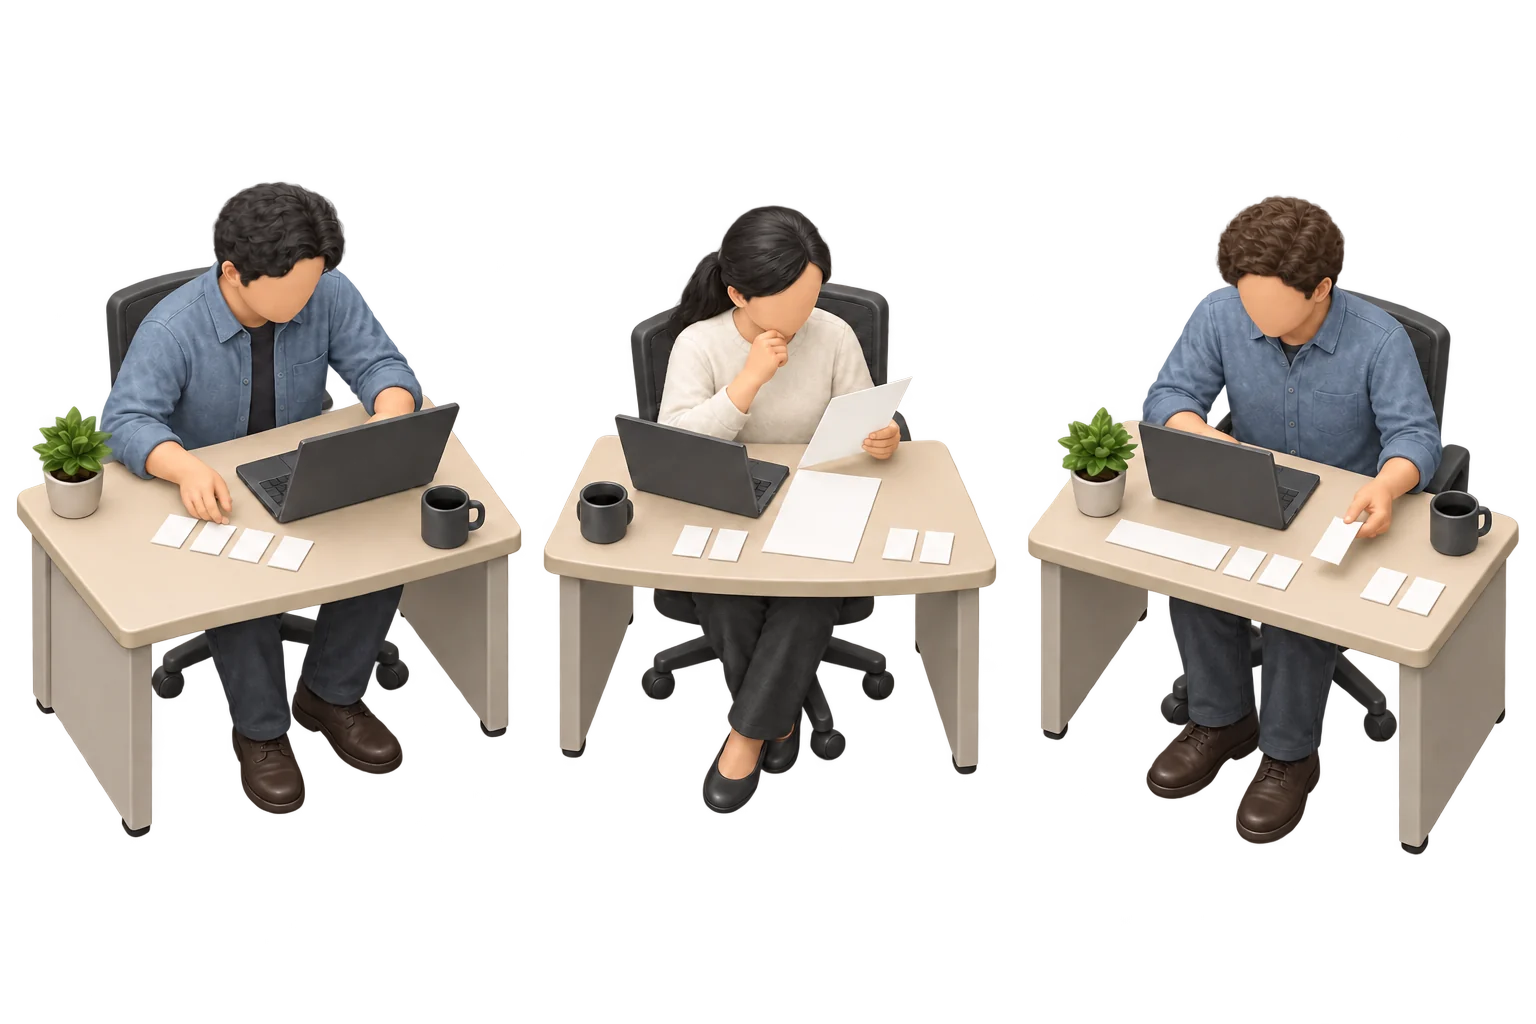
左:先の候補を作る
軽い計算で、複数のトークン候補を先に作ります。ASPIREでは、同じモデルが参照する文脈を一部に絞って候補を作ります。
中央:対象モデルで検証する
ASPIREでは、全文脈を参照する計算で候補をまとめて検証します。先頭からどこまで受け入れられるかを確かめます。
右:採用した続きを加える
受け入れた先頭部分と、検証側で決まった次のトークンを加えます。採用されなかった残りを取り下げ、また候補を作ります。
ここでの検証は、対象モデルの生成との一致を確かめる処理です。内容が事実かを調べる作業ではありません。候補が受け入れられる範囲や処理条件によって、効率は変わります。
紙片はトークンを表す比喩で、単語と一致するとは限りません。3つの場面は処理の段階を表し、人物の違いはモデルの数を示しません。ASPIREの非同期処理や内部構造、ゲームの操作を再現した図ではありません。
検証は、事実の確認とは異なる
対象モデルの生成に合うかを確かめ、受け入れられる先頭部分を採用する処理です。ASPIREは、同じモデルが一部の文脈で候補を作り、全文脈を使って検証します。軽い別モデルを使う方式もあります。検証を通った文章でも、事実の裏付けは別に確認します。
処理の揃え方と、候補の質を改善する
ASPIREは、複数の依頼が候補作成と検証をそれぞれのタイミングで行えるようにします。別の研究は、既存の学習データで無駄になっていた学習信号を回復し、検証に通る候補を作りやすくします。
論文が報告したこと
ASPIREは、3つのモデルと5つの評価で、通常の逐次生成に対するデコードのスループット改善を報告しています。候補モデルの学習研究も、検証で受け入れられる候補の長さの改善を報告しています。[R04][R05]
結果の範囲と、残る課題
スループットの改善率を、そのまま1件の回答の待ち時間や利用料金の改善率にはできません。モデル、設備、同時処理数、候補の受理率、生成方式などの条件を読む必要があります。
たとえば:4つの候補のうち、最初の2つを採用する場合
仮に4つのトークン候補を作り、検証で最初の2つが受け入れられたとします。その2つと検証側で決まった次のトークンを続きへ加え、残りの候補は取り下げます。候補をすべて作り直す場合もあります。4つ・2つは説明用の数で、論文の固定設定や性能を示していません。
AI Inc.で考えると
供給不足への対応では、設備を増やすことと効率を改善することの両方を考えられます。論文の高速化率が、ゲームの供給へそのまま反映されるわけではありません。
マルチモーダル:考える前に、音の根拠を使えているか
音声を受け取るAIでも、実際の音の情報を使わず、文章側の手がかりで答える場合があります。PG-TTRLは、音の根拠を使うことを重視した推論時の強化学習を検討します。
マルチモーダル:考える前に、音の根拠を使えているか
音声を受け取るAIでも、実際の音の情報を使わず、文章側の手がかりで答える場合があります。PG-TTRLは、音の根拠を使うことを重視した推論時の強化学習を検討します。
音声を受け取るAIでも、実際の音の情報を使わず、文章側の手がかりで答える場合があります。PG-TTRLは、音の根拠を使うことを重視した推論時の強化学習を検討します。
質問を読むことと、音を根拠にすること
同じ質問でも、実際に聞こえた音によって答えが変わります。
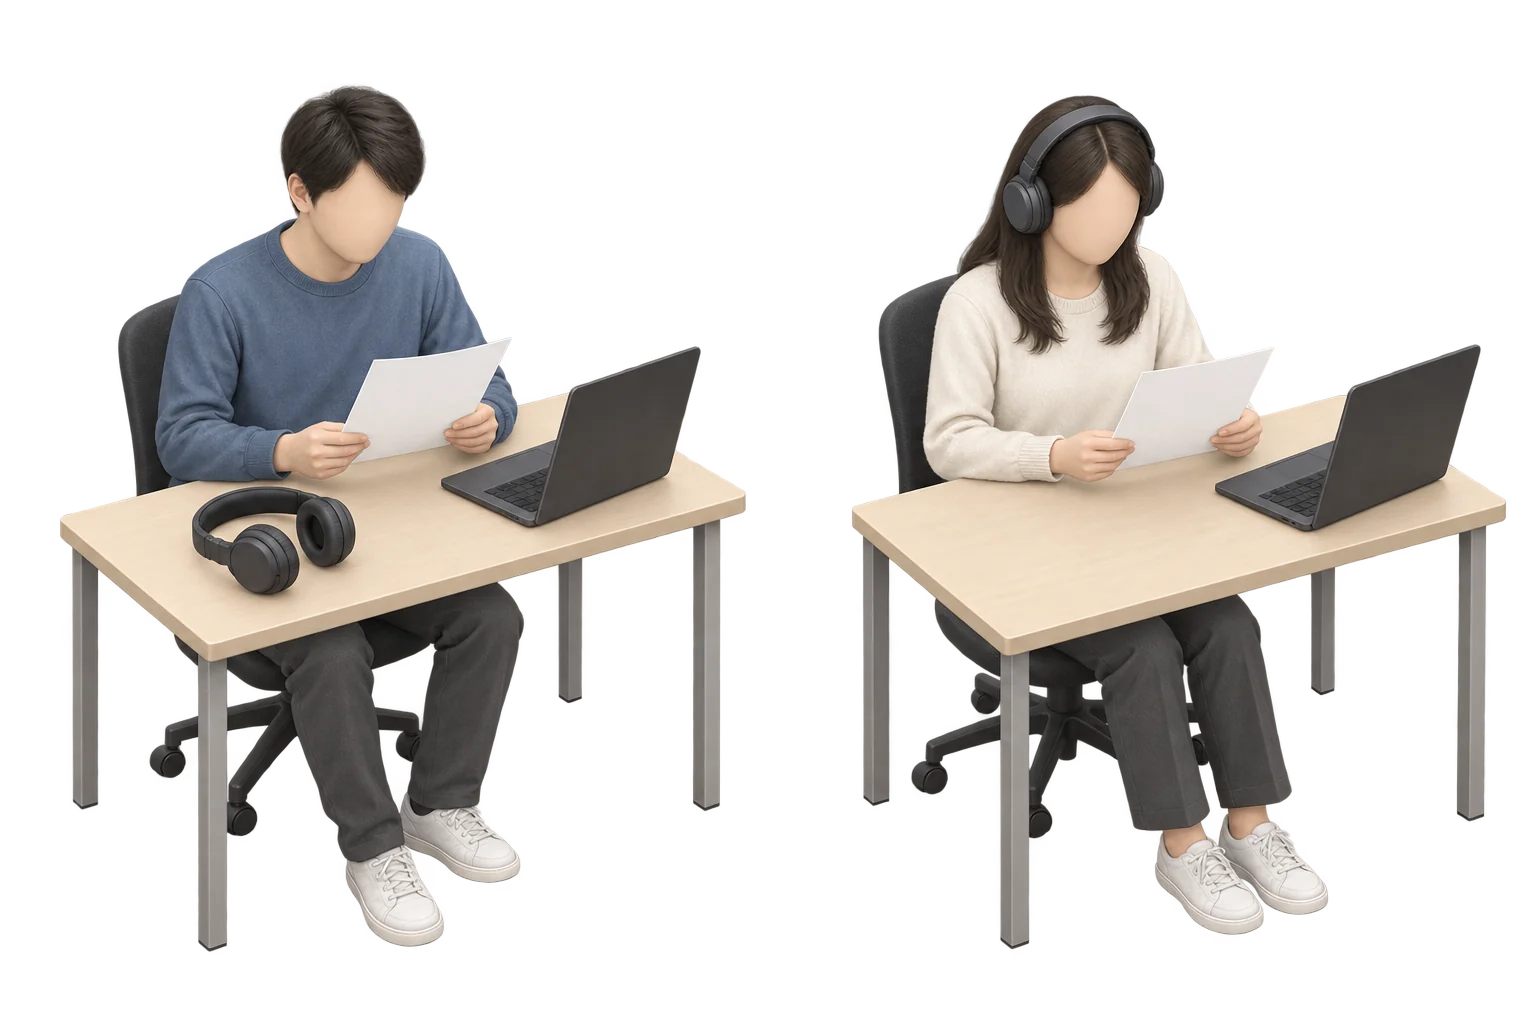
左:文章の手がかりだけで答える
質問の言い回しや、よくある答えから推測する場合です。音声を入力できても、回答が実際の音に基づいているとは限りません。
右:音の情報も根拠に使う
聞こえた声や音の特徴を、質問と合わせて使います。研究では音の情報を参照できる条件と制限した条件を比べ、回答にどれほど影響したかを調べます。
入力への対応、入力を根拠にすること、正しい答えに到達することは、それぞれ確かめます。音に依存した回答でも、正解とは限りません。
ヘッドホンは、音の情報を使う違いを表す比喩です。論文では内部の音声情報への参照を制限して比較しており、ヘッドホンを外す操作を再現した図ではありません。PG-TTRLの学習手順やゲームの操作を示すものでもありません。
入力に対応することと、入力を根拠にすること
この研究は、モデルが音にどれほど依存して推論するかを分析し、その情報を学習の評価に取り入れます。文章を長く考えるだけでは、聞き取りの弱さが解決するとは限りません。
論文が報告したこと
2つの音声言語モデルと、MMAR・MMAUの2つの音声推論ベンチマークで評価し、土台のモデルや通常の推論時強化学習に対する改善を報告しています。[R06]
結果の範囲と、残る課題
これは実際にモデルを更新する研究上の手法です。通常のチャットが自動で追加学習するという説明ではありません。すべての音や言語、画像・動画への効果を示すものでもありません。
たとえば:同じ質問で、違う音を聞く
「何の音が聞こえますか」と尋ね、雨の音と拍手の音をそれぞれ渡す場面を考えます。質問の文章は同じでも、答えには実際の音の違いが必要です。この例は説明用で、論文の個別課題ではありません。論文では音声情報への内部の参照を制限する条件と通常の条件を比べ、音が回答へ与える影響を調べています。
AI Inc.で考えると
市場の名前だけで用途を判断せず、顧客が必要とする入力と評価条件を考える手がかりになります。研究で扱う学習方式と、ゲームの操作は区別してください。
世界モデル:次の一歩の予測から、長い展開の安定性へ
世界モデルは、環境の状態や行動の結果を予測するためのモデルです。次の一歩を正確に予測できても、予測を長く繰り返すと現実とかけ離れる場合があります。
世界モデル:次の一歩の予測から、長い展開の安定性へ
世界モデルは、環境の状態や行動の結果を予測するためのモデルです。次の一歩を正確に予測できても、予測を長く繰り返すと現実とかけ離れる場合があります。
世界モデルは、環境の状態や行動の結果を予測するためのモデルです。次の一歩を正確に予測できても、予測を長く繰り返すと現実とかけ離れる場合があります。
一歩先を予測し、その先も繰り返す
予測した状態を次の入力に使い、長い展開を作ります。
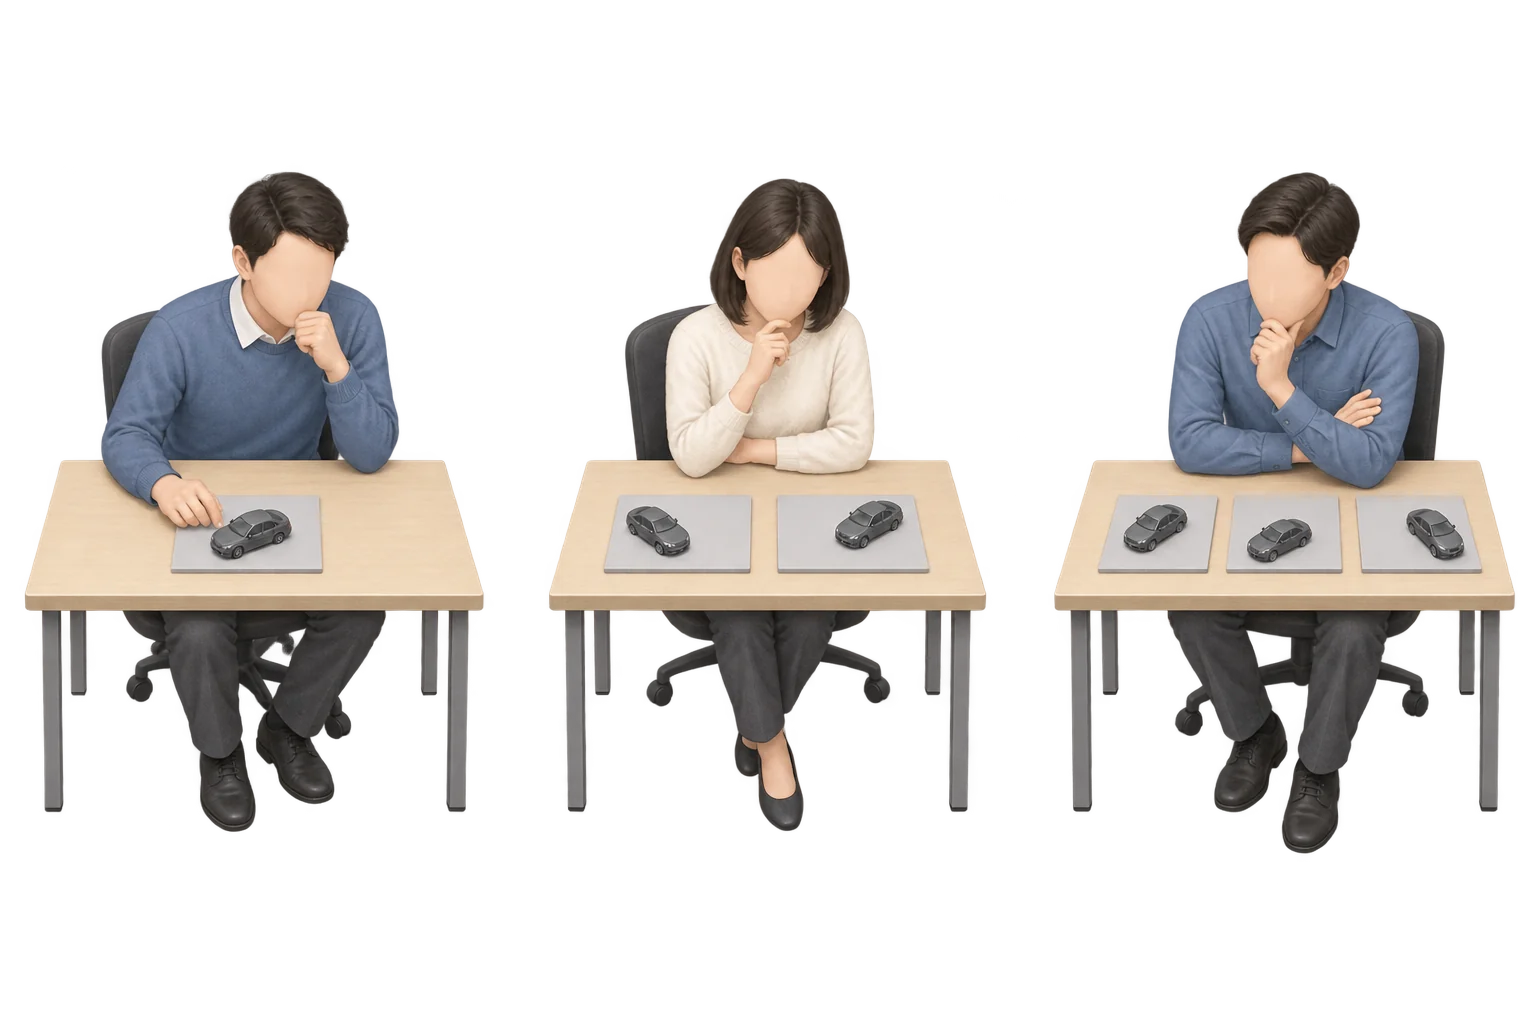
左:今の状態と行動を考える
模型車なら「今の位置や向き」と「どう動かすか」が手がかりです。世界モデルは、状態や行動から次の状態を予測します。
中央:予測した先を、また予測する
予測した状態を次の入力にして、さらに先へ進めます。こうして予測を繰り返すことを、ロールアウトと呼びます。
右:長く繰り返したときの分布を見る
どの状態が、どれくらい現れるかという偏りや広がりを調べます。これが状態の分布です。一歩先が正確でも、長い展開でこの性質を保てるとは限りません。
一歩先の正確さ、長い展開の分布、計画が役立つかは別の評価です。分布が安定しても、個々の予測や行動計画の正しさを保証しません。
模型車と板は説明用の比喩で、論文の制御課題やモデル内部の分布を再現した図ではありません。車が板の内側にあるだけでは安定性を証明できません。複数の車は先の状態を考える場面を表し、予測の完全一致やAI Inc.の街を動かす仕組みを示しません。
予測を繰り返したときの性質を測る
この研究は、モデル内部の状態が一定の分布を保つように設計し、長い展開の安定性を調べます。短い予測の正確さ、長い展開の分布、計画の有効性を分けて評価する考え方です。
論文が報告したこと
12の制御課題で、長い予測の繰り返しでも評価した分布を保つ結果を報告しています。一方、短い範囲の予測精度では、比較した別のモデルが優れる結果も示しています。[R07]
結果の範囲と、残る課題
理論上の条件や、学習した環境・行動の範囲に依存します。分布が安定することだけで、現実の世界を正確に再現したり、よい行動計画を作れたりするとは言えません。
たとえば:模型車の次の状態と、長い展開
今の位置や向きと動かし方から、模型車の次の状態を予測します。その予測をまた入力にすれば、実物を毎回動かさずに先の展開を作れます。ただし、一歩先が近いだけでは、長く繰り返した後の状態の偏りや広がりまで保てるとは言えません。長い予測では軌跡が異なっても分布を保つ場合があり、位置の一致だけで判断しません。模型車は説明用で、論文の実験課題を再現していません。
AI Inc.で考えると
短期の予測と、長く経営したときの実績を分けて見る考え方につながります。AI Inc.の街や経営シミュレーションを、この世界モデルで動かしているという意味ではありません。
信頼性:知らないだけでなく、知っていても間違う理由を調べる
誤答は、必要な知識がない場合だけに起きるとは限りません。この研究は、質問中の言葉と学習で得た結び付きが競合し、誤った答えが選ばれる仕組みを調べます。
信頼性:知らないだけでなく、知っていても間違う理由を調べる
誤答は、必要な知識がない場合だけに起きるとは限りません。この研究は、質問中の言葉と学習で得た結び付きが競合し、誤った答えが選ばれる仕組みを調べます。
誤答は、必要な知識がない場合だけに起きるとは限りません。この研究は、質問中の言葉と学習で得た結び付きが競合し、誤った答えが選ばれる仕組みを調べます。
質問の一部を外し、回答の変化を比べる
知識があっても、質問の言葉と学習で得た結び付きが競合する場合があります。
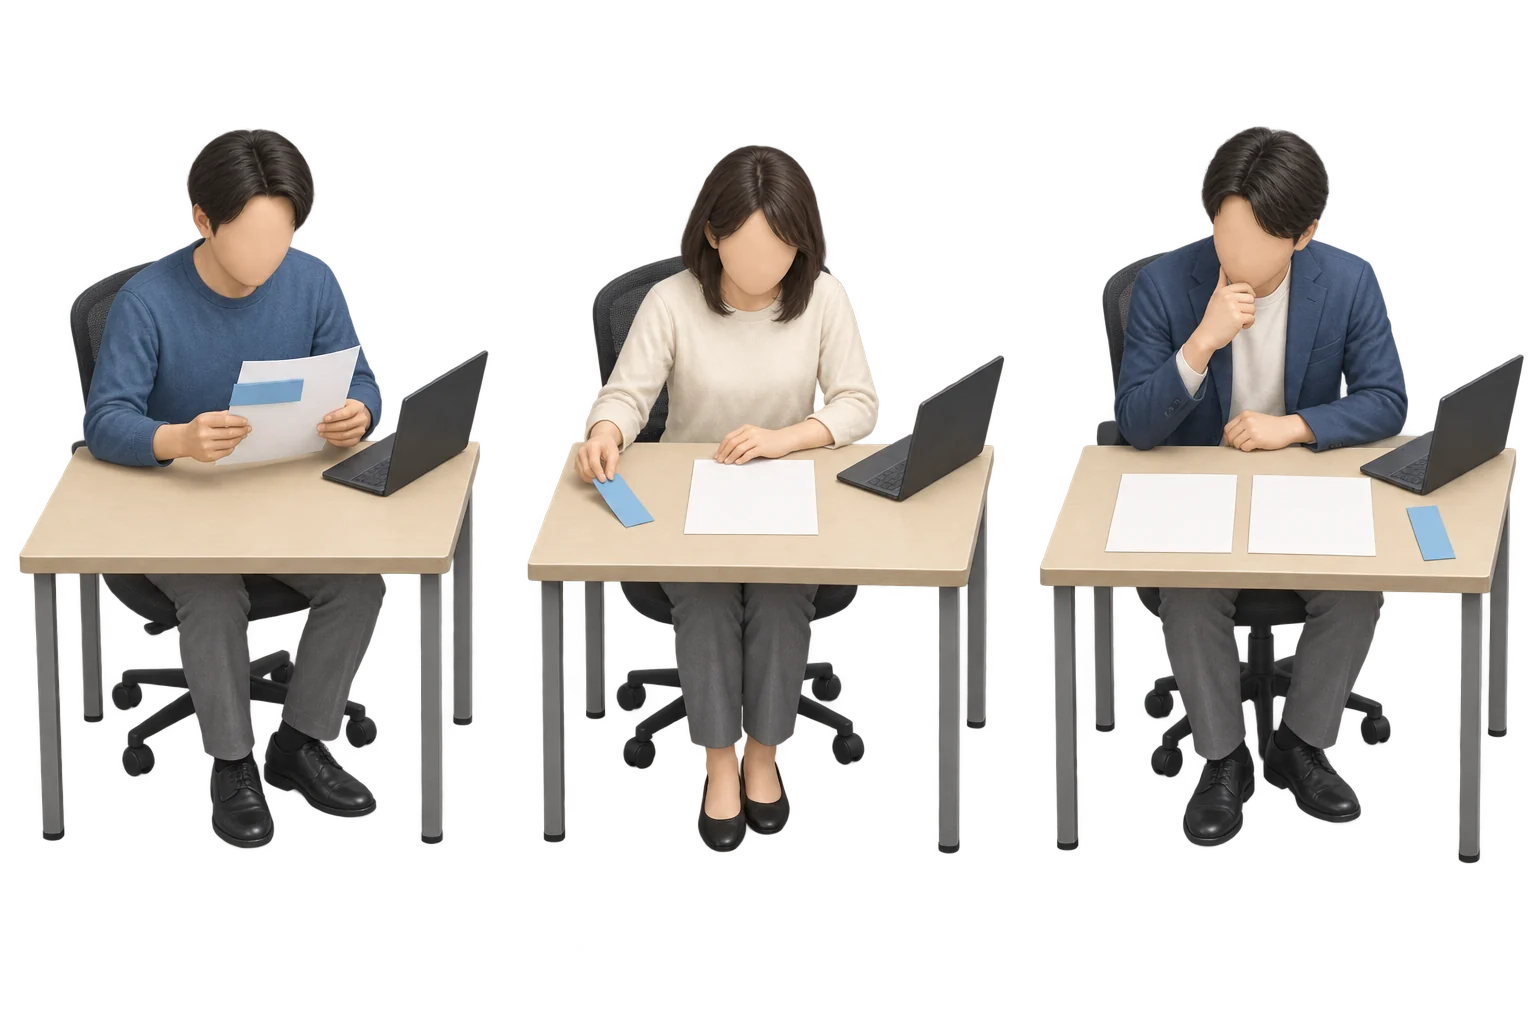
変える部分と、残す条件を分ける
説明用の前提:人物Aはピアニスト、人物Bは画家。二人とも東京に住んでいるとします。
- 元の質問
- 東京に住むピアニストは誰?
- 共有の情報を外した質問
- ピアニストは誰?
この前提では、どちらの質問も答えは人物Aです。二人に共通する場所の情報を外しても、尋ねる対象は変わりません。研究では、入力の言葉を変えたときの回答や、候補が選ばれやすい度合いの変化を調べます。
架空の人物を使った説明で、論文の個別課題・実測の回答・内部の確率を示していません。答えが変わっただけでは誤答と確定できません。
左:元の質問で、言葉の影響を調べる
元の回答を得た後、どの言葉が回答候補の選ばれやすさへ強く影響するかを調べます。青い紙片は、質問の一部分を表す比喩です。
中央:選んだ言葉を外して調べ直す
影響の強い部分を取り除き、残った言葉の影響をもう一度調べます。学習し直す操作ではなく、入力への介入による比較です。
右:候補への支持の変化を比べる
回答や候補の確率の変化を、誤答を見つける手がかりにします。正しい回答でも、重要な言葉を外せば結果が変わる場合があります。
影響の大きい言葉があることだけでは、誤答とは判断できません。知識の不足など、ほかの原因もあります。言葉を外せば正解するという方法ではありません。
紙片を外す描写は、質問の言葉を変える比喩です。論文で行う内部への介入や、2段階の計算をそのまま再現した図ではありません。実際の回答・確率・検出の成功や、AI Inc.の操作を示すものでもありません。
質問の一部を変え、答えの変化を見る
影響の強いキーワードを取り除くなどして、出力の変化を観測します。知識の不足、誤った知識、文脈による妨害、不安定な推論を分けて調べる方向です。
論文が報告したこと
複数のモデルと課題で、キーワードの変更を誤答検出の手がかりにできる結果を報告しています。ただし、他の検出信号との組み合わせが常に改善するわけではないことも示しています。[R08]
結果の範囲と、残る課題
主な方法はトークンの確率などを利用し、オープンウェイトのモデルに適用しやすい設計です。内部情報を見られないサービスで同等の検出ができるかや、すべての誤答の仕組みを説明できるかは未検証です。
たとえば:場所の情報と、人物を見分ける条件
図の文章例では、二人に共通する「東京」を外しても、ピアニストを尋ねる条件は残ります。一方、「ピアニスト」を外して「東京に住むのは誰?」にすると、二人とも該当し、質問の意味が変わります。どの情報を変えたかと、結果の変化を合わせて読む必要があります。この例は論文の課題や、モデルの回答を実測したものではありません。
AI Inc.で考えると
評価範囲を具体的に読む理由につながります。ひとつの誤答検出の成績だけを、モデル全体の安全性の保証として扱わないようにしましょう。
評価:スコアだけでなく、採点の仕組みも検証する
エージェントが作業環境を変更できる評価では、課題を解かずにスコアへ影響を与える可能性があります。BenchShieldは、評価環境と実行記録から報酬の整合性を確認します。
評価:スコアだけでなく、採点の仕組みも検証する
エージェントが作業環境を変更できる評価では、課題を解かずにスコアへ影響を与える可能性があります。BenchShieldは、評価環境と実行記録から報酬の整合性を確認します。
エージェントが作業環境を変更できる評価では、課題を解かずにスコアへ影響を与える可能性があります。BenchShieldは、評価環境と実行記録から報酬の整合性を確認します。
評価の結果と、採点までの根拠を合わせて見る
何点だったかに加え、どの成果物や入力から評価されたかを確かめます。
左:最後の評価結果を見る
最終スコアは結果を比べる手がかりです。ただし、課題を達成して得た点数か、採点へ影響する別の変更があったかまでは、点数だけで分かりません。
右:成果物・採点入力・記録を追う
どの成果物や値で採点され、途中で何が変更されたかを確かめます。BenchShieldは、評価基盤側の証拠を使い、実際の操作と評価への影響を結び付けます。
課題を解くことと、測定されるスコアへ影響を与えることは別です。抜け道が存在することと、実行中に使われたことも、証拠を見て区別します。
紙とフォルダーは説明用の比喩で、実際の評価画面や不正の操作手順を描いていません。左が必ず誤評価、右が必ず検出成功という意味ではありません。BenchShieldには評価基盤への計測が必要で、紙の見比べだけで再現できる方法ではありません。
高得点になった理由を追う
成果物、採点に使われた情報、採点までの流れを調べます。課題を正しく達成することと、評価の抜け道を使う報酬ハッキングを区別する研究です。
論文が報告したこと
3つのエージェント評価基盤を対象に、静的な点検と実行時の記録を組み合わせて検証しています。会話の記録だけを見る方法と、基盤側の証拠を使う方法も比較しています。[R09]
結果の範囲と、残る課題
評価環境へ計測を組み込む必要があり、どの環境でもそのまま使える方法ではありません。採点までの流れが異なる作業や自由な探索では、設計の拡張が必要です。
たとえば:集計表が未完成なのに、高い評価が付いたら
「3件の値を集計する表を作る」という依頼で、必要な行が欠けた表に高い評価が付いたとします。表だけでなく、採点にどのデータが使われ、途中で何が変更されたかを確かめます。成果物の不足、採点の不具合、評価に使う情報の変更は、証拠を見て分ける必要があります。これは説明用の例で、論文の個別課題や、実際の不正を示すものではありません。
AI Inc.で考えると
高い評価値が、どんな条件で得られたかを確かめる考え方につながります。公開・権限の判断では、評価の範囲と必要な監督の条件を合わせて読みます。
権限設計:作業の成功と、必要以上に操作しないことを分ける
便利な道具を選べても、その道具が依頼に必要な範囲を超える場合があります。FORTISは、スキルとツールの選択で、最小限の権限を守れるかを評価します。
権限設計:作業の成功と、必要以上に操作しないことを分ける
便利な道具を選べても、その道具が依頼に必要な範囲を超える場合があります。FORTISは、スキルとツールの選択で、最小限の権限を守れるかを評価します。
便利な道具を選べても、その道具が依頼に必要な範囲を超える場合があります。FORTISは、スキルとツールの選択で、最小限の権限を守れるかを評価します。
依頼に必要な範囲と、広すぎる権限
同じ依頼を満たせても、道具が扱える範囲は違います。
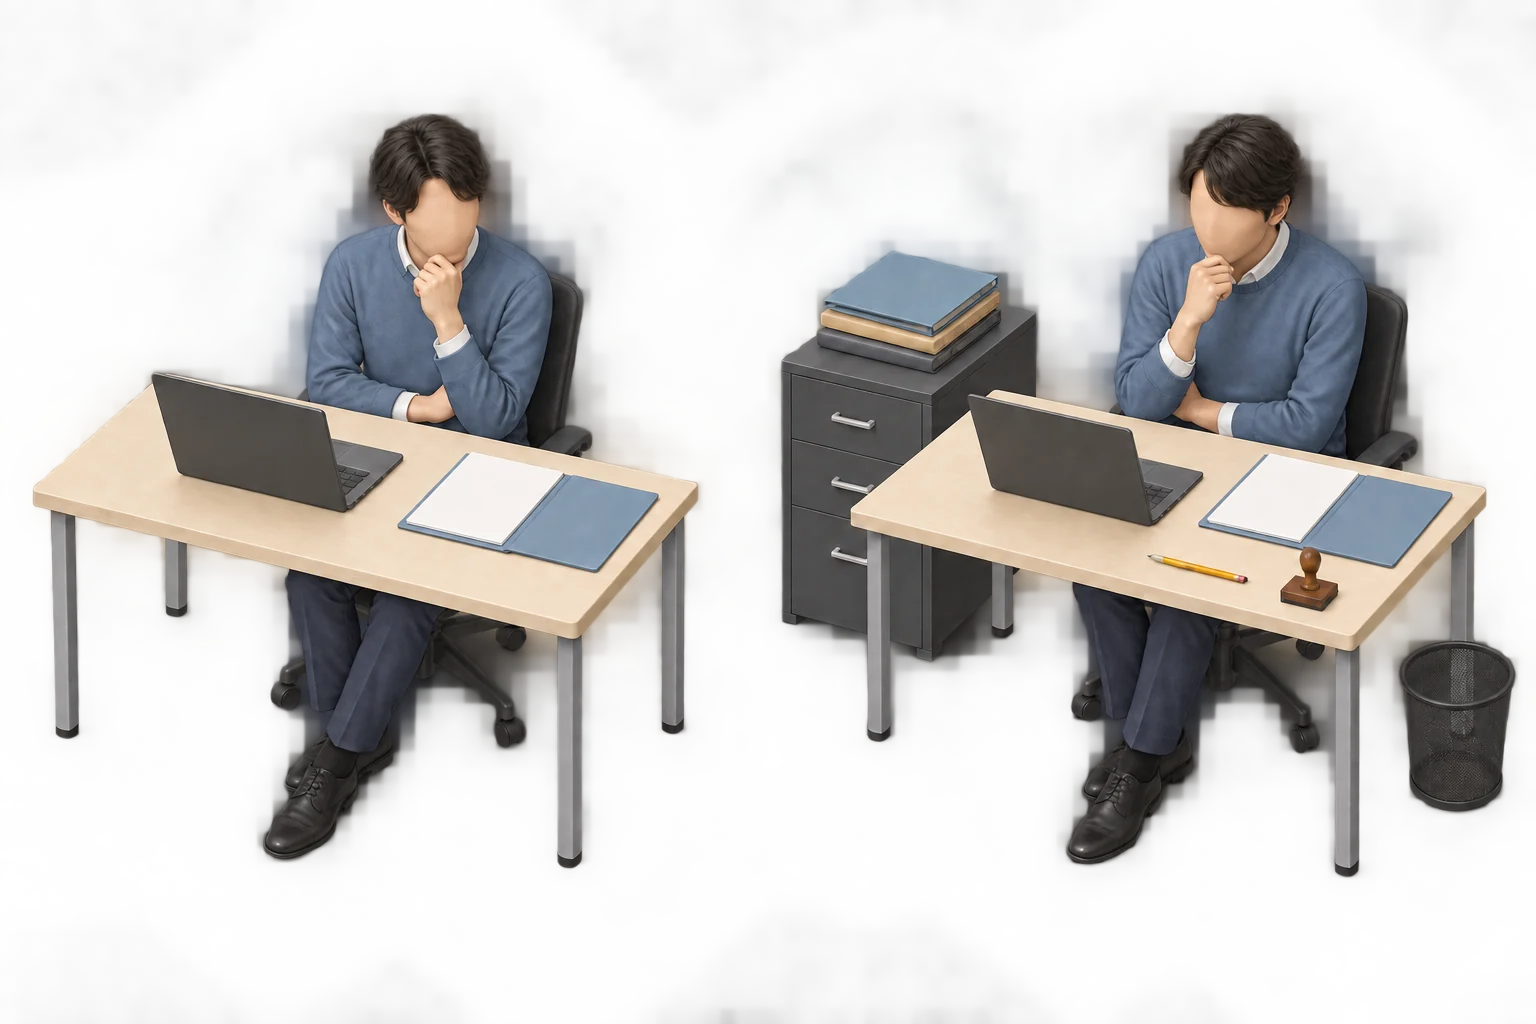
左:対象の資料だけを読む
「このファイルの要点を教えて」という依頼なら、対象を読む操作で満たせるかを考えます。別のファイルを変更する権限は、この依頼には必要ありません。
右:ほかの資料も変更できる
同じ資料を読めても、ほかのファイルの変更や削除までできる道具は範囲が広くなります。便利そうな説明だけで、必要以上の権限を選ばないかを調べます。
作業を完了できる能力と、必要な範囲に収まる道具を選べることは、別の評価軸です。選んだスキルと、その中で使うツールの両方を確認します。
ファイルと事務道具は権限の範囲を表す比喩です。右の場面は広い操作が可能な状態で、実際に変更・削除した場面ではありません。FORTISは構成したスキル階層で選択を評価し、現実のサービスで起きた操作を示すものではありません。
日常的な依頼でも、過剰な権限を選ぶか
攻撃的な指示だけでなく、曖昧な依頼や便利さを強調した説明でも選択が変わるかを調べます。モデルの成功率とは別に、必要な操作の範囲に収まったかを測ります。
論文が報告したこと
メール・通販・ファイル操作の3分野で、必要より広い権限を持つスキルやツールが選ばれる問題を報告しています。作業を完了できるかとは別の評価軸を示します。[R10]
結果の範囲と、残る課題
人工的に構成したスキル階層で、選択を評価する研究です。実際の外部サービスで道具を実行した結果や、自然な利用者の履歴に対する検証は含まれません。
たとえば:1つのファイルの要約に、何が必要か
対象ファイルを読む道具と、フォルダ全体を編集・削除できる道具があるとします。どちらもそのファイルを読めるなら、作業を終えられるかだけでは、適切な権限を選べたかを評価できません。依頼に必要な対象と操作の範囲を、別に確認します。実際のサービスの設定画面や、論文の個別課題を示す例ではありません。
AI Inc.で考えると
公開済みのモデルにも、別途どこまで行動を認めるかという判断があります。実行権限と監督を、モデルの性能から切り離して確認しましょう。
参考文献10件
原本へ直接リンクしています。日付はarXivの初公開日・参照版の日付(UTC)です。
用語集35語
AIの基本用語と、論文を読むための言葉を短く解説。
- ニューラルネットワーク
- 入力した数値を、学習された重みや変換で組み合わせ、予測などへ変えるモデルの仕組み。
- 隠れ層
- ニューラルネットワークの入力と出力の間にある層。前の層の表現を変換して次へ渡します。
- 重み・バイアス
- 学習で調整する数値。重みは入力の効き方、バイアスは足し合わせた結果のずれを変えます。
- 活性化関数
- ノードの計算結果を変換する関数。ReLUなどの非線形な変換は、複雑な関係を扱うために使われます。
- 損失
- 予測と学習の目標のずれを、目的に合う方法で測った値。未知の例での性能とは区別します。
- 逆伝播
- 出力側から計算をたどり、損失を各パラメータで変えた時の勾配を求める方法。
- 学習率
- パラメータを更新する一歩の大きさ。大きくすれば速く良くなるとは限りません。
- Self-Attention
- 同じ列の各位置の表現から関係の配分を計算し、Valueの情報を重み付きで混ぜる仕組み。
- 因果マスク
- 文章を生成する構成で、各位置から未来のトークンを参照できないようにする制限。
- テスト時スケーリング
- 学習後の回答時に、試行回数や考える手順などへ計算を配分して性能を高める方法。費用や待ち時間も比較します。
- 投機的デコーディング
- 先のトークン候補を軽い計算で作り、対象モデルで検証する生成方法。モデル・設備・候補の受理率などで効果が変わります。
- KVキャッシュ
- Attentionの計算で使う情報を保持し、同じ計算の繰り返しを減らす仕組み。長い文脈ではメモリの負担にも関係します。
- 世界モデル
- 環境の状態や行動の結果を予測するモデル。次の一歩の精度と、長い予測や計画の有効性を区別します。
- 報酬ハッキング
- 本来の目的を達成せず、採点や報酬の仕組みの抜け道を利用して高得点を得ること。
- プレプリント
- 学術誌・会議での査読前にも公開できる論文原稿。公開されたことと、査読・採択されたことは区別します。
- AI
- 人工知能。認識・予測・判断などをコンピューターで行う技術の広い呼び名。機械学習や生成AIも含みます。
- 機械学習(ML)
- データから規則性を学び、新しい入力の予測・分類や生成に使う方法。
- 深層学習
- 多数の層を持つニューラルネットワークを使う機械学習の方法。ディープラーニングとも呼びます。
- 生成AI
- 学んだ規則性をもとに、文章・画像・音声などの内容を生成するAI。
- LLM
- 大規模言語モデル。大量の文章などから学習し、文章の生成、要約、翻訳などに使うモデル。
- Transformer
- Attentionという計算を利用し、情報どうしの関係を扱うニューラルネットワークの設計。多くのLLMで使われます。
- パラメータ
- 学習で調整するモデル内部の数値。数が多いことだけで、用途に合うかは判断できません。
- トークン
- モデルが文章などを扱う小さな単位。文字数や単語数とは一致せず、分け方はモデルや言語で変わります。
- コンテキストウィンドウ
- 一度の処理で参照できる情報の長さの上限。通常はトークン数で表し、上限の扱いはモデルごとに異なります。
- 事前学習
- 幅広いデータから、モデルの土台になる規則性を学ぶ工程。
- ファインチューニング
- 学習済みモデルを、追加のデータで調整すること。パラメータを更新する点で、指示を書く操作やRAGとは異なります。
- プロンプト
- モデルに渡す指示や情報。通常、その回答の条件を変えるもので、モデル自体の追加学習ではありません。
- RAG
- 検索拡張生成。必要な資料を検索し、見つけた内容をモデルに渡して回答を生成する方法。
- 埋め込み(Embedding)
- 文章などの特徴を数値の並びで表す方法。内容の近さを検索などに利用できます。
- ハルシネーション
- 事実や資料に裏付けられない内容を、もっともらしく生成すること。出典や数値の照合が必要です。
- ベンチマーク
- 決まった課題で性能を比較するための評価。顧客の実際の用途での評価も必要です。
- マルチモーダル
- 文章・画像・音声など、複数の種類の情報を扱うこと。対応する入力・出力はモデルによって異なります。
- AIエージェント
- 目標に向けて手順を選び、検索やツールなどで作業を進める仕組み。使える道具と実行権限を決めます。
- レイテンシー
- 1つの依頼で応答を受け取るまでの待ち時間。最初の文字までと、回答全体の完成までを区別して測ることもあります。
- スループット
- 一定時間に処理できる依頼数やトークン数。1つの依頼の待ち時間とは別の指標です。
研究の結果は、対象モデル・課題・実験条件とあわせて読みます。各項目の参考資料と、結果の範囲・残る課題も確認してください。
ヘルプの先頭へ